인코더-디코더: 입력을 읽고 다음 토큰을 만드는 과정
인코더의 입력 표현, 디코더의 다음 토큰 생성, cross-attention의 Q·K·V를 작은 계산 예시와 함께 설명한다.
번역 모델이 “I run”을 읽고 “나는 달린다”를 내놓는다고 하자. 입력의 각 단어를 한국어 단어로 바꾸기만 하면 될 것 같지만, 실제 문장에서는 어순이 바뀌고 필요한 단어 수도 달라진다. 모델은 입력에서 필요한 정보를 남겨 두고, 그것을 참고하면서 출력 문장을 만들어야 한다.
인코더-디코더는 이 두 역할을 나눈 구조다. 이 글에서는 입력을 읽는다는 말이 어떤 계산을 뜻하는지부터 시작해, 디코더가 입력의 어느 부분을 참고하고 어떻게 다음 토큰을 내놓는지까지 따라간다. 예시는 설명을 위해 단순화한 것이며, 특정 번역 모델의 실제 출력이나 내부 값을 나타내지 않는다.
0. 인코더와 디코더는 각각 무엇을 하는가
인코더는 입력을 이후 계산에 사용할 숫자 표현으로 바꾸고, 디코더는 그 표현을 참고해 출력을 만든다. 문장처럼 순서가 있는 데이터의 묶음을 시퀀스라고 한다. 입력 시퀀스를 받아 출력 시퀀스를 만드는 문제를 sequence-to-sequence라고 부른다.
여기서 디코더는 인코더가 압축한 파일을 원래대로 복원하는 프로그램이라는 뜻이 아니다. 번역에서는 입력 언어와 다른 언어의 문장을 만들어야 한다. 입력을 조건으로 삼아 출력을 생성한다는 의미에 가깝다. D2L §10.6
모델은 보통 문장을 토큰이라는 처리 단위로 나눈다. 토큰은 단어 전체일 수도 있고 단어의 일부일 수도 있다. 이후 설명에서는 흐름에 집중하기 위해 I, run, 나는, 달린다가 각각 하나의 토큰이라고 가정한다. 실제 토크나이저도 이렇게 나눈다는 뜻은 아니다.
1. 입력을 읽는다는 것은 숫자 표현을 만든다는 뜻이다
먼저 입력 토큰을 숫자 벡터로 바꾼다. 벡터는 여러 숫자를 한 줄로 묶은 것이다. 토큰마다 학습된 벡터를 대응시키는 과정을 embedding이라고 한다. 이때 각 숫자가 반드시 ‘사람’, ‘운동’ 같은 해석 가능한 의미 하나를 담당하는 것은 아니다.
인코더는 이 벡터를 입력 문맥에 맞게 바꾼다. 모델의 층은 입력 벡터에 정해진 연산을 적용해 새 벡터로 바꾸는 계산 단계다. Transformer 인코더라면 self-attention으로 입력 위치 사이의 정보를 주고받는다. run 위치의 표현도 run 하나만 따로 나타내는 것이 아니라 다른 입력 토큰의 영향을 받은 표현이 된다. 이러한 처리를 여러 층에서 반복한다.
결과를 H라고 쓰자. 입력이 두 토큰이면 H에는 각 위치에 대응하는 벡터가 두 개 남는다. 여기서 다루는 Transformer의 인코더 출력은 문장 전체를 숫자 하나나 벡터 하나로 줄인 결과가 아니다. D2L §11.7.1
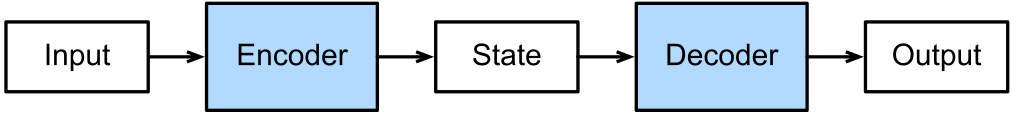
Fig. 1. 인코더-디코더의 기본 구성. State는 두 모듈 사이에 전달되는 표현을 뜻하며, 특정 구현에서 벡터 하나인지 여러 위치의 벡터인지는 별도로 확인해야 한다.출처: D2L §10.6, Fig. 10.6.1. Aston Zhang et al., Dive into Deep Learning, CC BY-SA 4.0. SVG를 PNG로 변환했으며 그림 내용은 변경하지 않았다.
그림은 두 모듈 사이의 큰 흐름을 보여 준다. 디코더가 실제로 받는 두 종류의 입력은 구분해야 한다. 인코더는 번역할 원문 I run을 받는다. 디코더는 출력의 시작을 알리는 특수 토큰과, 지금까지 만든 나는을 받는다. 디코더는 두 정보를 함께 사용해 그다음 토큰을 예측한다.
2. 왜 옛 설명에서는 벡터 하나에 문장을 담는다고 할까
인코더-디코더는 역할을 나누는 큰 틀이고, 내부 구현은 달라질 수 있다. Sutskever 등의 2014년 모델은 LSTM으로 입력을 순서대로 읽고, 고정 차원의 벡터를 통해 다른 LSTM으로 출력 문장을 생성했다. LSTM은 이전 단계의 상태를 이어 받아 순서대로 계산하는 신경망의 한 종류다. 원문 §2
이 방식에서는 입력이 길어져도 디코더에 전달하는 벡터의 차원이 커지는 것은 아니다. 필요한 정보를 고정된 크기에 담아야 한다. Bahdanau 등은 이를 병목으로 보고, 출력의 각 위치에서 입력의 여러 위치 표현을 가중합해 참고하는 방식을 제시했다. 원문 §1·3
따라서 ‘벡터 하나에 요약한 뒤 생성한다’는 설명과 ‘입력 위치별 벡터를 참고한다’는 설명은 서로 다른 구성을 가리킬 수 있다. Transformer의 구조를 이해할 때는 후자를 떠올리는 편이 맞다.
3. 디코더는 입력에서 무엇을 가져오는가
“나는”까지 생성한 상황으로 돌아가 보자. 디코더는 다음 토큰을 만들기 위해 두 종류의 문맥이 필요하다. 지금까지 출력한 내용과, 번역할 원문의 내용이다.
출력 쪽 문맥은 masked self-attention으로 처리한다. 각 출력 위치는 자기 위치와 앞선 위치를 참고할 수 있지만, 그 위치에서 예측해야 하는 정답이나 그 뒤의 토큰을 미리 볼 수는 없다. 학습 때에는 출력 입력을 정답보다 한 칸 뒤로 밀고, 마스크로 미래 위치를 가린다.
이어서 cross-attention이 인코더 출력을 참고한다. 이 연산에서 Q는 디코더 쪽 표현에서 만들고, K와 V는 인코더 출력에서 만든다. Q는 query, K는 key, V는 value를 뜻한다. D2L §11.7.1
이를 자료를 찾는 일에 비유하면, query는 지금 찾을 정보의 기준이고 key는 각 자료를 비교할 기준, value는 비교 결과에 따라 가져올 내용이다. query와 각 key를 비교해 가중치를 얻고, 그 가중치만큼 value를 섞는다. 여러 자료를 조금씩 함께 가져올 수 있다는 점에서 정확히 일치하는 항목 하나를 찾는 검색과 다르다. D2L §11.1
실제 query는 사람이 쓴 질문 문장이 아니다. 행렬은 숫자를 행과 열로 배열한 것이고, 벡터에 행렬을 곱하면 학습된 규칙에 따라 다른 벡터로 바꿀 수 있다. Q·K·V 모두 학습된 행렬을 곱해 얻는 숫자 벡터다. 같은 인코더 출력에서도 key를 만드는 변환과 value를 만드는 변환이 다르므로, key와 value는 역할과 값이 다를 수 있다. Vaswani et al., §3.2.2
여기서는 cross-attention을 인코더와 디코더를 잇는 용도로 설명한다. self-attention과 cross-attention의 구분은 query와 key·value가 같은 시퀀스에서 오는지, 서로 다른 시퀀스에서 오는지에 있다.
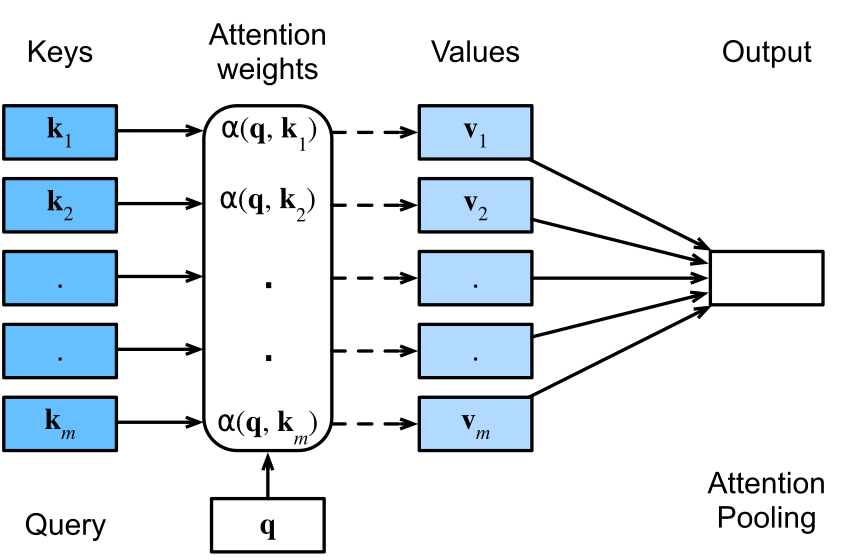
Fig. 2. 아래에서 들어오는 query가 왼쪽 key들과 비교돼 가중치를 만들고, 가운데 value들을 그 비율로 섞어 오른쪽 출력을 만든다.출처: D2L §11.1, Fig. 11.1.1. Aston Zhang et al., Dive into Deep Learning, CC BY-SA 4.0. SVG를 PNG로 변환했으며 그림 내용은 변경하지 않았다.
그림에서는 가중치를 α로 표시한다. 각 가중치는 query와 해당 key의 관계로 정해지고, 그 가중치가 곱해지는 대상은 value다. 본문의 두 입력 토큰 예시에서는 이 그림의 key와 value 쌍이 두 개 있다고 생각하면 된다.
4. 작은 숫자로 attention을 계산해 보자
다음은 입력 두 토큰을 참고하는 attention 한 개만 떼어 낸 가상 예시다. 벡터의 숫자는 설명을 위해 정했으며 실제 단어의 의미 좌표가 아니다. 모델이 실제로 run에 아래 비율의 가중치를 준다는 뜻도 아니다.
디코더의 query를 q = (1, 0)이라고 하자. 입력 I에 대응하는 key는 (0, 1), value는 (0, 4)이고, run에 대응하는 key는 (1, 0), value는 (2, 0)이라고 두자. key와 query의 차원은 2다.
먼저 query와 각 key의 내적을 구한다. 내적은 같은 위치의 숫자끼리 곱해 더한 값이다. I의 점수는 1×0 + 0×1 = 0이고, run의 점수는 1×1 + 0×0 = 1이다. 이 예시에서는 두 번째 key의 점수가 더 높다.
이 점수들을 √2로 나누면 0과 약 0.7071이 된다. 그다음 softmax를 적용한다. softmax는 각 점수에 지수 함수를 적용한 뒤 전체 합으로 나눠, 양수이고 합이 1인 가중치로 바꾸는 연산이다.
이 가중치로 key가 아니라 value를 섞는다.
결과 c는 이번 query를 기준으로 입력에서 모은 정보다. 입력 첫 위치의 value를 약 33%, 둘째 위치의 value를 약 67% 반영한 것이다. 이 벡터 자체가 한국어 단어나 토큰 확률은 아니다.
여러 query를 한꺼번에 계산하는 일반식은 다음과 같다.
입력 토큰 수를 n, query 수를 m이라고 하자. Q의 크기는 m×d_k, K는 n×d_k, V는 n×d_v다. K를 전치한 Kᵀ와 Q를 곱하면 m×n의 점수 행렬이 된다. 각 query에 해당하는 행마다 softmax를 적용하고 V를 곱하면 결과는 m×d_v가 된다. 앞의 예시는 m=1, n=2, d_k=d_v=2인 경우다. D2L §11.3
d_k는 query와 key의 차원이고 d_v는 value의 차원이다. 서로 비교하는 query와 key의 차원은 같아야 한다. 원 논문은 큰 차원에서 내적의 크기가 커지면 softmax의 기울기가 매우 작아질 수 있다는 이유로 √d_k로 나눈다. 그 설명에서 사용한 성분의 독립성·평균 0·분산 1은 내적의 크기를 분석하기 위한 가정이다. Vaswani et al., §3.2.1의 내적 크기 설명
5. 가져온 정보는 어떻게 다음 토큰이 되는가
attention으로 얻은 정보는 디코더의 다음 계산에 사용된다. Transformer 디코더에는 피드포워드 층도 있고, 층 사이에는 잔차 연결과 정규화가 있다. 피드포워드 층은 각 위치의 벡터를 작은 신경망으로 다시 변환한다. 잔차 연결은 변환 전 입력을 결과에 더하는 경로이고, 정규화는 벡터 값의 크기를 조절하는 연산이다. attention head는 서로 다른 변환을 쓰는 attention 계산 단위이며, 여러 head에서 모은 결과를 합쳐 다시 변환한다. 따라서 attention 한 번의 가중합을 곧바로 최종 출력으로 읽으면 안 된다. D2L §11.7
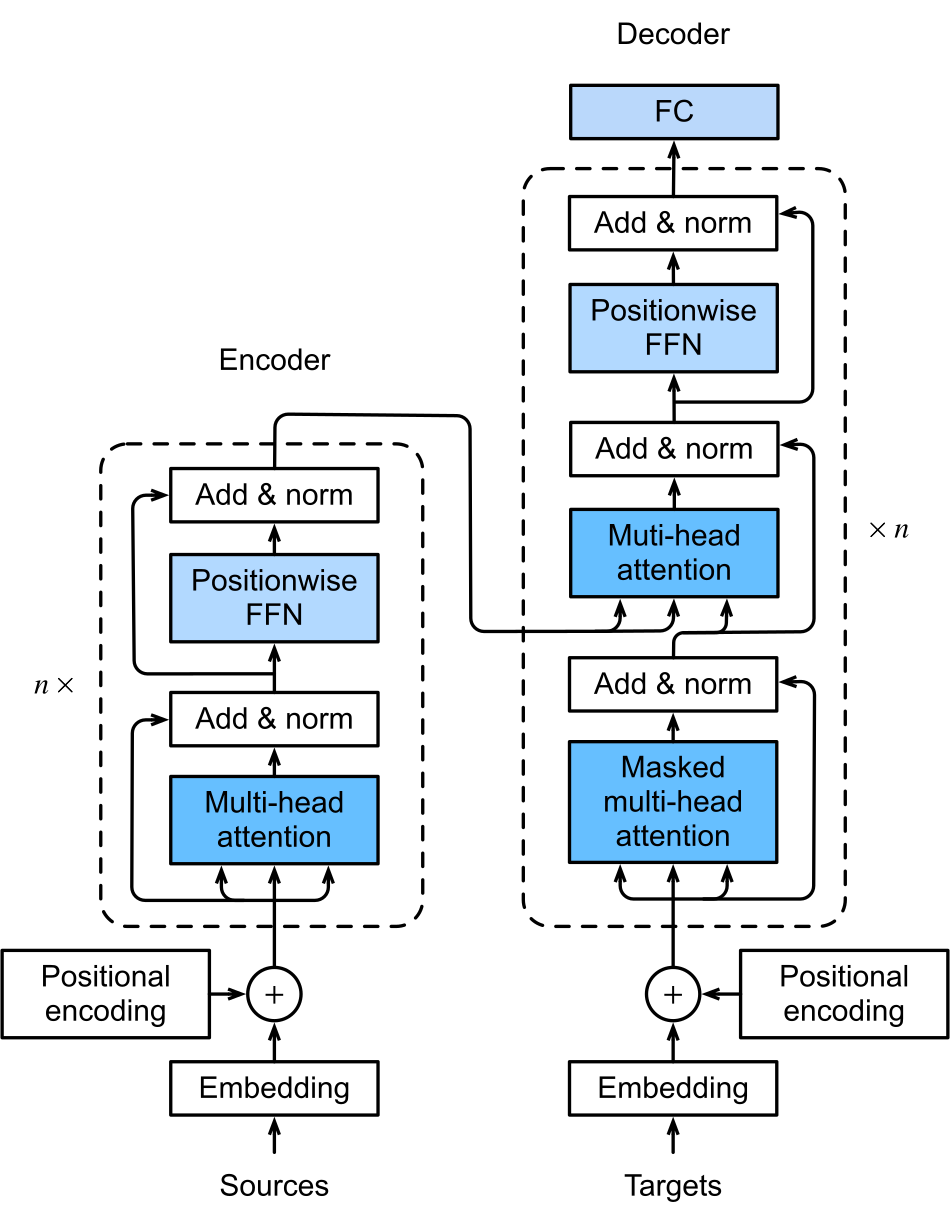
Fig. 3. Transformer의 인코더와 디코더. 왼쪽 인코더의 출력이 오른쪽 디코더 중간의 multi-head attention으로 연결된다.출처: D2L §11.7, Fig. 11.7.1. Aston Zhang et al., Dive into Deep Learning, CC BY-SA 4.0. SVG를 PNG로 변환했으며 그림 내용은 변경하지 않았다.
그림은 아래에서 위로 읽는다. 왼쪽 Sources가 입력 원문이고, 오른쪽 Targets는 학습 때 정답을 한 칸 민 출력 입력이다. 생성 때는 지금까지 만든 출력이 이 자리에 들어간다. 오른쪽 맨 아래 attention은 출력 쪽 문맥을 처리하고, 그 위에서 인코더 출력과 만나는 attention이 cross-attention이다. FFN은 앞에서 설명한 피드포워드 층, Add & norm은 잔차 연결과 정규화를 가리킨다. 점선 블록 옆 n은 층을 반복해 쌓는 횟수이며, 수식에서 입력 토큰 수를 나타낸 n과는 다른 기호다.
마지막 디코더 표현은 어휘에 포함된 토큰마다 점수 하나를 내는 선형 변환을 거친다. 이 점수에 softmax를 적용하면 다음 토큰의 확률 분포가 된다. 앞에서 attention 가중치를 구할 때 쓴 softmax와 연산의 형태는 같지만, 이번에는 입력 위치가 아니라 출력 어휘의 토큰들에 대한 분포다. Vaswani et al., §3.4
설명을 위해 다음 후보가 달린다, 걷는다, 종료 토큰이고 확률이 각각 0.7, 0.2, 0.1이라고 하자. 가장 높은 확률을 고르는 방식이라면 달린다를 선택한다. 다른 생성 방식에서는 확률에 따라 샘플링할 수도 있으므로, 생성 방식이 곧 최댓값 선택을 뜻하지는 않는다.
선택한 토큰을 출력 뒤에 붙이고 다음 예측을 반복한다. 종료 토큰을 선택하거나 정해 둔 최대 생성 길이 같은 종료 조건에 도달하면 멈춘다. 이처럼 앞서 생성한 내용을 조건으로 다음 출력을 만드는 방식을 자기회귀 생성이라고 한다. 일반적인 이 구조에서는 입력이 고정돼 있으면 인코더 출력을 각 생성 단계에서 다시 만들 필요는 없다.
학습에서는 보통 디코더에 정답 출력의 앞부분을 주는 teacher forcing을 사용한다. 예를 들어 디코더 입력이 <시작> 나는 달린다라면 각 위치에서 맞혀야 할 목표는 나는 달린다 <종료>다. 생성할 때는 정답 앞부분을 알 수 없으므로 자신이 선택한 토큰을 이어 붙인다. D2L §10.7.1·10.7.7
6. 헷갈리기 쉬운 세 가지
인코더-디코더는 Transformer와 같은 말인가
인코더-디코더는 두 역할을 나눈 구성이고 Transformer는 그 구성을 구현하는 한 방식이다. RNN 기반 인코더-디코더도 있다. 한편 Transformer 계열에는 인코더만 쓰거나 디코더만 쓰는 모델도 있다. 이름이 비슷해도 같은 범위를 가리키지 않는다.
| 구조 | 주로 참고하는 문맥 | 대표 모델과 활용 |
|---|---|---|
| 인코더 전용 | 주어진 입력 안에서 양쪽 문맥 | BERT: 분류·문장 표현 등 |
| 디코더 전용 | 이어 붙인 시퀀스에서 현재 위치와 앞선 문맥 | GPT 계열: 다음 토큰 생성 |
| 인코더-디코더 | 입력은 인코더로 처리하고, 출력 쪽 앞선 문맥과 인코더 출력을 함께 참고 | T5: 번역·요약 등 text-to-text 작업 |
이 표는 대표적인 구성과 용도를 정리한 것이지 각 구조가 할 수 있는 작업을 제한한 표는 아니다. 디코더 전용 모델도 원문과 번역 요청을 앞에 두고 번역을 생성할 수 있다. 차이는 단순히 출력 길이에 있지 않고, 입력과 출력을 처리하는 경로와 attention을 허용하는 범위에도 있다. Hugging Face의 구조 설명
BERT 원문은 입력의 양쪽 문맥을 사용해 표현을 학습하는 방식을 설명한다. T5 원문은 분류를 포함한 여러 작업을 텍스트 입력과 텍스트 출력으로 바꾸어 다룬다. 따라서 ‘인코더는 이해만 하고 디코더는 생성만 한다’는 말을 모델의 모든 능력을 나누는 기준으로 쓰면 지나친 단순화가 된다. BERT §3, T5 §2
입력을 한 번에 처리하면 단어 순서는 사라지지 않을까
원래 Transformer는 입력 embedding에 위치 정보를 더한다. self-attention이 입력 위치 사이 정보를 주고받는 것과, 어떤 토큰이 앞뒤에 있는지 알려 주는 것은 별개의 역할이다. ‘한 번에 처리한다’는 말이 순서를 무시한다는 뜻은 아니다. D2L §11.6
attention 가중치가 높으면 그 단어가 정답의 이유일까
가중치가 높다는 것은 해당 attention 계산에서 그 위치의 value를 더 많이 반영했다는 뜻이다. 이를 모델의 전체 판단 이유나 사람이 생각하는 단어 중요도와 바로 같다고 보면 안 된다. 여러 head와 층, 뒤따르는 변환을 거쳐 결과가 만들어지기 때문이다. 가중치를 보고 입력을 참고하는 방식을 직관적으로 살펴볼 수는 있지만, 그 해석에는 범위가 있다. D2L §11.1.1
7. 참고 자료
- D2L §10.6, The Encoder–Decoder Architecture. 두 모듈의 역할과 sequence-to-sequence 문제를 설명한다.
- D2L §10.7, Sequence-to-Sequence Learning. teacher forcing과 실제 생성 절차를 확인할 수 있다.
- D2L §11.1, Queries, Keys, and Values. 가중합과 Q·K·V의 역할을 설명한다.
- D2L §11.3, Attention Scoring Functions. 점수 계산과 행렬 형태의 attention 식을 설명한다.
- D2L §11.6, Self-Attention and Positional Encoding. 입력 순서를 반영하는 위치 정보의 역할을 설명한다.
- D2L §11.7, The Transformer Architecture. 인코더·디코더 층 구성과 정보의 출처를 설명한다.
- Sutskever, Vinyals, Le, 2014, Sequence to Sequence Learning with Neural Networks. LSTM 기반 구조의 배경이다.
- Bahdanau, Cho, Bengio, Neural Machine Translation by Jointly Learning to Align and Translate. 2014년 공개된 연구로, 입력 위치를 가중합해 참고하는 방법을 설명한다.
- Vaswani et al., 2017, Attention Is All You Need. attention 식, 디코더 구성, 출력 확률과 위치 정보의 근거다.
- Devlin et al., 2019, BERT. 인코더 전용 모델의 대표 사례다.
- Raffel et al., 2020, Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. T5의 text-to-text 구성과 구조 비교를 확인할 수 있다.
- Hugging Face, Transformer Architectures. 세 가지 대표 구조의 차이를 정리한다.