It's the Problem, Not the Path: Budget and Difficulty Confounds in LLM Reasoning Trajectories
추론 궤적에 대한 주장(돌파 순간·초반 신호 예측)은 같은 문제를 다시 풀었을 때라는 문제 수준 기준선과 비교해야 하며, 그 기준선을 넣으면 대부분 사라진다
LLM이 풀이를 시작한 지 몇 토큰 지나지 않았는데도 정답 여부를 예측할 수 있다면, hidden state에 이미 이번 시도의 성공 가능성이 담겨 있다고 볼 수 있을까? 풀이 중간부터 이어 쓰게 했을 때 정답률이 갑자기 높아지는 현상은 모델이 무언가를 깨달았다는 증거일까? 이 논문은 두 결과를 해석하기 전에 무엇과 비교해야 하는지 묻는다.
첫 번째 질문에는 문제 난이도가, 두 번째 질문에는 주어진 토큰 예산이 영향을 준다. 저자는 초반 예측에 관한 기존 결과와 비슷한 수치를 재구성한 뒤 같은 문제의 시도끼리 비교하고, 풀이 이어쓰기에는 처음부터 다시 푸는 기준선을 추가한다. 추론 궤적을 분석하는 지표가 실제로 무엇을 측정하는지 따져본다는 점이 흥미로워 읽었다.
- 저자: Yigit Utku Bulut. 독립적으로 수행한 연구다.
- 공개: arXiv preprint, 2026년 9월 3일 v1
- 논문: arXiv
- 코드·데이터: bulutyigit/problem-not-path. 분석 결과와 프로토콜 변경 기록을 포함한다.
0. 한 줄 요약
추론 과정의 성공 예측과 돌파 순간을 주장하려면 같은 문제의 다른 시도, 그리고 같은 토큰 예산의 재시작과 비교해야 하며, 이 논문의 실험에서는 그 비교를 추가하자 기존 지표의 해석이 크게 달라졌다.
1. 문제 정의
같은 모델에 같은 문제를 여러 번 풀게 해도 결과는 달라진다. 어떤 문제는 거의 매번 맞히고, 어떤 문제는 대부분 틀린다. 이때 문제별 정답률은 해당 모델에게 그 문제가 얼마나 어려운지 보여주는 지표가 된다.
반면 이번 시도가 성공할지는 별개의 질문이다. 정답률이 높은 문제에서도 틀리는 시도가 있고, 어려운 문제에서도 맞히는 시도가 있다. hidden state로 정답 여부를 예측하는 probe가 추론 과정을 읽었다고 주장하려면, 쉬운 문제와 어려운 문제를 구별하는 것 이상을 보여야 한다.
논문이 다루는 다른 질문은 이른바 돌파 순간이다. 풀이를 여러 지점에서 끊고 이어 쓰게 했을 때, 어느 지점부터 정답률이 높아질 수 있다. 하지만 앞부분에 중요한 아이디어가 들어 있어서인지, 남은 풀이가 짧아져 정해진 예산 안에 들어왔기 때문인지는 그 결과만으로 알 수 없다.
두 질문에 필요한 비교는 다르다. 초반 예측에서는 같은 문제의 성공 시도와 실패 시도를 구별하는지 봐야 한다. 돌파 분석에서는 지금까지 쓴 토큰까지 포함한 예산을 처음부터 다시 풀기에 줬을 때도 성공하는지 봐야 한다.
2. 기존 방법들의 한계
hidden state probe 연구에서는 서로 다른 문제에서 얻은 시도를 모아 정답 여부를 예측하는 경우가 많다. 논문이 소개하는 선행 연구의 AUROC는 0.79–0.95 범위에 있지만, 여기에는 중간 답변 위치에서 측정한 결과도 포함된다. 생성 초반의 예측 결과와는 구분해야 한다. 이 논문이 직접 재구성한 David의 연구는 첫 4토큰에서 약 0.84를 보고한다.
문제는 높은 AUROC만으로 무엇을 읽었는지 알 수 없다는 데 있다. 풀이를 보지 않는 시험 감독관을 생각하면 쉽다. 감독관이 문제 번호만 보고 쉬운 문제에는 높은 점수, 어려운 문제에는 낮은 점수를 줘도 정답 여부를 꽤 잘 예측할 수 있다. 문제당 풀이가 하나뿐인 평가에서는 이 감독관과 추론 과정을 읽는 probe를 점수 하나로 구별하기 어렵다.
풀이를 끊고 재샘플링하는 방법에도 비슷한 문제가 있다. 이 방법은 주어진 앞부분에서 출발했을 때 얼마나 자주 정답에 도달하는지 측정한다. 선행 연구 중 Wang 등의 연구는 이어쓰기와 처음부터 다시 풀기를 비교하기도 했다. 다만 이 논문이 추가한 것은 같은 총 토큰 예산에서 풀이의 각 지점을 재시작 곡선과 비교하는 통제다. 앞부분이 있다는 이점을 주장하려면, 이미 쓴 토큰까지 포함한 예산을 재시작에도 줘야 한다.
저자는 이런 방법이 쓸모없다고 주장하지 않는다. 정답 예측이나 rollout 정답률을 측정하는 것과, 그 결과를 추론 과정의 정보나 돌파로 해석하는 것 사이에 추가 비교가 필요하다는 주장이다.
3. 방법
pooled AUROC를 두 종류의 비교로 나누기
AUROC는 정답 시도와 오답 시도를 하나씩 골랐을 때, 정답 시도에 더 높은 점수를 주는 정도를 측정한다. 정답 쪽 점수가 높으면 1, 낮으면 0, 동점이면 0.5로 계산한다.
설명용 예시로 문제 A의 결과가 정답 3개와 오답 1개, 문제 C의 결과가 정답 1개와 오답 3개라고 하자. 풀이를 전혀 보지 않고 A의 모든 시도에는 0.75, C의 모든 시도에는 0.25를 준다.
전체 정답 시도는 4개, 오답 시도도 4개이므로 비교할 쌍은 16개다. 같은 문제에서 나온 6쌍은 모두 동점이어서 합계 3점을 얻는다. 서로 다른 문제에서 나온 10쌍 중에서는 A의 정답과 C의 오답을 비교하는 9쌍에서 이기고, C의 정답과 A의 오답을 비교하는 1쌍에서 진다. 전체 AUROC는 12/16, 즉 0.75다. 이번 시도가 어떻게 진행됐는지 몰라도 나오는 수치다.
논문은 이 관계를 다음처럼 쓴다.
여기서 within은 같은 문제·모델 조합에서 나온 성공과 실패의 비교이고, between은 서로 다른 조합 사이의 비교다. λ는 전체 성공·실패 쌍에서 같은 조합의 쌍이 차지하는 비율이다.
문제 정보만 사용하는 점수는 같은 문제의 모든 시도에 같은 값을 준다. 따라서 within AUROC는 정확히 0.5다. 문제당 시도가 하나라면 같은 문제 안의 성공·실패 쌍이 없으므로 λ는 0이다. 이때 pooled AUROC는 문제 사이의 순위만 평가한다.
그래서 저자는 두 방법을 사용한다. 시도가 하나뿐이면 질문 정보만 쓰는 기준선보다 얼마나 나아지는지 보고, 같은 문제의 시도가 충분하면 within AUROC를 직접 계산한다.
LOO 정답률이 보여주는 것
문제 난이도를 추정하는 또 다른 기준선은 LOO 정답률이다. 평가할 시도 하나를 제외하고, 같은 문제의 나머지 시도들이 얼마나 자주 맞았는지 계산한다. 풀이 내용이나 hidden state를 읽지 않는 대신, 다른 시도의 정답 라벨을 사용하는 기준선이다.
여기에는 주의할 점이 있다. LOO 점수는 엄밀한 의미의 질문 전용 점수와 다르다. 정답 시도를 제외하면 남은 정답 수가 하나 줄고, 오답 시도를 제외하면 정답 수가 그대로다. 따라서 같은 문제 안에서는 오답 시도의 LOO 점수가 항상 더 높다. 그 결과 LOO 자체의 within AUROC는 기계적으로 0이 된다.
시도 정보를 구별하지 못하는 중립 기준은 여전히 0.5다. LOO는 문제 사이의 난이도 차이가 pooled 점수를 얼마나 높일 수 있는지 확인하는 데 쓰인다.
풀이 이어쓰기를 재시작과 비교하기
돌파 분석에서는 prefix를 지금까지 써 둔 연습장 앞부분이라고 생각하면 된다. 20분 동안 쓴 연습장을 받아 10분 더 푸는 경우와, 빈 연습장에서 30분 동안 푸는 경우를 비교하는 식이다. 다만 실제 실험에서 맞추는 것은 시간이 아니라 생성 토큰 수다.
모델의 기본 풀이를 지점 t에서 끊고, 그 앞부분을 이어서 정해진 예산으로 여러 번 풀게 한다. 정답률이 0.75 이상이 되고 다음 지점에서도 유지되는 첫 시점을 budget-fit time으로 정의한다. 이는 우선 남은 풀이가 이어쓰기 예산 안에 들어오는 시점이다.
앞부분의 가치를 보려면 처음부터 다시 푸는 정답률도 필요하다. 저자는 문제마다 1,024, 2,048, 4,096, 8,192토큰 예산에서 재시작을 네 번씩 수행한다. 이 곡선을 이용해 다음 차이를 계산한다.
첫 항은 t까지 쓴 앞부분을 B만큼 이어 갔을 때의 정답률이고, 두 번째 항은 총 t+B 예산으로 처음부터 풀었을 때의 정답률 추정치다. 실험의 기본 이어쓰기 예산은 reasoning 1,024토큰이며 답변용 512토큰을 별도로 둔다.
prefix-value time은 이어쓰기 정답률이 0.75 이상이면서 재시작 대비 차이도 0.5 이상인 첫 안정 지점이다. 최종 분류에는 우선순위가 있어서, 이 차이를 넘더라도 4,096토큰 재시작으로 이미 풀리는 경우는 budget-limited로 분류한다. 따라서 큰 차이를 보인 지점의 수와 최종 prefix-limited 분류 수는 같지 않다.
네 번의 시도만으로 정답률을 추정하면 잡음도 크다. 실제 성공 확률이 0.5여도 네 번 중 세 번 이상 성공할 확률은 약 0.31이다. 저자는 마지막 지점에서만 임계값을 넘은 후보에 네 번을 추가하고, 합쳐서 여덟 번 중 여섯 번 이상 성공해야 terminal event로 인정했다. 또한 확장 코호트에서 처음 네 번 중 한 번에서 세 번 성공한 애매한 상태는 여덟 번으로 늘렸다. 다만 여덟 번 역시 정답률을 정밀하게 추정하기에는 적은 수다.
4. 실험 결과
가장 강한 결과: 같은 probe를 다른 방식으로 평가하면
개인적으로 가장 중요한 결과는 §4.4와 Table 2다. 저자는 공개된 R1-Distill-Qwen-7B의 MATH 풀이 덤프를 사용한다. 128문제마다 256개 시도가 있어, 문제 사이의 차이와 같은 문제 안의 차이를 따로 평가할 수 있다.
새 풀이를 생성하지는 않았다. 공개된 토큰을 4-bit 모델에 teacher forcing으로 입력해 hidden state를 추출했다. 이는 원래 생성 당시의 상태를 그대로 복구한 것은 아니다. 원본과 재채점 모델 사이의 평균 top-1 일치도는 0.906으로 보고한다.
첫 4토큰의 hidden state를 사용하는 probe는 문제당 8개씩 뽑은 pooled 평가셋 1,024개에서 AUROC 0.849를 얻었다. 95% 신뢰구간은 [0.735, 0.919]다. 기존에 보고된 약 0.84와 비슷한 양성 결과를 얻은 것이다.
같은 probe를 성공과 실패가 충분히 있는 22문제의 전체 5,632개 시도에서 within 방식으로 평가하면 결과가 달라진다. 실패 수로 가중한 AUROC는 0.496 [0.466, 0.527], 성공·실패 쌍 수로 가중한 값은 0.515 [0.481, 0.562]다. 두 방식 모두 우연 수준과 구별되지 않는다.
여기서 같은 probe를 사용했지만 평가셋은 다르다는 점이 중요하다. pooled 0.849와 within 0.496을 동일한 표본에서 평가 방식만 바꾼 결과로 읽으면 안 된다. within 평가에 사용한 22문제는 전체 덤프 실패의 94%를 포함한다.
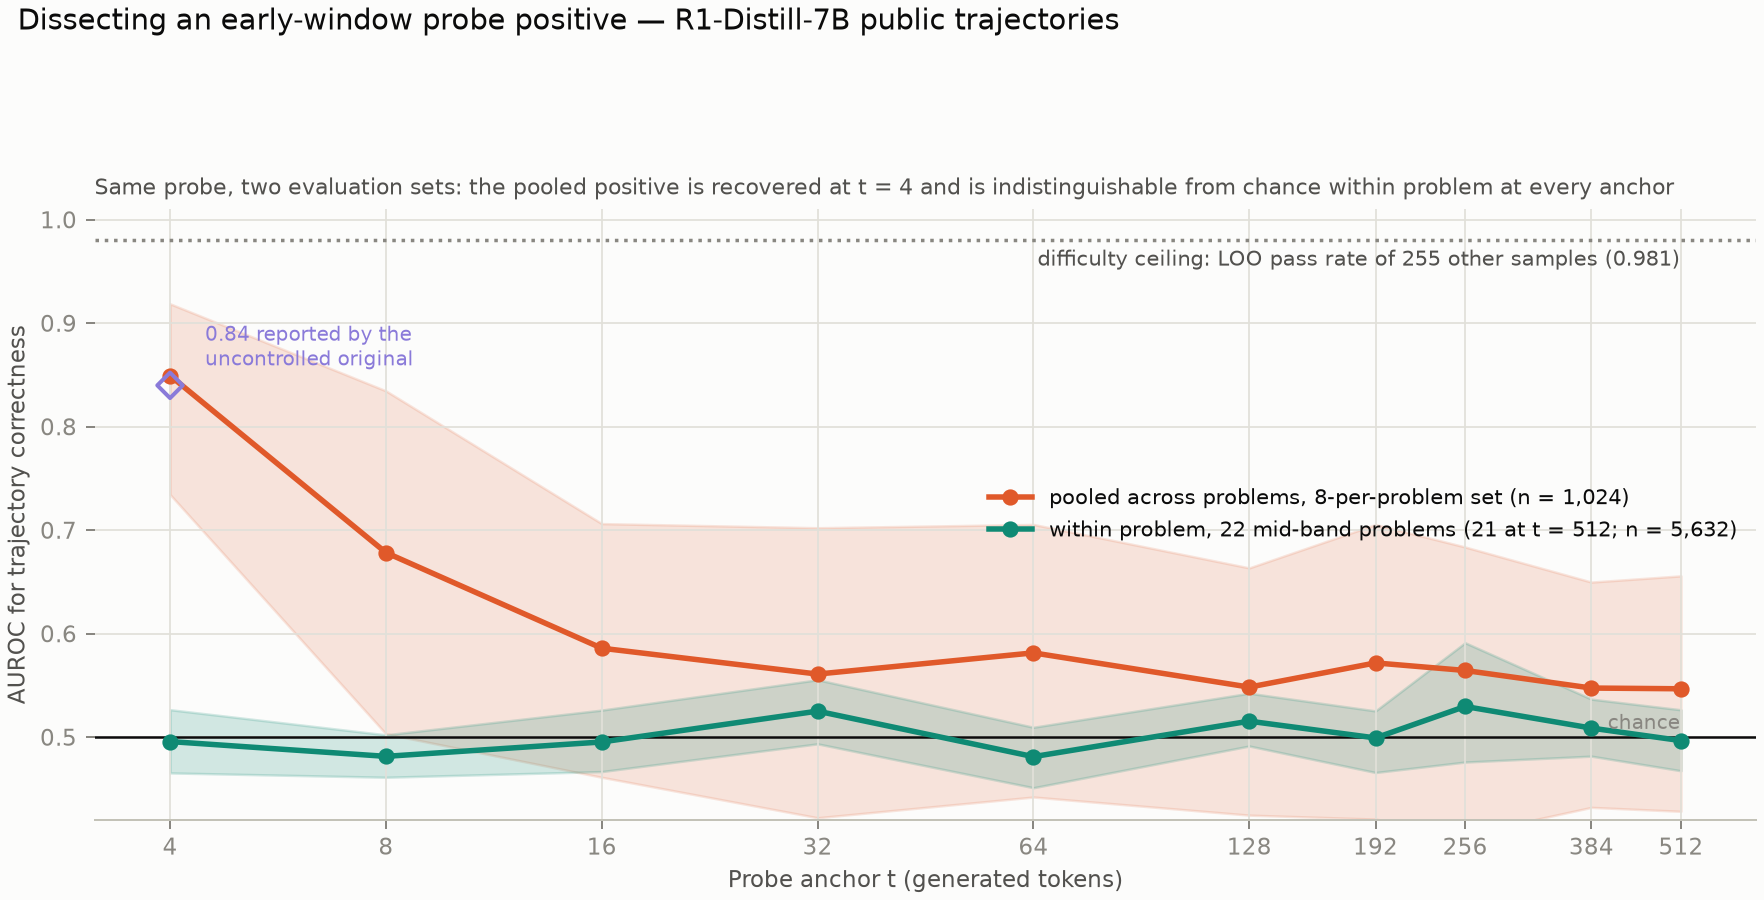
Fig. 1. 같은 probe를 서로 다른 두 평가셋에서 평가한 결과다. 주황색은 pooled AUROC, 초록색은 실패 수로 가중한 within AUROC이며, 음영은 문제 단위 bootstrap의 95% 신뢰구간이다. 논문 Figure 8.출처: Yigit Utku Bulut, arXiv 2026, 원문, CC BY 4.0. 원본 그림을 수정 없이 사용했다.
Fig. 1에서 주황색 곡선은 첫 4토큰에서 높게 시작하지만, 초록색 곡선은 전반적으로 검은 기준선 0.5 부근에 있다. 위쪽 회색 점선은 다른 255개 시도의 정답 라벨을 쓰는 LOO 기준선이므로, 풀이를 읽지 않는다는 점과 정답 정보를 사용한다는 점을 함께 봐야 한다.
pooled에서 기존 양성 결과를 얻었다는 점은 확인 역할을 한다. 적어도 기존과 비슷한 높은 점수를 내는 probe를 재구성한 뒤 통제를 적용했다는 뜻이다. 다만 이것만으로 재구성의 모든 차이가 해소되거나, 다른 종류의 probe에도 시도 정보가 없다고 결론 내릴 수는 없다.
같은 pooled 평가셋에서 나머지 255개 시도의 정답률을 사용하는 LOO 점수는 AUROC 0.981을 얻었다. 다른 시도의 라벨을 많이 사용하는 기준선이므로 비용과 정보 조건은 다르지만, 풀이를 읽지 않아도 pooled 점수가 매우 높아질 수 있음을 보여준다.
위치별 결과도 흥미롭다. pooled AUROC는 t=16에서 0.586으로 내려가고 이후에도 대체로 0.55 부근에 머문다. t=128까지는 표본 구성이 고정돼 있어, 초반 하락을 짧은 풀이가 빠진 탓으로 설명하기 어렵다. 저자는 초반 hidden state에 남아 있던 문제 정보가 생성이 진행되면서 약해지는 현상으로 해석한다.
신뢰구간은 시도를 개별적으로 뽑는 대신 문제 단위로 복원 추출해 계산했다. 같은 문제의 시도들이 공유하는 특성을 고려하기 위해서다.
시도 정보가 전혀 없다는 결과는 아니다
사후 분석에서는 문제별 평균 hidden state를 뺀 뒤 다른 문제로 전이되는 신호를 검사했다. 이 probe의 평균 within AUROC는 t=4에서 0.490이었지만, t=32에서는 0.556 [0.522, 0.588]이었다. 작은 신호가 검출된 것이다.
문제마다 별도 probe를 학습한 분석에서는 세 문제의 t=4 AUROC가 0.78–0.92였다. 이 분석은 같은 문제의 다른 시도와 정답 라벨로 학습하므로, 새로운 문제에도 적용되는 예측 성능과는 구별해야 한다. 세 문제에 포함된 실패는 전체 2,178개 중 84개였고, 그중 두 문제에서는 실패 풀이가 성공 풀이보다 4–6배 짧았다.
따라서 결과는 “hidden state에 시도 정보가 없다”보다 “기존 방식의 높은 pooled 점수는 주로 문제 사이의 차이에서 나왔고, 별도로 찾은 시도 정보는 평균적으로 작고 일부 문제에 몰려 있다”로 읽는 편이 정확하다.
대규모 난이도 기준선과 확인 검정
공개 OpenR1-Math 데이터에서도 풀이를 읽지 않는 LOO 정답률은 높은 점수를 냈다. 91,573문제의 DeepSeek-R1 생성 192,315개에서 AUROC 0.873 [0.870, 0.876]이었다. GPQA-diamond의 64문제, 문제당 256개 시도에서는 0.917 [0.875, 0.938]이었다. 이는 각 선행 probe와 같은 조건에서 겨룬 비교는 아니지만, 난이도만으로 기존 보고 범위의 점수가 나올 수 있다는 증거다.
자체 확인 검정에서는 질문 정보만 사용하는 기준선에 초반 내부 신호를 추가했다. 기준선에는 MATH의 사람 난이도 라벨, 주제, 문제 길이와 기호 수 등의 텍스트 통계, 모델 종류가 들어간다. 추가 특징은 첫 512토큰의 entropy, surprisal, hidden-state 변화 등을 요약한 15개 값이다.
기본 풀이의 최종 성공을 예측하는 주 목표에서 AUROC는 0.828에서 0.853으로 올랐다. 보고된 차이는 +0.026이고 95% 신뢰구간은 [−0.054, +0.167]이었다. 보조 목표는 non-instant 셀에서 4,096토큰 재시작의 추정 정답률이 0.75 이상인지 예측하는 것이다. 여기서 AUROC는 0.875에서 0.785로 내려갔고, 차이는 −0.090 [−0.213, +0.033]이었다. 개별 재시작 한 번의 성공 여부를 예측한 결과는 아니다.
두 경우 모두 개선을 검출하지 못했다. 그러나 주 목표의 구간은 상당한 양의 효과도 허용한다. 이 결과를 효과가 없다는 증명으로 읽어서는 안 된다. 저자도 확인 검정보다 앞의 다중 시도 분석을 더 강한 근거로 평가한다.
돌파는 얼마나 남았나
돌파 실험은 Gemma-4 E4B와 Ministral-3 3B Reasoning을 4-bit MLX로 실행했다. MATH 89문제와 두 모델을 조합한 178개 셀에서 각각 16,384토큰 예산의 기본 풀이 하나를 생성했다. 추출한 답을 참조 정답과 수치 동치, 기호 동치 순서로 비교하며, 답 추출 실패는 오답 처리한다.
재시작 통제를 넣은 최종 분류에서 prefix-limited는 178개 셀 중 하나였다. 하지만 이를 일반적인 추론 모델의 돌파 발생률로 읽을 수는 없다. 코호트는 중간 난이도를 겨냥해 선정됐고, 같은 문제가 두 모델에 반복되며, 셀마다 기본 풀이도 하나뿐이다.
재시작 예산에 따른 차이는 확실히 보인다. instant를 제외한 확장 코호트에서 Ministral이 정답률 기준 0.75에 도달한 문제의 비율은 예산 증가에 따라 0%, 19%, 45%, 79%로 높아졌다. Gemma는 10–12%에 머물렀다. 측정한 예산 범위에서 전자는 계산량 부족의 영향을 크게 받고, 후자는 예산만 늘려서는 해결하기 어려운 모습을 보였다.
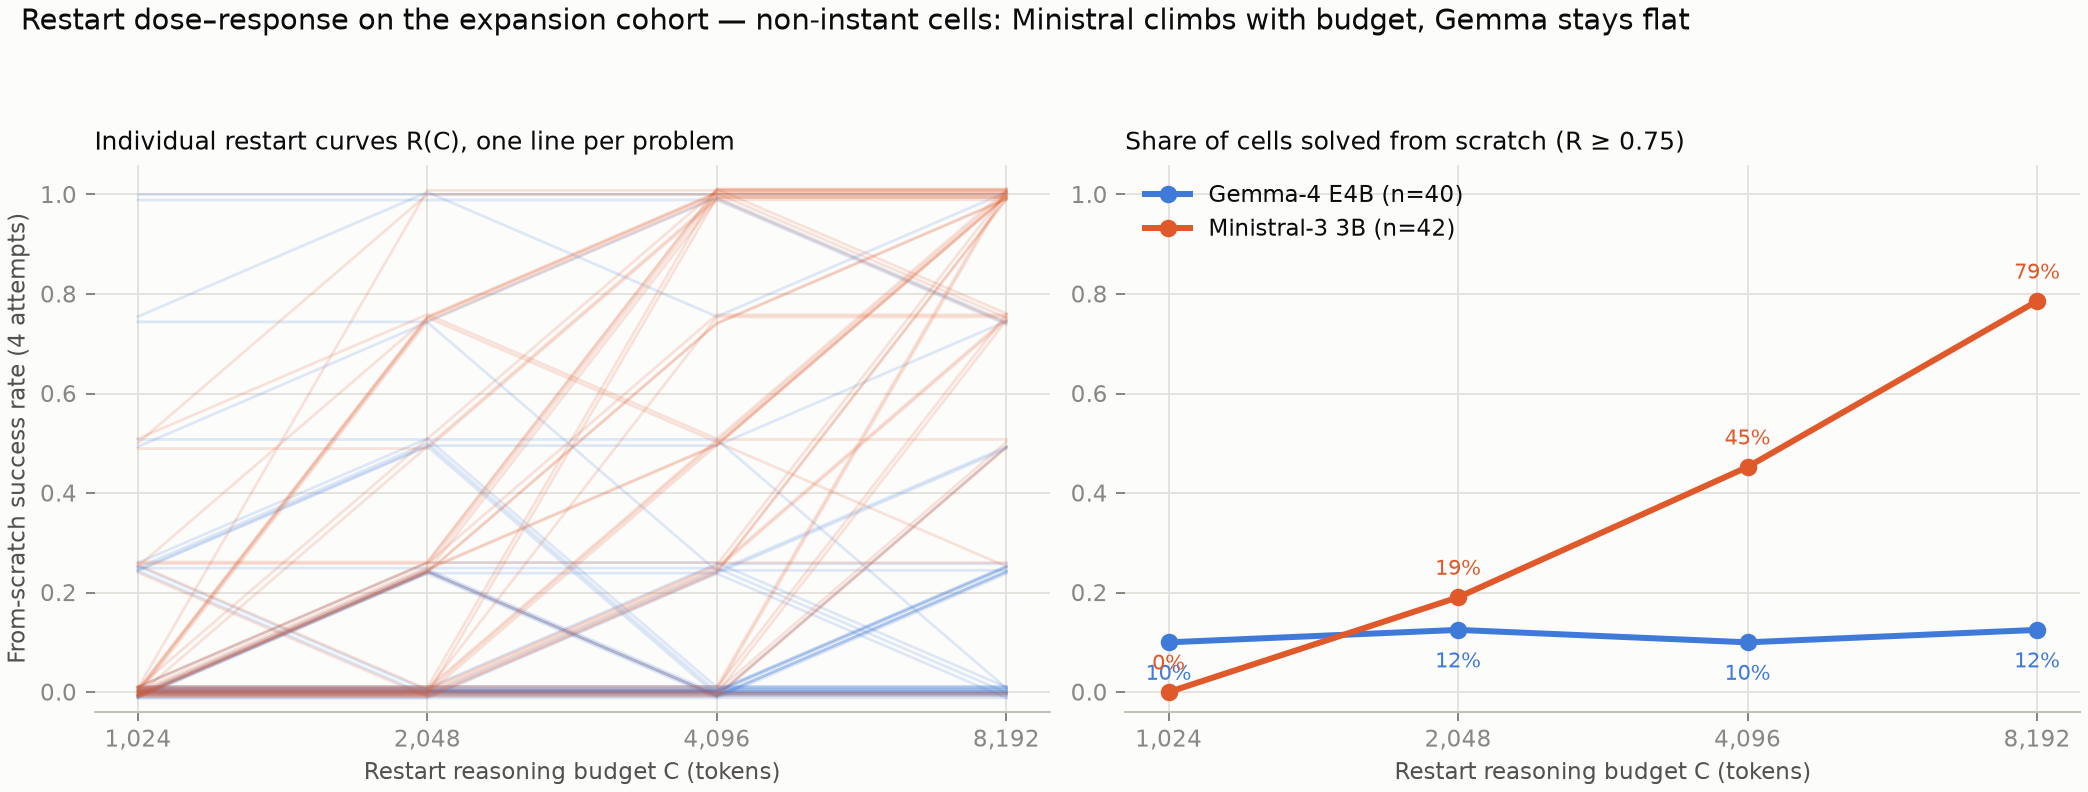
Fig. 2. instant를 제외한 확장 코호트의 재시작 결과다. 왼쪽은 문제별 정답률이고, 오른쪽은 각 예산에서 정답률 0.75 이상에 도달한 셀의 비율이다. Gemma-4는 40개, Ministral-3는 42개 셀을 포함한다. 논문 Figure 2.출처: Yigit Utku Bulut, arXiv 2026, 원문, CC BY 4.0. 원본 그림을 수정 없이 사용했다.
Fig. 2의 오른쪽 주황색 곡선은 예산이 늘수록 올라가지만 파란색 곡선은 거의 평평하다. 다만 왼쪽의 개별 곡선에는 예산을 늘려도 정답률이 내려가는 구간이 있다. 예산마다 네 번씩 측정한 추정치이므로, 문제별 정답률이 반드시 단조롭게 증가한다고 해석해서는 안 된다.
긴 앞부분이 쓸모없었던 것은 아니다. 마지막 지점에서만 성공 기준을 충족한 Ministral의 13개 셀 중, 총 토큰 예산을 재시작 곡선 안에서 맞춰 비교할 수 있는 9개에서는 이어쓰기가 모두 우세했다. 정답률 차이의 중앙값은 +0.31이었다. 나머지 4개는 필요한 9,216토큰 재시작을 측정하지 않아 8,192토큰 결과를 대신 사용했다. 이 대용 비교에서는 이어쓰기가 두 번 이기고 두 번 비겼으며, 예산이 정확히 맞는 9개와 구분해야 한다.
그런데 최대 8,192토큰 재시작은 이 13개 중 11개에서 성공 기준에 도달했다. 저자가 이를 주로 compute compression으로 해석하는 이유다. 앞부분을 이어 가는 편이 같은 예산에서 유리하지만, 처음부터 더 오래 풀어도 상당수는 같은 성공 기준에 도달한다. 다만 이 실험은 정답 여부를 비교하므로 같은 내용의 해법을 찾았는지까지 보여주지는 않는다.
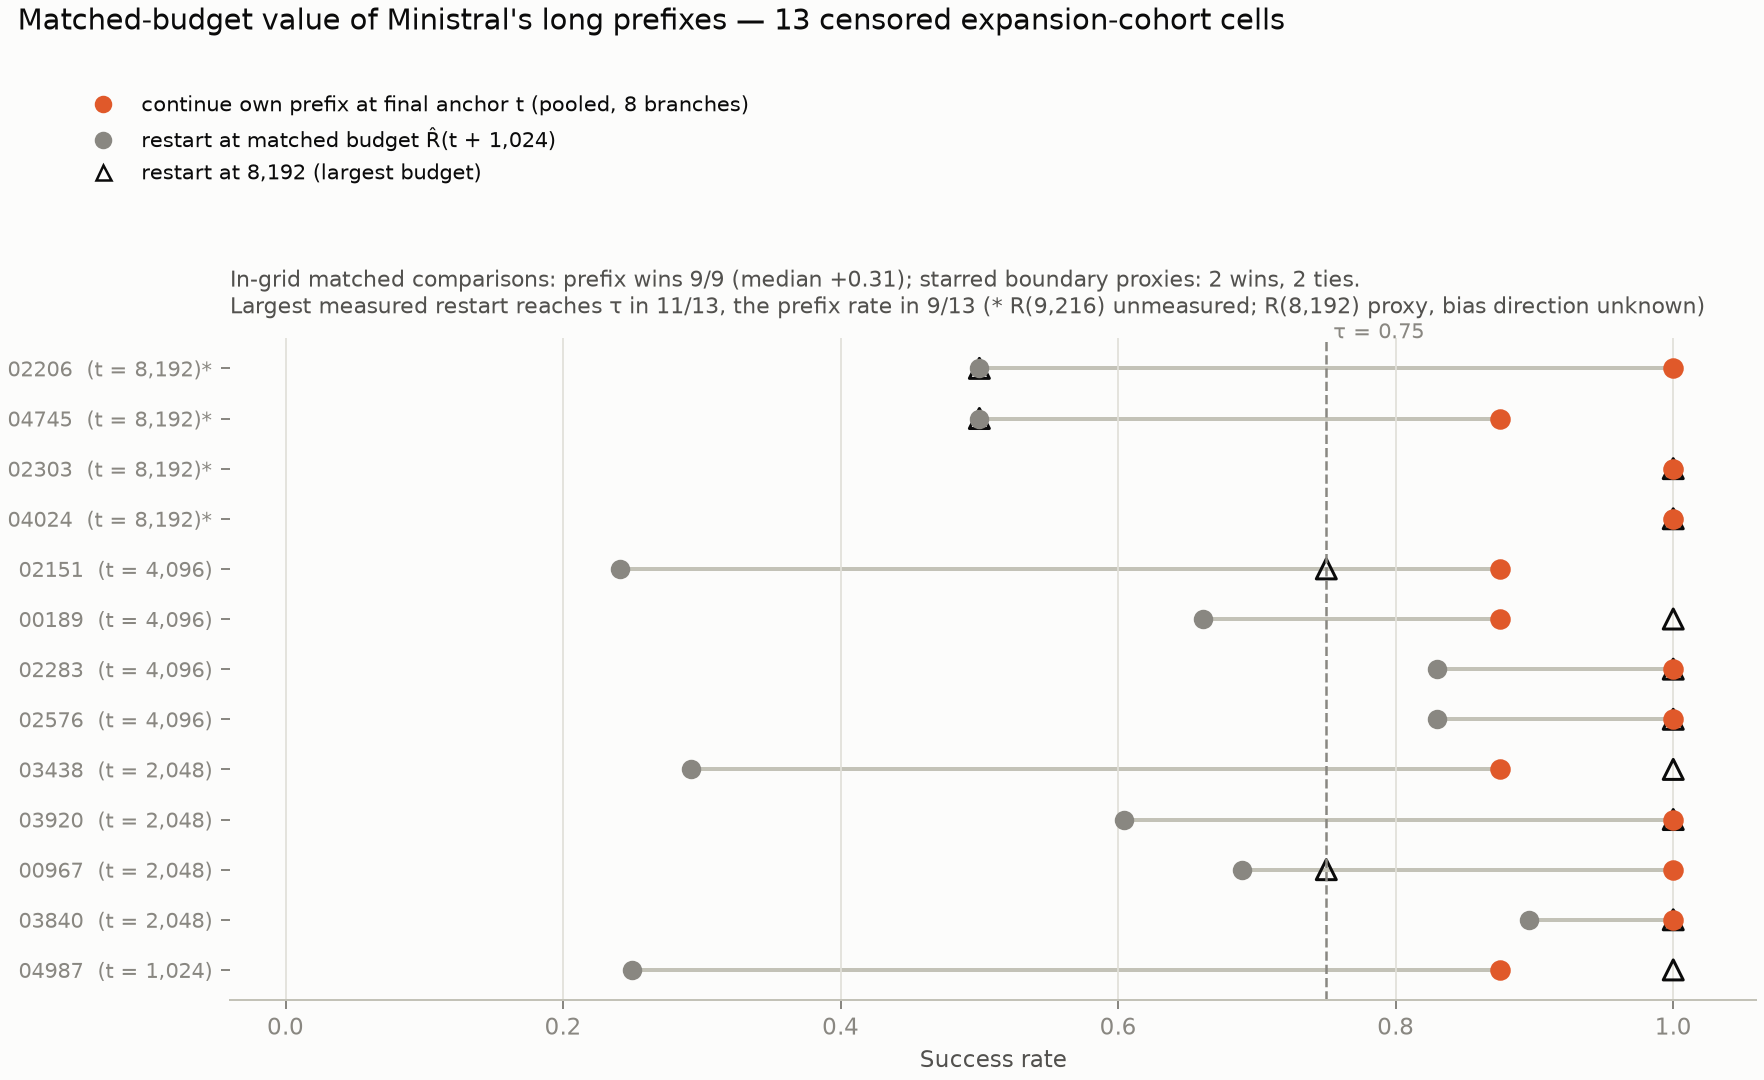
Fig. 3. Ministral의 마지막 지점에서 성공 기준을 재확인한 13개 셀이다. 주황색 점은 이어쓰기, 회색 점은 예산을 맞춘 재시작의 추정 정답률이고, 빈 삼각형은 최대 8,192토큰 재시작 결과다. 별표가 붙은 네 행의 회색 점은 예산이 맞지 않는 대용 비교다. 논문 Figure 3.출처: Yigit Utku Bulut, arXiv 2026, 원문, CC BY 4.0. 원본 그림을 수정 없이 사용했다.
Fig. 3은 한 행을 한 셀로 읽으면 된다. 별표가 없는 아홉 행에서는 주황색 점이 회색 점보다 오른쪽에 있지만, 빈 삼각형도 여러 행에서 성공 기준인 세로 점선 0.75에 닿거나 이를 넘는다. 앞부분이 같은 예산에서 주는 이점과, 더 큰 재시작 예산으로도 성공할 수 있는지는 서로 다른 질문이라는 점이 드러난다.
5. 읽으면서 든 의문
첫 번째는 두 분석의 증거가 얼마나 강한가다. 개인적으로 AUROC 분해와 공개 덤프 분석이 가장 설득력 있었다. 높은 pooled 점수가 시도 정보를 보장하지 않는다는 점을 수식으로 설명하고, 기존과 비슷한 양성 결과를 재구성한 뒤 within 평가를 제시했기 때문이다. 반면 돌파 분석은 작은 모델 두 개, 셀당 기본 풀이 하나, 적은 재샘플링 횟수에 의존한다. 두 분석을 묶는 문제의식은 분명하지만 결론에 둘 무게는 다르다고 생각한다.
두 번째는 재시작 곡선을 실제 환경에서 어떻게 얻는가다. 곡선을 그리려면 같은 문제를 여러 번 풀고 각 답의 정답 여부를 알아야 한다. 이 논문에서는 참조 정답과 동치 검증기가 그 역할을 한다. 따라서 네 지점의 재시작 곡선으로 배포 환경을 진단하자는 제안도 정답을 판정할 수 있는 과제에서 적용하기 쉽다. 정답 확인이 어려운 자유형 과제에 그대로 가져가기는 어렵다.
세 번째는 토큰 예산의 의미다. 논문은 생성 토큰 수를 맞추지만 FLOPs나 지연 시간을 맞추지는 않는다. 긴 앞부분을 이어 쓸 때의 KV cache 재사용과 처음부터 다시 계산하는 비용도 다르다. 따라서 compute compression이라는 결과를 곧바로 실제 서빙 비용 절감으로 환산할 수는 없다.
네 번째는 재채점의 차이다. 원본 생성과 4-bit teacher forcing 사이의 차이가 약한 within 신호에 영향을 줬을 가능성은 남는다. 같은 상태에서 pooled 양성 결과를 얻었고 일부 문제의 within 신호도 검출했다는 점은 우려를 줄여준다. 하지만 그것만으로 원본 정밀도에서 결과가 같다고 보장하지는 않는다.
마지막은 관련 연구를 묶어 읽을 때의 주의점이다. 중간 답변 위치에서 정답 여부를 예측하는 연구, 생성 전 activations로 난이도를 읽는 연구, 임의의 초반 토큰에서 최종 결과를 예측하는 연구는 같은 주장이 아니다. 이 논문도 그 차이를 인정한다. 따라서 이번 결과는 특정 설정의 높은 AUROC를 해석하는 기준으로는 강하지만, 내부 신호를 사용하는 연구 전체가 무의미하다는 근거는 아니다.
6. 정리
개인적으로 이 논문의 장점은 성능 수치보다 그 수치를 해석하는 데 필요한 비교를 먼저 묻는 태도에 있다고 생각한다. 기존 결과를 재구성한 뒤 통제를 추가한 방식은 설득력 있었지만, 소형 모델의 제한된 실험으로 추론 모델 전체를 판단할 수는 없다. 반론의 강도를 실험이 뒷받침하는 범위에 맞춰 읽어야 하는 논문이다.
또 하나 좋았던 점은 공개된 다중 시도 데이터만으로 핵심 분석을 수행했다는 것이다. 성공한 풀이뿐 아니라 실패를 포함한 반복 시도가 공개돼 있었기에, 문제 난이도와 시도 정보를 나눠 평가할 수 있었다. 데이터 공개 방식 자체가 후속 연구에서 검증할 수 있는 질문을 바꾼 사례다.
7. 같이 읽어볼 논문
- Joey David, “Temporal predictors of outcome in reasoning language models” (2025). 이 논문이 비슷한 설정으로 재구성한 초반 예측 결과의 출처다. 높은 pooled 점수를 어떻게 해석할지 비교하며 읽기 좋다.
- Zhang et al., “Reasoning models know when they’re right: probing hidden states for self-verification” (COLM 2025). 중간 답변 위치를 probe한다. 임의의 초반 위치와 중간 답변 위치를 구별해서 볼 필요가 있다.
- Lanham et al., “Measuring faithfulness in chain-of-thought reasoning” (2023). 풀이를 중간에 끊는 실험을 통해 명시된 추론의 역할을 조사한다. 재시작 통제가 무엇을 추가하는지 비교할 수 있다.
- Lugoloobi et al., “LLMs encode their failures: predicting success from pre-generation activations” (2026). 생성 전 activations의 예측력을 다룬다. 문제 난이도를 읽는 신호와 진행 중인 시도의 정보를 구별하는 데 관련이 있다.
- Moreno Cencerrado et al., “No answer needed: predicting LLM answer accuracy from question-only linear probes” (2026). 답변 생성 전 질문 표현만으로 정확도를 예측하는 연구로, 질문 전용 기준선의 중요성과 연결된다.