LettuceDetect: A Hallucination Detection Framework for RAG Applications
ModernBERT 기반 토큰 분류기로 짧은 컨텍스트·LLM 계산비용 문제를 동시에 해결해 RAGTruth에서 경량 모델로 SoTA급 성능 달성
RAG 환경의 hallucination detection을 공부하면서 LettuceDetect를 읽었다. 같은 저자 그룹이 나중에 코드와 도구 출력까지 범위를 넓힌 "Beyond Document Grounding"을 내는데, LettuceDetect는 그 후속 연구의 베이스라인이 된 작업이다. 본문은 6페이지로 짧다. 새 손실함수나 학습 기법은 없고, ModernBERT라는 긴 컨텍스트 인코더를 RAGTruth로 토큰 분류기로 학습시킨 것이 전부다. 그래도 이 정도로 단순한 방법이 어디까지 올라가는지 확인해 볼 만하다고 생각했다.
- 저자: Ádám Kovács (KR Labs), Gábor Recski (KR Labs, TU Wien)
- 게재: arXiv 2502.17125 (2025)
- 코드: KRLabsOrg/LettuceDetect (MIT 라이선스, pip 패키지
lettucedetect), 모델은 Hugging Face의 KRLabsOrg/lettucedect-base-modernbert-en-v1과 lettucedect-large-modernbert-en-v1
0. 한 줄 요약
context, question, answer를 한 번에 넣고 answer의 토큰마다 근거가 있는지 없는지 분류하는 ModernBERT 모델이다. 150M, 396M짜리 인코더로 RAGTruth에서 프롬프트 기반 방법과 기존 인코더 모델 Luna를 앞서고, 파인튜닝한 Llama-2-13B와 비슷한 성능을 냈다.
1. 문제 정의
RAG는 검색한 문서를 근거로 답하게 해서 hallucination을 줄이려는 방법이다. 하지만 문서를 붙여 줘도 모델은 여전히 틀린 말을 한다. 검색이 불완전할 때도 있고, 모델이 주어진 문서보다 자기가 원래 알던 지식을 더 믿을 때도 있다. 논문은 Ji et al.(2023)의 분류를 따라 모델 내부 지식에서 생기는 오류를 intrinsic hallucination, 주어진 컨텍스트에 근거하지 않은 응답을 extrinsic hallucination으로 나눈다. RAG에서 문제가 되는 건 주로 extrinsic 쪽이다.
이걸 잡는 탐지기를 실제 서비스에 붙이려고 하면 두 가지가 걸린다고 저자들은 말한다. 첫째, 기존 인코더 기반 탐지기는 컨텍스트 윈도우가 짧아서 긴 문서나 여러 passage를 다 담지 못한다. 둘째, LLM 기반 방법은 계산 비용이 커서 실시간으로 돌리기 어렵다. 이 두 가지는 초록에 적힌 문제 제기이고, 서론은 좋은 탐지 방법들이 비허용 라이선스이거나 큰 LLM에 의존한다는 점을 동기로 든다.
저자들이 RAGTruth를 직접 토큰화해 보니 평균 801토큰, 중앙값 741토큰, 최소 194토큰, 최대 2,632토큰이었다(§3). BERT의 원래 한도인 512토큰을 넘는 샘플이 흔하다는 얘기다. 그래서 8,192토큰까지 처리하는 ModernBERT를 쓰겠다는 게 이 논문의 출발점이다.
2. 기존 방법들의 한계
논문의 관련 연구(§2)는 기존 방법을 세 갈래로 나눈다.
첫째는 프롬프트 기반 방법이다. RAGAS, TruLens, ARES 같은 평가 프레임워크와 SelfCheckGPT, ChainPoll, LM vs LM 등이 여기 들어간다. 주로 zero-shot이나 few-shot LLM으로 판정하는데(RAGAS, TruLens, ARES는 few-shot 또는 파인튜닝한 판정 모델을 쓴다), 저자들은 실시간 예측이 여전히 어렵다고 본다. Table 2를 보면 성능도 아쉽다. gpt-4-turbo 프롬프트 방식은 전체 recall이 97.9로 거의 다 잡지만 precision이 46.9에 그쳐서, 내 해석으로는 hallucination이라고 과하게 표시하는 경향이 있어 보인다.
둘째는 파인튜닝한 LLM judge다. RAGTruth 논문의 Llama-2-13B, 그리고 DPO로 학습한 Llama-3-8B 기반 RAG-HAT이 여기에 속한다. RAGTruth에서 가장 좋은 성능을 내지만 모델이 8B, 13B로 크다.
셋째는 인코더 기반 방법이다. RAGHalu는 DeBERTa 기반 NLI 모델을 파인튜닝해 두 층의 이진 분류기로 쌓은 구조이고, Luna도 DeBERTa와 NLI에서 출발해 GPT-4가 라벨을 단 여러 도메인의 RAG QA 데이터로 학습했다. 가볍다는 장점은 있지만, 저자들은 초록에서 기존 인코더 방법의 짧은 컨텍스트를 한계로 꼽는다.
다만 논문은 Luna를 소개하면서 "longer contexts"를 잘 다루는 경량 시스템이라고도 쓴다. 그래서 개인적으로는 초록의 문제 제기와 관련 연구의 설명이 조금 어긋난다고 느꼈다. 이 부분은 뒤에서 다시 얘기하겠다.
3. 방법
방법은 아주 단순하다. 아키텍처는 Luna와 비슷한 인코더 기반 토큰 분류기이고, 백본을 ModernBERT로 바꾸고 RAGTruth로 학습시킨 것이 핵심이다.
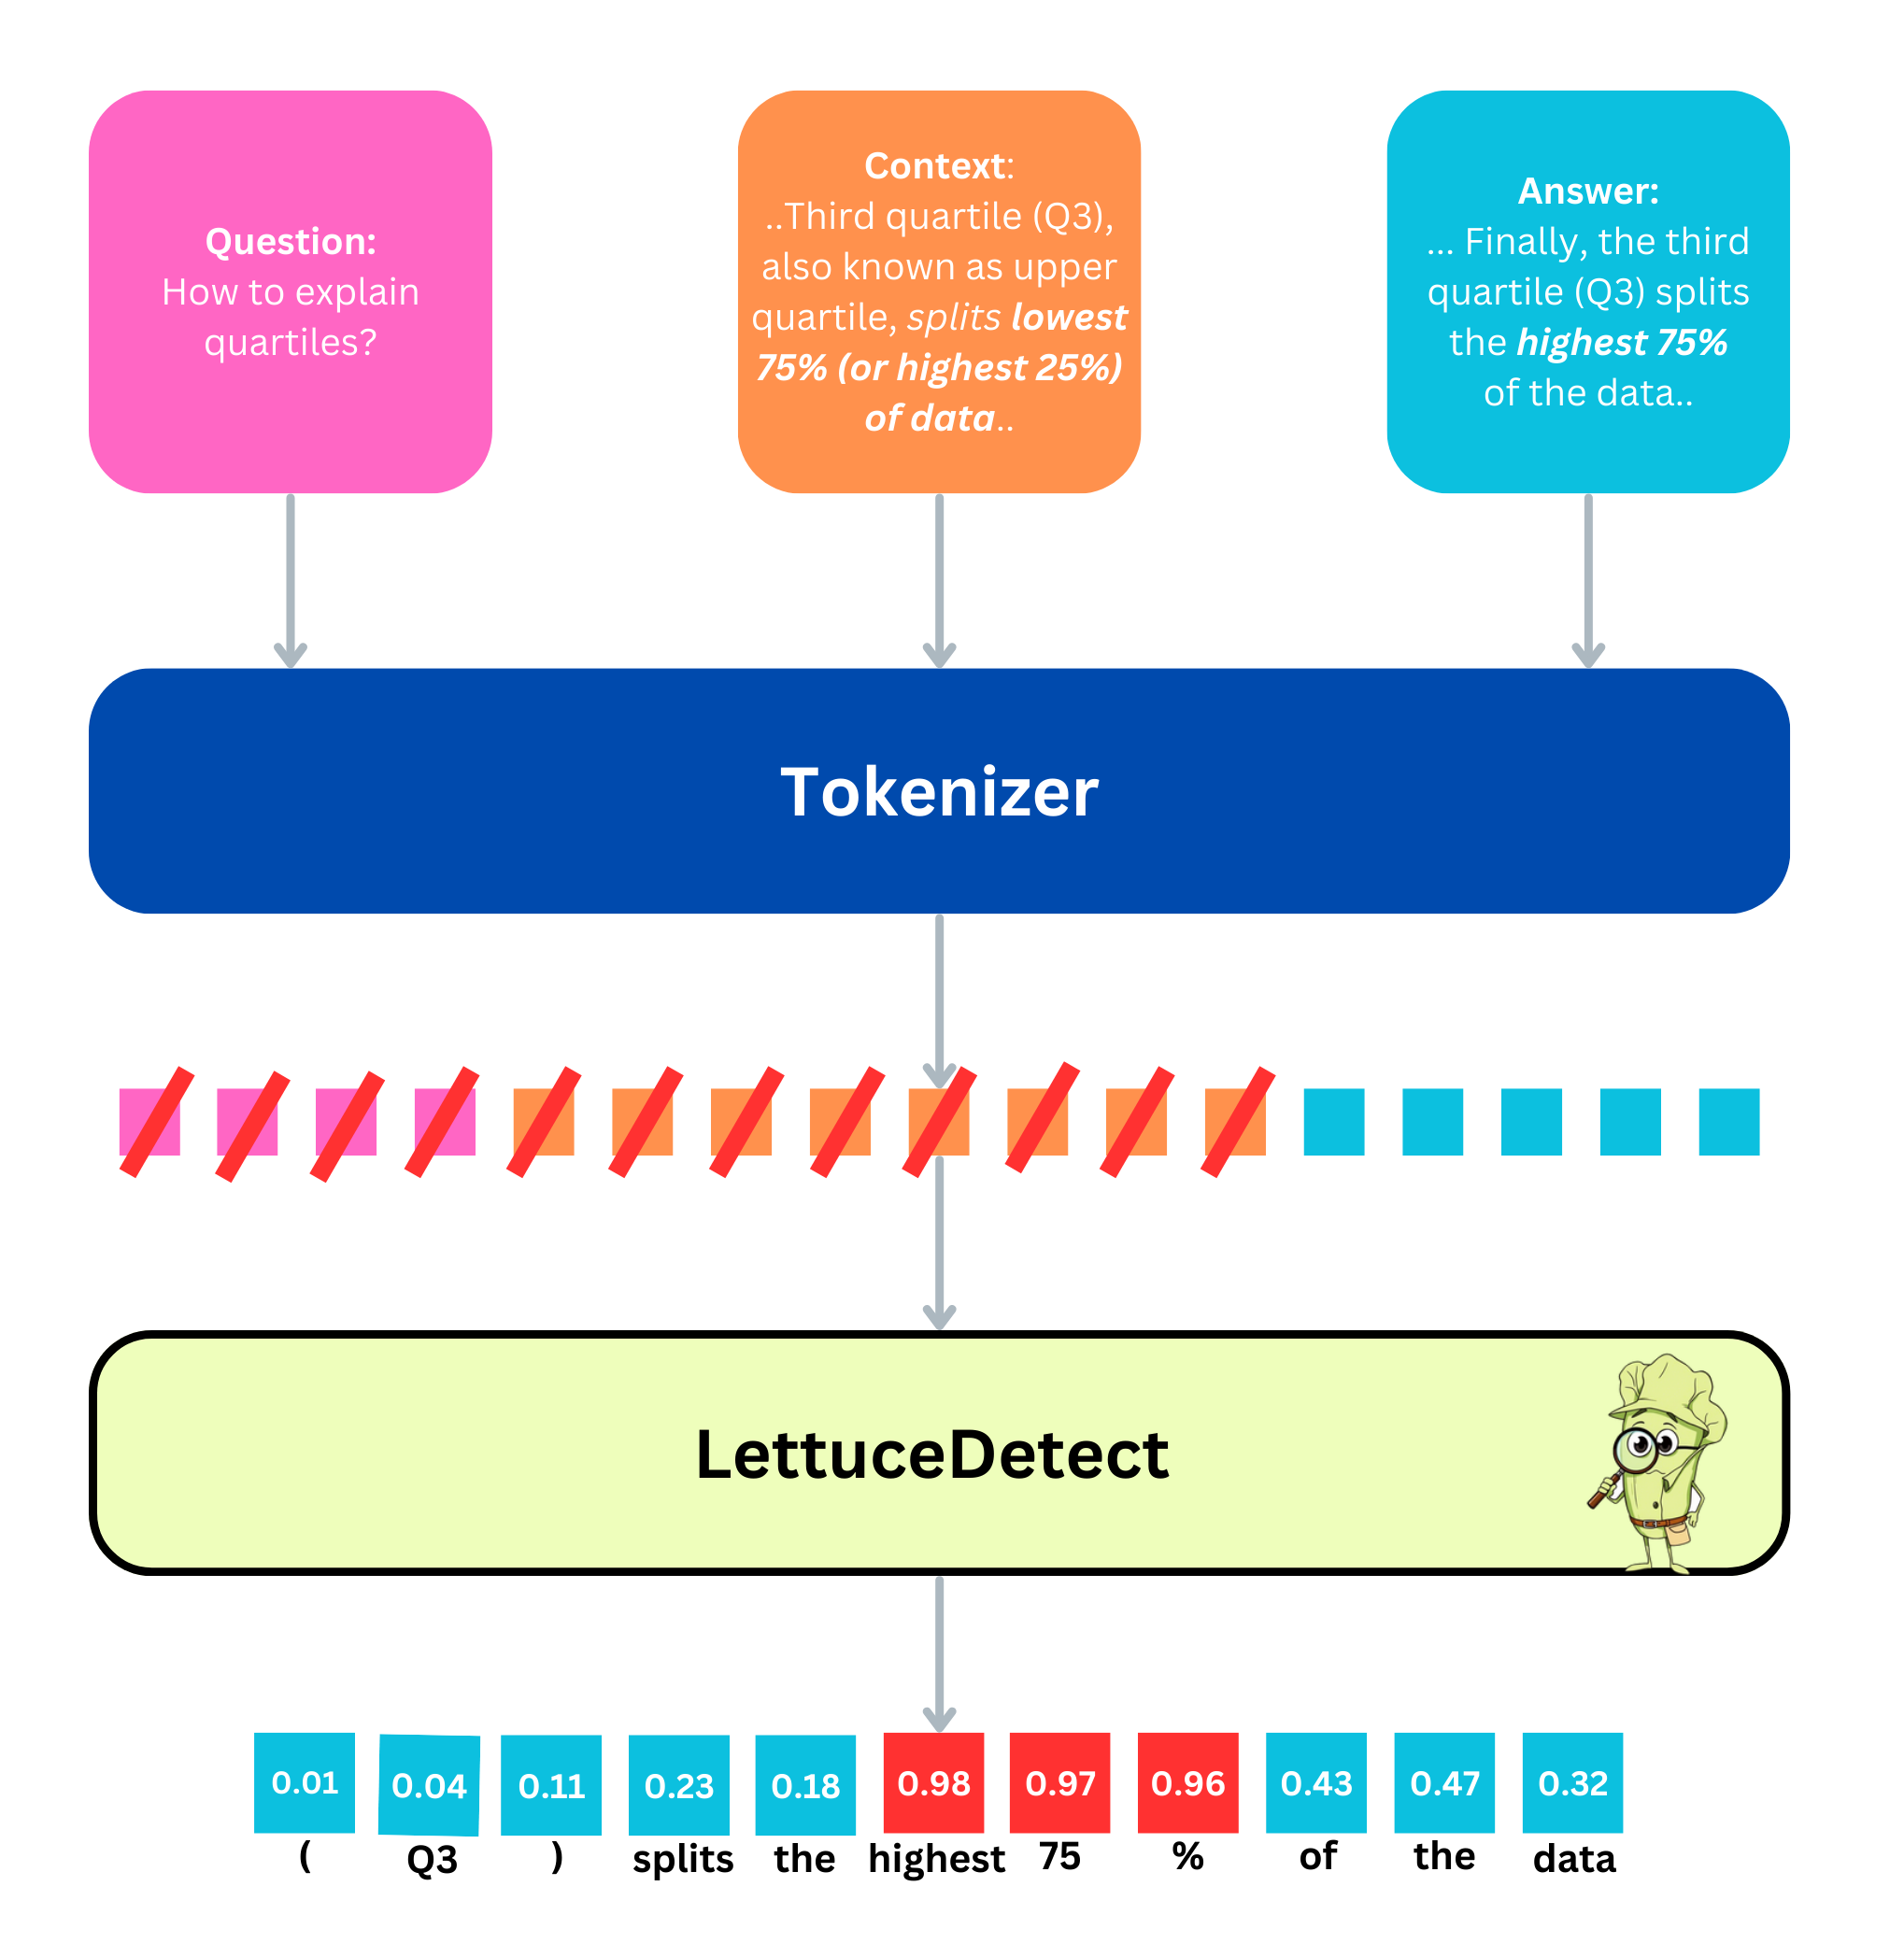
Fig. 1. LettuceDetect 구조. question, context, answer를 토큰화해 넣고, question과 context 토큰은 손실 계산에서 마스킹한다(빨간 선). 출력은 answer 토큰마다의 hallucination 확률이고, span 단위 출력이 필요하면 연속된 hallucination 토큰을 묶는다.출처: Kovács & Recski, arXiv 2025 (CC BY 4.0) (논문 Figure 2)
입력은 context, question, answer를 특수 토큰으로 이어 붙여 만든다. context 앞에 [CLS], 구분에 [SEP]를 쓰고 최대 4,096토큰으로 자른다. 논문에도 적혀 있듯이 이 버전은 ModernBERT의 8,192토큰을 다 쓰지 않았다. 라벨은 answer 토큰에만 붙는다. 근거가 있으면 0, hallucination이면 1이고, context와 question 토큰은 label=-100으로 손실 계산에서 뺀다. 한 가지 눈에 띄는 점은 기존 인코더 방법들과 달리 NLI로 미리 학습하지 않고 ModernBERT에서 바로 시작했다는 것이다.
학습은 Hugging Face의 AutoModelForTokenClassification으로 했다. AdamW(learning rate 1e-5, weight decay 0.01), batch size 8로 6 epoch를 A100 한 장에서 돌렸다. 체크포인트는 token-level F1이 가장 좋은 것을 저장했다. 추론하면 answer 토큰마다 확률이 나오고, span 단위로 볼 때는 확률이 0.5를 넘는 토큰이 연속되면 하나의 span으로 묶는다.
RAGTruth 라벨은 원래 Evident Conflict, Subtle Conflict, Evident Introduction of Baseless Information, Subtle Introduction of Baseless Information 네 가지 유형으로 나뉜다. 이 논문은 유형을 구분하지 않고 hallucination이냐 아니냐만 학습한다. 논문 Table 1의 예시를 보면 어떤 데이터인지 감이 온다. 사분위수를 설명하는 질문에서 문서에는 Q3가 "lowest 75% (or highest 25%)"를 나눈다고 적혀 있는데, 응답은 "highest 75%"라고 썼다. 이 "highest 75%" span이 Evident Conflict로 라벨링돼 있다.
실제로 쓸 때는 사람이 직접 span을 표시한 RAGTruth 같은 학습 데이터가 있어야 한다는 전제가 있다. 지도 학습 탐지기로서는 당연한 조건이지만, 개인적으로는 도메인이나 언어가 바뀌면 그만큼의 주석 데이터가 다시 필요할 것이라고 생각한다.
4. 실험 결과
평가는 RAGTruth 테스트셋에서 했다. RAGTruth는 MS MARCO 기반 QA(질문당 context 최대 3개), Yelp Open Dataset 기반 data-to-text, CNN/Daily Mail 기반 뉴스 요약의 세 과제로 이루어져 있다. span 단위로 사람이 주석을 단 예제가 18,000개이고, 샘플마다 GPT-4-0613, Mistral-7B-Instruct, Llama-2-7b-chat, Llama-2-13B-chat 등 6개 모델의 응답이 들어 있다. 평가는 RAGTruth 논문의 방식을 따라 두 수준으로 나눈다. example-level은 답변에 hallucination이 하나라도 있는지 맞히는 것이고, span-level은 예측 span과 정답 span이 글자 단위로 얼마나 겹치는지를 precision, recall, F1로 잰다.
결과는 표로만 나와 있어서 숫자로 정리한다. example-level(Table 2)에서 lettucedetect-large-v1의 전체 F1은 79.22다. gpt-4-turbo 프롬프트 방식 63.4, Luna 65.4, 파인튜닝한 Llama-2-13B 78.7보다 높고, RAG-HAT(83.9)에만 뒤진다. base 모델은 76.07이다. 과제별로 보면 large 모델은 QA 70.18, data-to-text 88.54, 요약 59.69로 세 과제 모두에서 Llama-2-13B(68.2, 88.1, 59.1)를 근소하게 앞선다. 그런데 차이는 0.4~2.0 정도로 작다. LettuceDetect와 파인튜닝 LLM 기준으로는 세 과제 중 요약의 F1이 가장 낮고, 요약에서 large 모델의 recall은 55.88에 그친다. 반면 프롬프트 기반 방법과 Luna는 대부분 QA에서 F1이 더 낮다.
span-level(Table 3)에서는 large 모델이 전체 F1 58.93으로 Llama-2-13B의 52.7보다 높다. 비교 대상은 프롬프트 방식 두 개와 Llama-2-13B뿐이다. RAG-HAT은 span-level을 측정하지 않았고, 다른 연구들도 이 과제에서 성능을 보고하지 않았기 때문이다. 표를 자세히 보면 요약 과제에서는 base 모델(36.71)이 Llama-2-13B(38.6)보다 낮다. large 모델(44.63)만 앞선다.
효율 쪽에서는 모델 크기가 150M(base), 396M(large)이고, 단일 GPU에서 초당 30~60개 예제를 처리한다고 한다. 저자들은 가장 좋은 모델들보다 약 30배 작다고 쓴다. Streamlit으로 만든 웹 데모도 함께 공개했는데, question, context, answer를 넣으면 hallucination으로 판정된 span을 강조해서 보여 준다(Fig. 2).
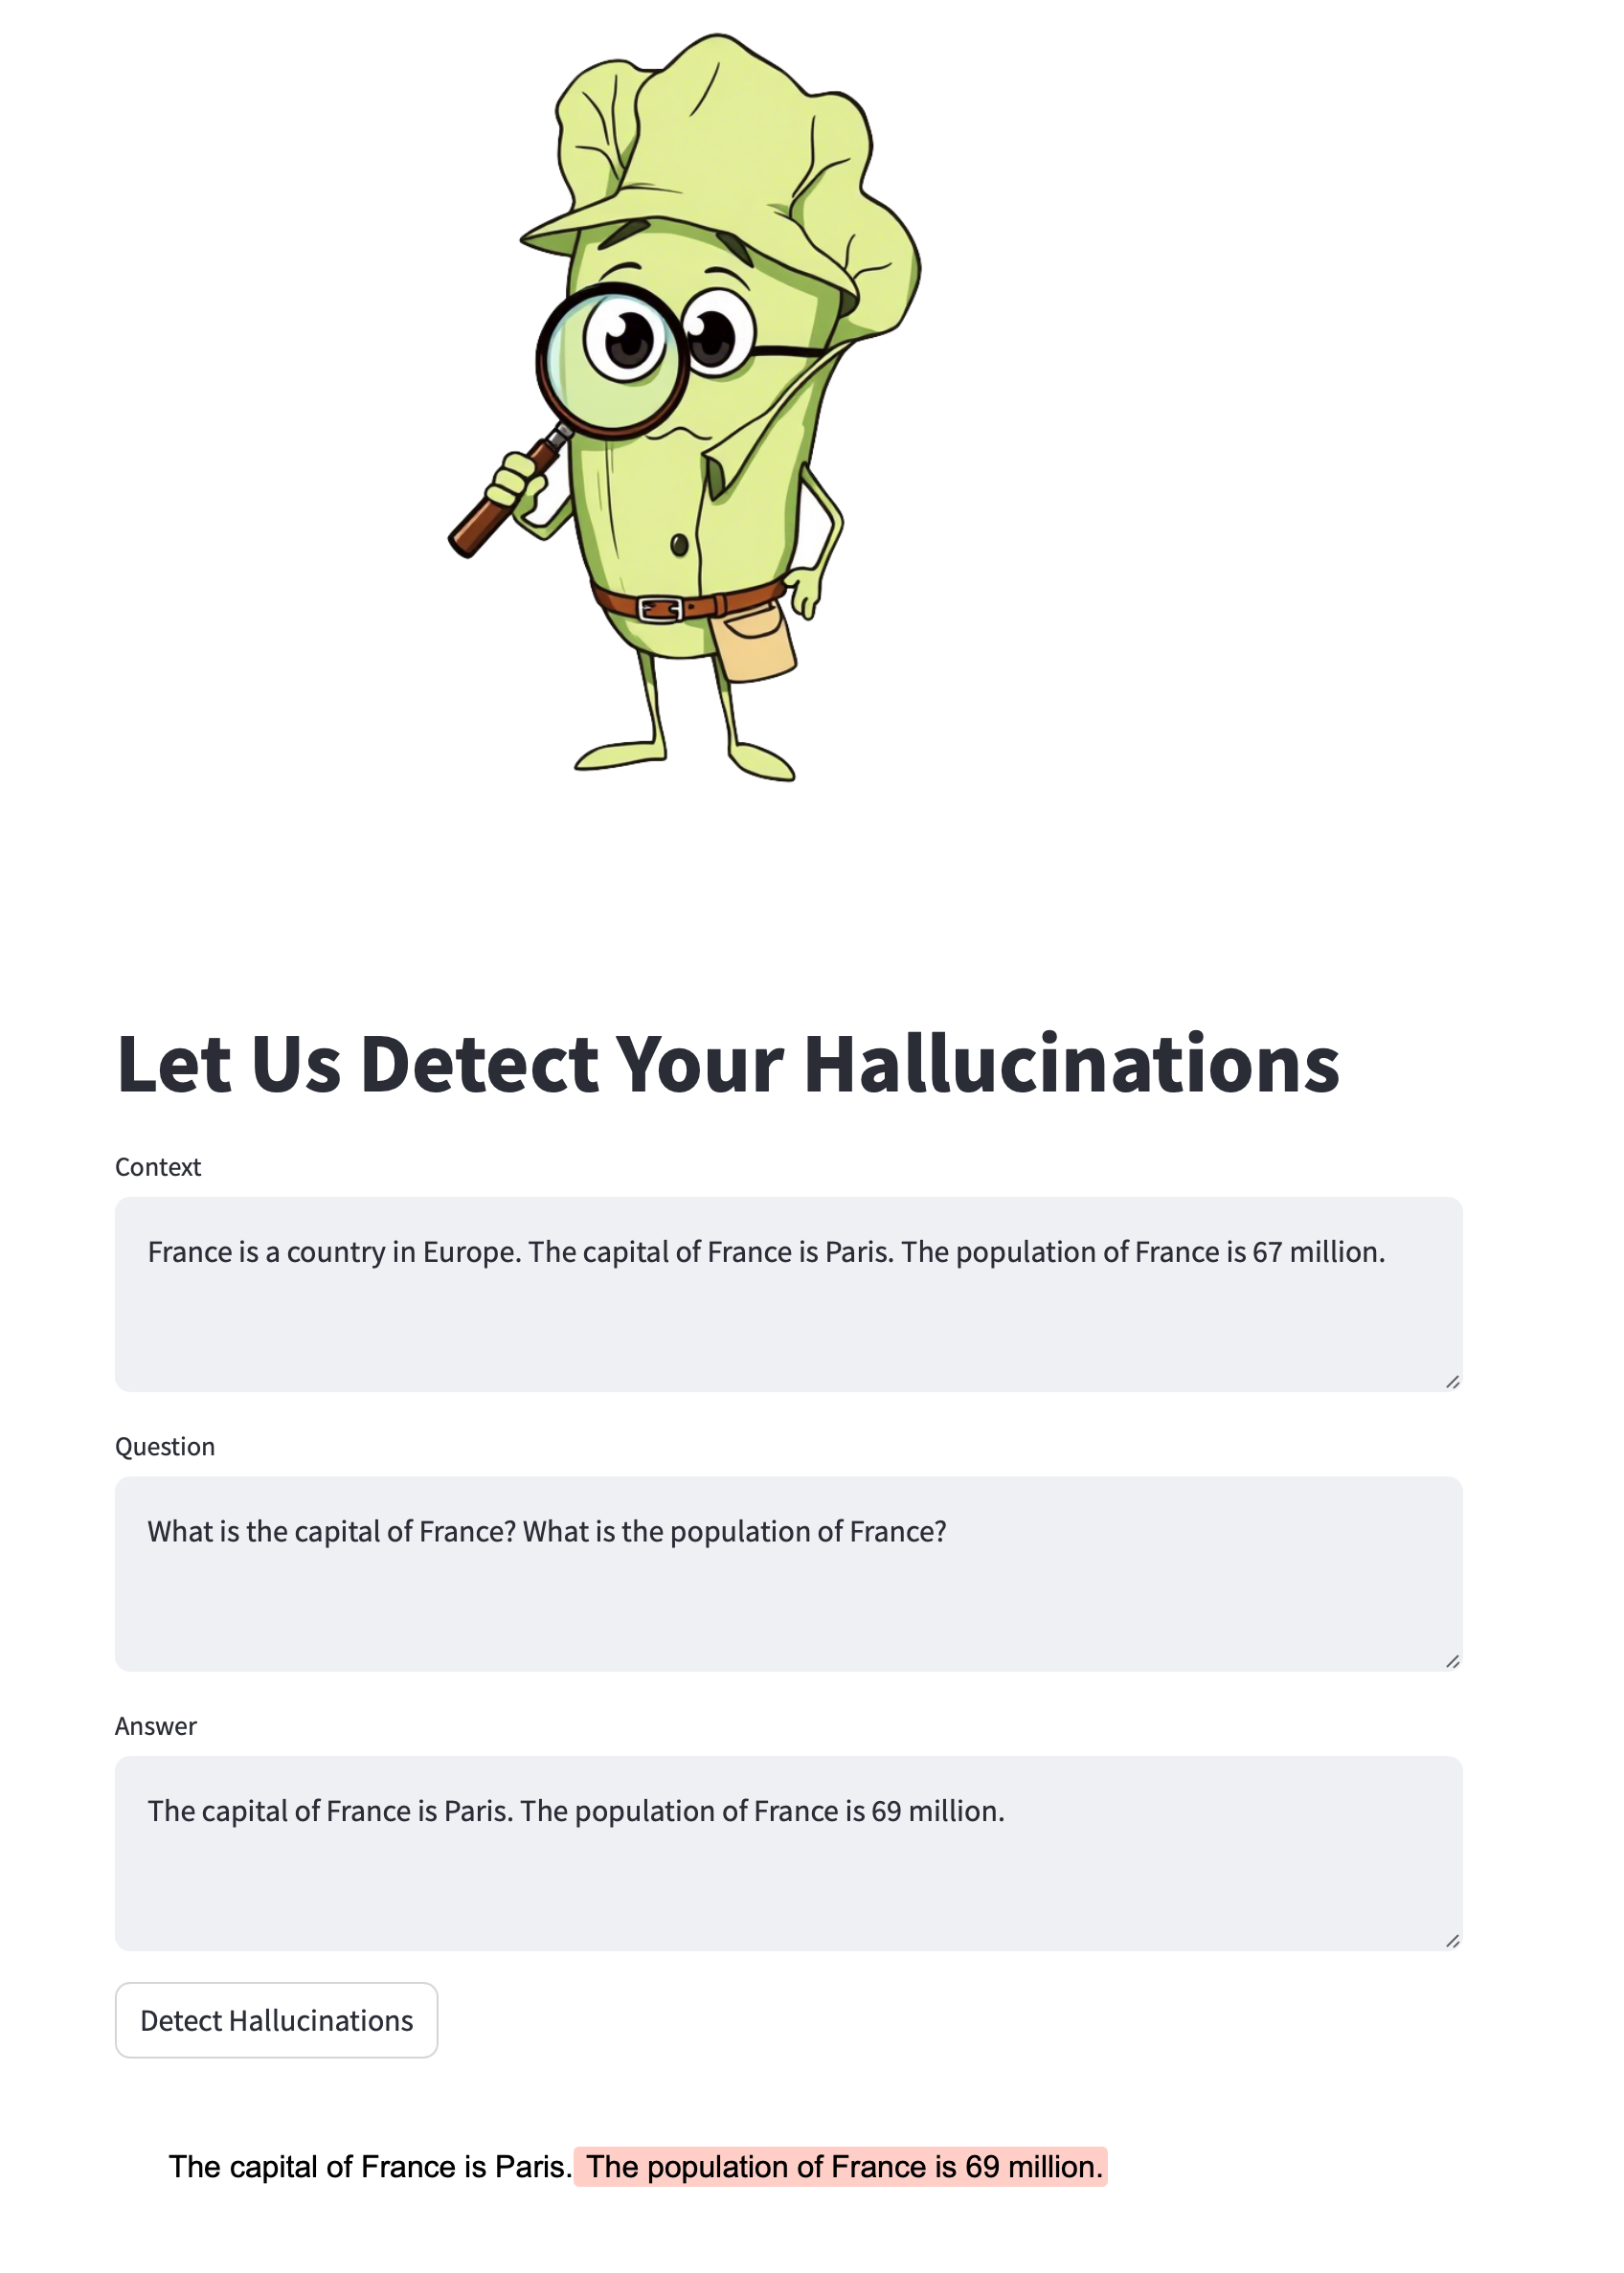
Fig. 2. Streamlit으로 만든 웹 데모. question, context, answer를 입력하면 hallucination으로 판정된 span을 강조해서 보여준다.출처: Kovács & Recski, arXiv 2025 (CC BY 4.0) (논문 Figure 1)
명시적인 ablation은 없다. 비슷한 역할을 하는 비교는 base와 large 정도다. Table 2와 3에서 대부분 large가 base보다 높아서 모델 크기가 성능에 기여한다는 건 보이지만, 컨텍스트 길이를 바꿔 보는 실험은 없다.
5. 읽으면서 든 의문
첫 번째는 긴 컨텍스트가 정말 성능 차이를 만들었는지다. 논문은 RAGTruth의 길이 통계를 근거로 긴 컨텍스트 모델이 필요하다고 말하고, Luna를 크게 앞선 결과가 그 주장을 받쳐 주는 것처럼 읽힌다. 하지만 LettuceDetect와 Luna는 백본만 다른 게 아니다. LettuceDetect는 RAGTruth 학습셋으로 학습하고 RAGTruth 테스트셋에서 평가했다. 반면 논문 설명에 따르면 Luna는 GPT-4가 라벨을 단 여러 도메인 데이터로 학습했고, NLI 사전학습도 거쳤다. 내 해석으로는 13.8%p 차이 중 얼마가 컨텍스트 길이 덕분이고 얼마가 같은 분포의 데이터로 학습한 덕분인지 이 실험으로는 알 수 없다. 거기다 Luna도 긴 컨텍스트를 다룬다고 소개되어 있어서, 짧은 컨텍스트 때문에 진다는 설명이 더 약해진다.
두 번째는 4,096토큰 제한이다. 논문의 핵심 장점이 ModernBERT의 8k 컨텍스트인데, 실제 학습은 4,096토큰으로 했고 왜 그렇게 했는지는 설명하지 않는다. RAGTruth의 최대 길이가 2,632토큰이라 이 데이터에서는 4,096으로도 충분했을 것 같긴 하다. 그래도 그렇다면 8k라는 장점이 이 논문의 실험에서는 한 번도 쓰이지 않은 셈이다. 개인적으로는 이 논문에서 가장 아쉬운 부분이었다.
세 번째는 수치를 얼마나 믿을 수 있는지다. Table 2와 3에는 반복 실행이나 시드, 신뢰구간이 없다. example-level(Table 2)에서 large 모델이 Llama-2-13B를 앞서는 차이는 전체 F1 기준 0.52%p이고, 과제별로 봐도 2%p 안쪽이다. 이 정도 차이면 시드만 바꿔도 순위가 뒤집힐 수 있다고 생각한다. 그리고 체크포인트를 token-level F1로 골랐다고만 쓰여 있고, 어느 데이터로 골랐는지는 나와 있지 않다. 표 캡션에는 Luna, RAGTruth, RAG-HAT 논문에 나온 모델과 RAGAS, Trulens 같은 평가 프레임워크와 비교했다고만 적혀 있어서, 내가 읽기로는 모든 방법을 같은 조건에서 다시 돌린 것은 아닌 것 같다.
네 번째는 span-level 평가의 재현성이다. RAGTruth 공개 코드에 span-level 평가가 없어서 저자들이 직접 구현했다고 밝힌다(§5). 정직하게 밝힌 점은 좋지만, Table 3의 Llama-2-13B 수치는 RAGTruth 논문의 값을 그대로 옮긴 것으로 보이는데, 그렇다면 LettuceDetect 수치와 정확히 같은 방식으로 계산됐는지 확신하기 어렵다.
다섯 번째는 초록의 숫자 표현이다. 초록은 Luna 대비 "14.8% improvement"라고 하는데, 79.22와 65.4의 절대 차이는 13.82%p이고 상대 개선율로 보면 약 21%다. 어느 쪽으로 계산해도 14.8이 나오지 않는다. "약 30배 작다"도 비교 대상이 분명하지 않다. 396M을 RAG-HAT의 8B와 비교하면 약 20배, Llama-2-13B와 비교하면 약 33배다. 큰 문제는 아니지만 헤드라인 숫자는 정확하게 적어 줬으면 했다.
마지막으로 유형별 분석이 없다. RAGTruth는 네 가지 hallucination 유형을 제공하는데, 이진 문제로 합쳐서 학습하고 평가하다 보니 Subtle Conflict처럼 미묘한 유형을 얼마나 잡는지 알 수 없다. 탐지기를 가져다 쓰는 사람에게는 어떤 종류의 hallucination을 놓치는지가 꽤 중요한 정보라서 아쉬웠다. 후속작인 Beyond Document Grounding은 입력 출처(코드, 도구 출력, 문서)별 결과를 따로 보고하고, RAGTruth의 네 유형 대신 자체 분류(contradiction, unsupported addition, fabricated reference)로 범주까지 맞혀야 하는 점수도 낸다.
6. 정리
설득력 있었던 부분은 분명하다. 같은 RAGTruth 테스트셋 기준으로 프롬프트 기반 방법, 파인튜닝한 LLM, 인코더 기반 방법을 한 표에 놓았을 때, 396M짜리 토큰 분류기가 13B 파인튜닝 모델과 비슷한 example-level F1(79.22 대 78.7)을 내고 span-level에서는 앞섰다. 단일 GPU에서 초당 30~60개를 처리하고, 코드와 모델, 데모를 MIT 라이선스로 모두 공개한 것도 실무적인 가치가 크다.
약점도 분명하다. 핵심 주장인 긴 컨텍스트의 효과를 따로 떼어 보여 주는 실험이 없고, 8k를 강조하면서 실제로는 4k만 썼다. 반복 실행 없이 작은 차이로 순위를 매겼고, span-level 평가는 자체 구현에 의존한다. 그래서 이 논문은 RAGTruth에서는 인코더 하나로 이 정도까지 된다는 것을 보여 주는 강한 베이스라인으로 읽는 게 맞다고 생각한다. ModernBERT의 긴 컨텍스트 때문에 잘 된다는 설명까지 받아들이기에는 근거가 부족하다.
개인적으로 이 논문에서 가져갈 점은, 학습 데이터 분포가 맞는다면 hallucination detection에 꼭 큰 LLM judge가 필요한 건 아니라는 것이다. 다만 저자들도 결론에서 더 많은 데이터셋과 언어로 넓히는 것을 향후 계획으로 적었을 뿐, 다른 데이터에서 결과가 유지되는지는 아직 보이지 않았다.
7. 같이 읽어볼 논문
- Niu et al. (ACL 2024), RAGTruth: A Hallucination Corpus for Developing Trustworthy Retrieval-Augmented Language Models. 이 논문의 학습·평가 데이터셋이고, 비교 대상인 파인튜닝 Llama-2-13B도 여기서 나왔다.
- Warner et al. (2024), Smarter, Better, Faster, Longer: A Modern Bidirectional Encoder for Fast, Memory Efficient, and Long Context Finetuning and Inference. 백본인 ModernBERT 논문으로, RoPE를 쓰고 local attention과 global attention을 번갈아 쌓는 구조가 나온다.
- Belyi et al. (COLING 2025 Industry Track), Luna: A Lightweight Evaluation Model to Catch Language Model Hallucinations with High Accuracy and Low Cost. 구조가 가장 비슷한 DeBERTa 기반 선행 연구라서 학습 데이터와 설정이 어떻게 다른지 직접 비교해 보기 좋다.
- Song et al. (EMNLP 2024 Industry Track), RAG-HAT: A Hallucination-Aware Tuning Pipeline for LLM in Retrieval-Augmented Generation. DPO로 학습한 Llama-3-8B로 RAGTruth example-level F1 83.9를 기록했고, Table 2의 example-level 비교에서 이 논문이 넘지 못한 유일한 모델이다.
- Kovács et al. (arXiv 2026), Beyond Document Grounding: Span-Level Hallucination Detection over Code, Tool Output, and Documents. 같은 그룹(KR Labs)의 후속작으로, 탐지 대상을 코드와 도구 출력까지 넓혔고 입력 출처별 결과도 보고한다.