LLMs cannot find reasoning errors, but can correct them given the error location
self-correction 실패의 원인이 교정이 아니라 오류 위치 탐지 능력 부족임을 BIG-Bench Mistake 데이터셋과 백트래킹 실험으로 규명
Huang et al.의 "Large Language Models Cannot Self-Correct Reasoning Yet"을 읽은 뒤 이어서 읽은 논문이다. Huang et al.은 LLM이 외부 피드백 없이 자기 추론을 고치려 하면 오히려 성능이 떨어진다는 걸 보여줬는데, 탐지와 교정 중 어느 쪽이 문제인지는 따로 나눠 보지 않았다. 오류를 못 찾아서 그런 건지, 찾고도 못 고쳐서 그런 건지가 궁금했는데 이 논문이 그 질문을 실험으로 나눠서 확인한다. Cambridge와 Google Research가 함께 쓴 논문이고, 실험에 쓴 BIG-Bench Mistake 데이터셋도 같이 공개했다.
- 저자: Gladys Tyen, Hassan Mansoor, Victor Cărbune, Peter Chen, Tony Mak
- 게재: Findings of ACL 2024 (arXiv 2311.08516)
- 코드·데이터: WHGTyen/BIG-Bench-Mistake
0. 한 줄 요약
LLM이 self-correction에 실패하는 건 고치는 능력이 모자라서가 아니라 오류가 어디 있는지 찾지 못해서라는 것을, 오류 탐지와 교정을 따로 떼어 측정해서 보여준 논문이다.
1. 문제 정의
Huang et al.(2023)에 따르면 LLM에게 외부 피드백 없이 추론 오류를 고치게 하면, 맞는 답을 틀린 답으로 바꾸는 경우가 많아서 전체 성능이 오히려 떨어진다. 그런데 기존 연구는 대체로 self-correction을 한 덩어리로 다뤄서, 이 실패가 오류를 찾는 단계에서 생기는지 고치는 단계에서 생기는지는 따로 나눠 보지 않았다.
저자들은 self-correction을 두 단계로 나눈다. 하나는 mistake finding, 즉 추론 과정에서 어디가 틀렸는지 찾는 단계이고, 다른 하나는 output correction, 즉 찾은 오류를 실제로 고치는 단계다. 그리고 단어를 알파벳순으로 정렬하거나 Dyck 언어의 괄호 짝을 맞추는 것처럼 답이 분명하고 애매할 게 없는 과제에서조차 최신 LLM이 오류 위치를 잘 찾지 못한다는 걸 보여준다.
2. 기존 방법들의 한계
논문이 짚는 기존 연구는 세 갈래로 볼 수 있다.
첫째는 RCI(Kim et al., 2023)와 Reflexion(Shinn et al., 2023)이다. 이 방법들은 정답 여부를 신호로 써서 self-correction 루프를 언제 멈출지 정한다. 결국 오류를 찾는 일을 LLM이 아니라 정답 라벨이 해주는 셈이다. Huang et al.이 다시 검증하면서 지적한 내용을 이 논문도 그대로 가져온다.
둘째는 Self-Refine(Madaan et al., 2023)이다. 수학 데이터셋에서 이 한계가 처음 드러났고, Huang et al.이 데이터셋 2개에서 다시 확인했다.
셋째는 Pan et al.(2023)의 서베이처럼 self-correction을 하나의 과정으로 다뤄 온 시각이다. 저자들은 "While previous work typically present self-correction as a single process, we divide it into mistake finding and output correction"이라고 쓰면서, 탐지와 교정을 나누지 않고 본 것 자체가 문제였다고 본다.
세 갈래 모두 새 실험을 한 게 아니라 기존 논문을 인용하고 다시 정리한 비판이다. 이 논문이 새로 한 일은 두 단계를 나눠서 각각 직접 재 본 것이다.
3. 방법
새로운 아이디어는 하나뿐이다. self-correction을 mistake finding과 output correction으로 나누고 각각 따로 측정하는 것이다. 데이터셋, 프롬프팅 방식, backtracking, 분류기는 모두 이 두 능력을 재기 위한 도구라고 보면 된다.
먼저 데이터셋이다. BIG-Bench Mistake는 PaLM 2 Unicorn이 3-shot CoT, temperature 0으로 생성한 trace 2,186개에 첫 번째 논리 오류가 몇 번째 단계에 있는지 표시한 데이터셋이다. 과제는 word sorting, tracking shuffled objects, logical deduction, multistep arithmetic, Dyck languages 다섯 가지다. Dyck languages를 뺀 네 과제는 trace마다 최소 3명이 주석을 달았고, Krippendorff's α가 0.979~0.998로 주석자들끼리 거의 완벽하게 일치했다. Dyck languages는 패턴 매칭으로 자동 주석을 달았다.
여기서 accuracy_mis와 accuracy_ans를 구분해서 쓰는 점도 눈여겨볼 만하다. 앞의 것은 trace에 논리 오류가 없는지, 뒤의 것은 최종 답이 맞는지를 뜻한다. 최종 답은 맞았는데 중간에 오류가 있는 trace도 있을 수 있어서 둘을 나눠야 한다.
탐지 실험에서는 모델에게 trace를 주고 첫 오류가 몇 번째 단계인지, 아니면 오류가 없는지 묻는다. 묻는 방식은 세 가지다. direct trace-level은 trace 전체를 보고 위치 하나만 답하게 한다. direct step-level은 단계마다 오류인지 Yes/No로 답하게 한다. CoT step-level은 단계마다 CoT로 따져 본 뒤에 Yes/No를 답하게 한다. 모두 3-shot이다.
교정 실험에는 backtracking을 쓴다.
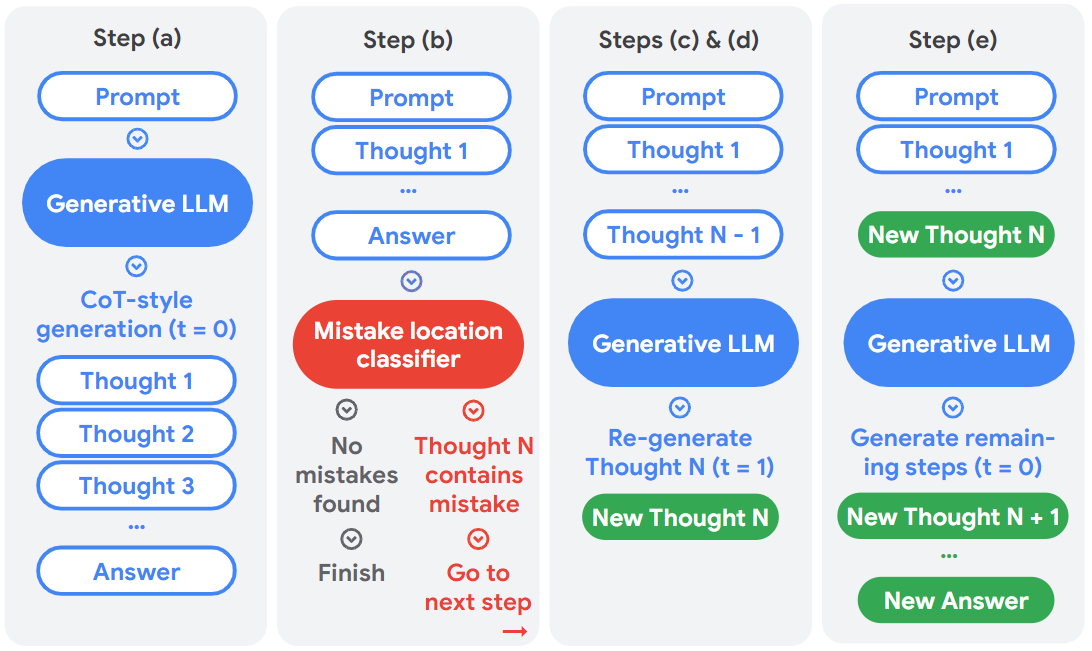
Fig. 1. backtracking 방법(논문 Figure 2). 오류 위치를 받으면 그 단계만 높은 temperature로 다시 생성하고, 이후 단계는 temperature 0으로 이어서 생성한다.출처: Tyen et al., Findings of ACL 2024 (CC BY 4.0)
순서는 이렇다. 먼저 모델이 temperature 0으로 처음 trace를 만든다. 다음으로 오류 위치를 정하는데, §4에서는 사람이 단 라벨을 쓰고 §5에서는 학습한 분류기를 쓴다. 오류가 있으면 그 단계를 temperature 1로 다시 생성하는데, 원래와 다른 단계가 나올 때까지 최대 8번 시도한다. 그다음 나머지 단계는 다시 temperature 0으로 이어서 생성하고 최종 답을 비교한다. 단계는 줄바꿈을 정지 토큰으로 써서 하나씩 생성한다.
위치 정보가 없으면 backtracking은 아예 할 수 없다. 그래서 저자들은 무작위 위치에서 backtracking하는 random location 조건을 대조군으로 같이 돌렸다. 진짜 위치를 줬을 때 무작위 위치보다 이득이 훨씬 크다면, 모델의 교정 능력이 위치 정보에 실제로 반응한다고 볼 수 있다. 사실상 이 실험의 ablation 역할을 한다.
교정 실험에서 짚고 넘어갈 전제가 있다. §4의 backtracking은 사람이 단 정답 위치를 그대로 쓴다. 저자들도 §5 도입부에서 "these experimental results are based on oracle labels, which are typically not available in downstream tasks"라고 직접 밝힌다. 그래서 §5에서는 이 라벨 대신 쓸 수 있는 것을 두 가지 방향으로 찾는다. 하나는 분류기 정확도가 얼마면 충분한지 보는 시뮬레이션이다. 정답 라벨을 X% 확률로 쓰고 나머지는 무작위 위치로 바꿔서, 정확도가 X%인 분류기를 흉내 낸다. 다른 하나는 실제로 작은 분류기를 학습시켜 보는 것이다. PaLM 2 Otter를 네 과제로 파인튜닝하고 남은 한 과제에서 평가했다(2만 step, batch 32, lr 1e-5).
4. 실험 결과
탐지 실험에는 GPT-4-Turbo, GPT-4, GPT-3.5-Turbo, Gemini Pro, PaLM 2 Unicorn 다섯 모델을 썼다. 결과는 꽤 충격적이다. 다섯 과제 평균으로 가장 잘한 조합인 GPT-4의 direct step-level도 52.87%에 그쳤다(Table 4). 사람은 전문 지식 없이도 서로 높은 합의도로 찾아내는 오류를(Table 3), 최고 모델도 절반 정도밖에 못 찾는다는 뜻이다. GPT-4-Turbo와 Gemini Pro는 비용과 사용량 제한 때문에 일부 셀이 비어 있다.
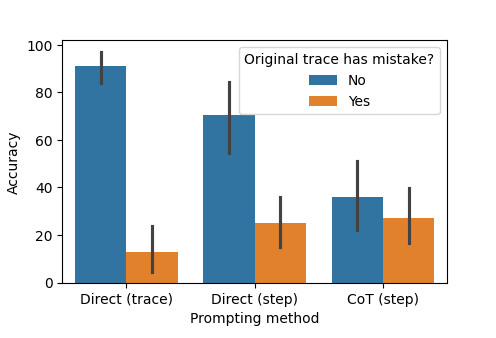
Fig. 2. 프롬프팅 방식별 오류 위치 정확도(논문 Figure 1). 파란 막대는 오류가 없는 trace에서 오류가 없다고 맞힌 비율이고, 주황 막대는 오류가 있는 trace에서 정확한 위치를 맞힌 비율이다. GPT-4-Turbo와 Gemini Pro는 결과가 다 있지 않아 빠져 있다.출처: Tyen et al., Findings of ACL 2024 (CC BY 4.0)
Fig. 2에서는 trade-off가 보인다. direct trace-level에서 CoT step-level로 갈수록 오류가 없는 trace에서의 정확도가 크게 떨어진다. 저자들은 그 이유를 생성 횟수로 추정한다. 단계마다 따로 묻고 단계마다 여러 문장을 생성하게 하면 호출마다 오류를 찾아낼 확률이 쌓여서, 모델이 어딘가에 오류가 있다고 지나치게 자주 판정하게 된다는 것이다. 꼼꼼하게 검토하라고 시킬수록 멀쩡한 trace까지 의심하는 셈이라 흥미로웠다.
저자들은 오류 탐지 결과로 최종 답이 맞는지 판정할 수 있는지도 확인했다(§3.3, Table 5). 모든 trace를 오답으로 찍는 baseline의 가중 F1이 78이다. GPT-4와 GPT-4-Turbo는 이 값을 넘는 경우가 꽤 많았지만, 작은 모델들은 대부분 baseline에 못 미쳤다. 저자들은 오류를 찾게 하는 방식이 최종 답의 정오를 판정하는 데는 좋은 전략이 아닐 가능성이 크다고 결론 내린다.
교정 실험은 분위기가 다르다. 정답 위치를 주고 backtracking하면 무작위 위치를 줄 때보다 일관되게 결과가 좋았다(Table 6). word sorting을 예로 들면, 정답 위치로 backtracking했을 때 원래 맞았던 trace의 정확도는 11.11%p 떨어지고 원래 틀렸던 trace의 정확도는 23.53%p 올랐다. random location에서는 각각 −15.56%p와 +11.76%p라서, 얻는 것보다 잃는 게 더 많다.
개수로 바꿔 보면 감이 좀 온다. word sorting 300개 중 원래 맞았던 trace는 45개, 틀렸던 trace는 255개다. 그러니 맞았던 것 중 약 5개가 틀리게 바뀌고, 틀렸던 것 중 약 60개가 맞게 바뀐다. 300개 중 약 55개, 대략 18%p를 순수하게 얻는 셈이다. 가장 효과가 컸던 과제는 tracking shuffled objects로, 맞았던 trace에서 −6.67%p, 틀렸던 trace에서 +43.92%p였다.
저자들은 이 숫자를 그대로 믿으면 안 된다는 것도 직접 계산해서 보여준다(§4.2). tracking shuffled objects의 원래 정확도가 50%라면 backtracking 후 68.6%가 되지만, 원래 정확도가 99%라면 오히려 92.8%로 떨어진다. 원래 맞았던 trace가 많을수록 망가뜨릴 대상도 많아지기 때문에, backtracking이 얼마나 도움이 될지는 원래 정확도에 크게 달려 있다. 데이터셋이 오답 85%, 정답 15%로 구성돼 있다는 걸 생각하면 꼭 기억해 둘 부분이다.
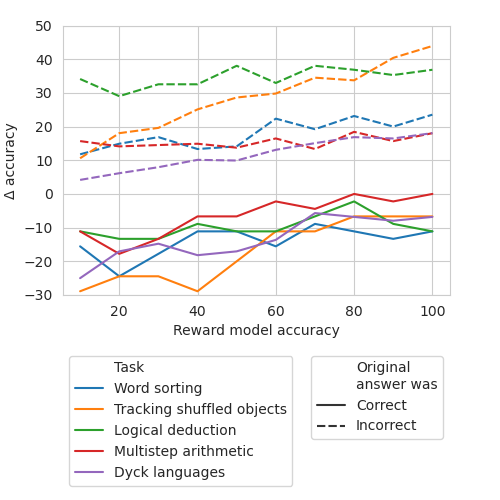
Fig. 3. 시뮬레이션한 분류기 정확도가 올라갈 때 과제별 Δaccuracy✓(원래 맞았던 trace의 변화)와 Δaccuracy✗(원래 틀렸던 trace의 변화).출처: Tyen et al., Findings of ACL 2024 (CC BY 4.0)
개인적으로 이 논문에서 가장 좋았던 실험이 Fig. 3이다. 분류기 정확도를 0%에서 100%까지 올려 가며 보면, 대부분의 과제에서 정확도 60~70% 부근부터 이득이 손실보다 커지기 시작한다. 손실 쪽은 65% 정도부터 더 늘지 않는다. 라벨이 있느냐 없느냐 둘로만 나누지 않고, 검증기가 어느 정도 정확해야 손해를 안 보는지 문턱을 직접 찾았다는 점에서 의미가 있다. 완벽한 검증기가 아니어도 쓸 수 있다는 얘기다.
실제로 학습한 분류기 결과는 Table 7에 있다. Unicorn보다 훨씬 작은 PaLM 2 Otter가 다섯 과제 중 네 과제에서 3-shot으로 프롬프팅한 PaLM 2 Unicorn보다 오류를 더 잘 찾았다. Dyck languages에서는 10.98%에서 33.57%로 22.59%p나 올랐다. 다만 가장 잘 나온 tracking shuffled objects도 37.67%라서, 앞에서 찾은 60~70% 문턱에는 아직 한참 못 미친다. logical deduction에서는 오히려 3-shot 프롬프팅보다 낮게 나왔다.
5. 읽으면서 든 의문
첫 번째는 탐지와 교정 실험의 모델 구성이 다르다는 점이다. 탐지 실험은 모델 다섯 개를 비교했는데, 교정 실험은 PaLM 2 Unicorn 하나로만 했다. 저자들은 "we specifically use the same model (PaLM 2 Unicorn) to correct the traces it originally generated, to test its ability to self-correct"라고 이유를 댄다. self-correction을 보려면 자기가 만든 trace를 자기가 고쳐야 하니 이해는 된다. 그래도 결과적으로 "탐지는 어렵다"는 여러 모델에서 확인됐지만 "위치만 알면 고칠 수 있다"는 모델 하나에서만 확인됐다. 논문의 두 핵심 주장 사이에 근거의 양이 차이 나는데, 논문은 이 부분을 따로 다루지 않는다. 이 논문에서 가장 아쉬운 부분이었다.
두 번째는 반복 실행이 없다는 점이다. Table 4부터 Table 9까지 시드, 반복 실행, 신뢰구간이 전혀 없다. 특히 backtracking은 다시 생성하는 단계에서 temperature 1로 샘플링하기 때문에 실행할 때마다 결과가 달라질 수 있다. 그런데도 한 번 돌린 결과만 보고했다. Table 6의 Δ값이 얼마나 안정적인지 알 수 없다. Huang et al.의 논문을 읽을 때도 비슷한 아쉬움이 있었는데, 이 계열 연구에서 계속 반복되는 문제라고 생각한다.
세 번째는 표본 크기다. 사람이 주석한 과제는 과제당 300개이고, 그중 정답 trace는 45개뿐이다. 오답과 정답 비율을 85:15로 맞춰서 일부러 만든 구성이다. 저자들도 §2.1.1에서 이 편향을 밝히고, 결과를 원래 맞았던 trace와 틀렸던 trace로 나눠서 보고하는 식으로 성실하게 대응했다. 그래도 Δaccuracy✓는 45개짜리 표본에서 나온 숫자라서, 몇 개만 바뀌어도 값이 크게 흔들린다.
네 번째는 과제가 실제 응용과 거리가 멀다는 점이다. 다섯 과제 모두 애매함을 줄이려고 고른 인위적인 과제라는 걸 저자들도 Limitations에서 인정한다. 오류 위치를 객관적으로 정하려면 어쩔 수 없는 선택이지만, 오류의 경계가 흐릿한 실제 추론 문제에서도 같은 결론이 나올지는 이 논문만으로는 알 수 없다.
마지막은 자기 평가 편향이다. 데이터셋의 trace를 PaLM 2 Unicorn이 만들었고 정답 여부를 기준으로 표본을 골랐기 때문에, PaLM 2 Unicorn에게 직접 오류를 찾게 하면 결과가 치우칠 수 있다. 저자들은 각주 6에서 이걸 직접 밝히고, Table 4에서도 PaLM 2 Unicorn의 탐지 성능을 따로 내세우지 않는다. 의문이라기보다는 저자들이 정직하게 처리했다고 느낀 부분이다.
그 밖에 좋았던 점도 많다. 사람이 주석한 위치를 쓴다는 한계를 저자들이 숨기지 않았고, §5 전체를 그 라벨을 어떻게 대체할지에 썼다. 데이터셋을 새로 만들었으니 벤치마크 오염 걱정도 없다. 프롬프트 전문, 주석 지침, 데이터셋을 모두 공개한 것도 좋다.
6. 정리
이 논문이 설득력 있는 건 두 결과를 나란히 놓았기 때문이다. 최고 모델도 오류 위치를 52.87%밖에 못 찾는다는 Table 4, 그리고 위치만 알려주면 무작위 위치보다 일관되게 더 잘 고친다는 Table 6을 같이 보면, self-correction의 병목이 탐지라는 주장을 숫자로 직접 확인할 수 있다. 여기에 Fig. 3의 문턱 실험까지 더해서, 검증기가 대략 60~70% 정확도면 backtracking으로 손해를 보지 않는다는 실용적인 기준까지 제시했다.
약점도 분명하다. 교정 실험은 모델 하나로 한 번씩만 돌렸고, 과제는 인위적이며, 정답 trace 표본은 작다. 그래서 "위치만 알면 고칠 수 있다"는 쪽 주장은 "탐지가 어렵다"는 쪽보다 근거가 약하다. 그렇다고 병목이 탐지에 있다는 결론의 방향까지 흔들릴 정도는 아니라고 본다.
이 논문에서 하나 가져간다면, 실패한 과정을 단계별로 쪼개서 어느 단계가 문제인지 따로 재 봐야 한다는 점이다. self-correction이 안 된다는 결론은 Huang et al.과 같지만, 원인을 찾는 데서 한 걸음 더 나아갔기 때문에 다음 연구가 어디에 집중해야 하는지도 분명해졌다. 결국 좋은 검증기를 만드는 문제로 돌아온다.
7. 같이 읽어볼 논문
- Huang et al. (ICLR 2024), Large Language Models Cannot Self-Correct Reasoning Yet. 이 논문이 원인을 파고든 출발점이다. 외부 피드백 없는 self-correction이 오히려 성능을 떨어뜨린다는 걸 보였다.
- Lightman et al. (2023), Let's Verify Step by Step. 추론 단계마다 사람이 라벨을 단 PRM800K를 만든 논문으로, 이 논문도 §6.1에서 직접 비교한다.
- Weng et al. (Findings of EMNLP 2023), Large Language Models are Better Reasoners with Self-Verification. 생성하는 도중에 피드백을 반영하는 방향의 연구로, 이 논문이 §6.2에서 대안으로 소개한다.
- Wei et al. (NeurIPS 2022), Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. CoT 프롬프팅을 제안한 논문이다. 이 논문이 trace를 한 단계씩 나눠 생성한 방식은 ReAct(Yao et al., 2022)를 따른 것이다.