Large Language Models Cannot Self-Correct Reasoning Yet
RCI·Reflexion·Self-Refine·Multi-Agent Debate의 개선이 오라클 라벨·예산 불공정·프롬프트 결함에서 왔음을 재현 실험으로 반박
Reflexion, Self-Refine 같은 self-correction 논문을 읽고 나서 이 논문을 읽었다. 그 논문들은 LLM이 자기 답을 다시 보고 고치면 성능이 오른다고 보고한다. 그런데 읽는 동안 계속 같은 의문이 남았다. 스스로 틀린 걸 알아채고 고칠 수 있는 모델이라면 왜 처음부터 맞는 답을 내지 못할까. Google DeepMind와 UIUC 연구진의 이 논문은 바로 그 의문을 붙잡고 기존 실험을 하나씩 다시 돌려 본다.
새로운 방법을 내놓는 논문이 아니다. 기존 결과를 재현하고 반박하는 논문이다. 그래서 무엇을 제안했는지보다 실험 조건을 어떻게 맞췄는지를 따라가며 읽는 게 중요하다.
- 저자: Jie Huang, Xinyun Chen, Swaroop Mishra, Huaixiu Steven Zheng, Adams Wei Yu, Xinying Song, Denny Zhou (Google DeepMind, University of Illinois at Urbana-Champaign)
- 게재: ICLR 2024
- 원문: arXiv:2310.01798
- 코드: 공개 저장소는 없고, 직접 만든 프롬프트는 Appendix A에 전부 실려 있다.
0. 한 줄 요약
RCI, Reflexion, Self-Refine, Multi-Agent Debate가 보고한 성능 향상은 정답 라벨을 몰래 쓰거나, 호출 수를 맞추지 않고 비교하거나, 초기 프롬프트를 약하게 짠 데서 나왔다. 외부 피드백 없이 모델 혼자 답을 고치게 하면 추론 과제에서는 오히려 성능이 떨어진다는 것을 같은 벤치마크와 같은 모델로 직접 보여준 논문이다.
1. 문제 정의
self-correction은 LLM이 자기 답을 비평하고 고치게 해서 성능을 올리는 방법이다. Self-Refine, Reflexion, RCI 등이 연달아 나오면서 유망한 방향으로 떠올랐다. 저자들은 여기서 근본적인 역설을 짚는다. LLM에게 자기 답을 고치는 능력이 있다면 왜 처음부터 정답을 내놓지 않는가.
실제 서비스에서는 답이 맞았는지 알려주는 외부 피드백이 대개 없다. 그래서 이 논문은 intrinsic self-correction만 다룬다. 정답 라벨이나 도구, 사람의 피드백 없이 모델이 자기 능력만으로 답을 다시 보고 고치는 설정이다. 질문은 하나다. 외부 도움 없이 LLM이 자기 추론 오류를 스스로 찾아서 고칠 수 있는가.
2. 기존 방법들의 한계
논문 Table 1은 기존 연구의 문제를 세 갈래로 정리한다.
첫째는 RCI와 Reflexion의 oracle label이다. 두 방법은 답이 이미 맞았으면 멈추고 틀렸으면 계속 고치도록 하는데, 언제 멈출지 정하려면 정답을 알고 있어야 한다. 정답을 보고 멈출 시점을 정하는 셈이니, 개선 폭에는 모델의 수정 능력뿐 아니라 정답 정보가 섞여 있다.
둘째는 Multi-Agent Debate의 비교 방식이다. 여러 LLM 인스턴스가 서로의 답을 비평하며 토론하는 방법인데, 호출을 여러 번 쓰면서도 호출 한 번짜리 베이스라인과 비교했다. 같은 호출 수를 쓰는 self-consistency와 비교해야 공정하다는 게 저자들의 주장이다.
셋째는 Self-Refine의 초기 프롬프트다. Constrained Generation 과제에서 "모든 개념을 포함하라"는 요구사항이 피드백 프롬프트에는 암묵적으로 들어 있었지만 초기 생성 프롬프트에는 없었다. 저자들은 원 논문의 프롬프트를 직접 확인해서 이 점을 찾아냈다. 처음부터 같은 요구사항을 알려줬다면 고칠 일 자체가 줄었을 것이다.
이 논문에서 좋았던 점은 세 가지 모두를 말로 주장하는 데 그치지 않고, 같은 벤치마크와 같은 모델로 직접 다시 실험해서 근거를 댔다는 것이다.
3. 방법
핵심 아이디어는 하나다. 기존 self-correction 실험에 숨어 있던 변수, 즉 oracle label, 호출 예산, 프롬프트를 하나씩 통제하면 이득이 사라지거나 뒤집힌다는 것을 대조 실험으로 보여준다. 3장은 oracle label을, 4장은 예산을, 5장은 프롬프트를 통제한다. 같은 아이디어를 세 방향에 적용한 셈이다.
self-correction은 3단계 프롬프팅으로 돌린다. 먼저 모델이 문제를 푼다. 이 첫 답은 그대로 Standard Prompting 베이스라인이 된다. 다음으로 같은 모델에게 이전 답을 검토하고 문제점을 찾게 한다. 마지막으로 찾은 문제점을 반영해 다시 답하게 한다. 이 과정을 최대 2라운드 반복하므로 호출은 최대 5번(초기 1번에 피드백과 재답변 2번씩)이다.
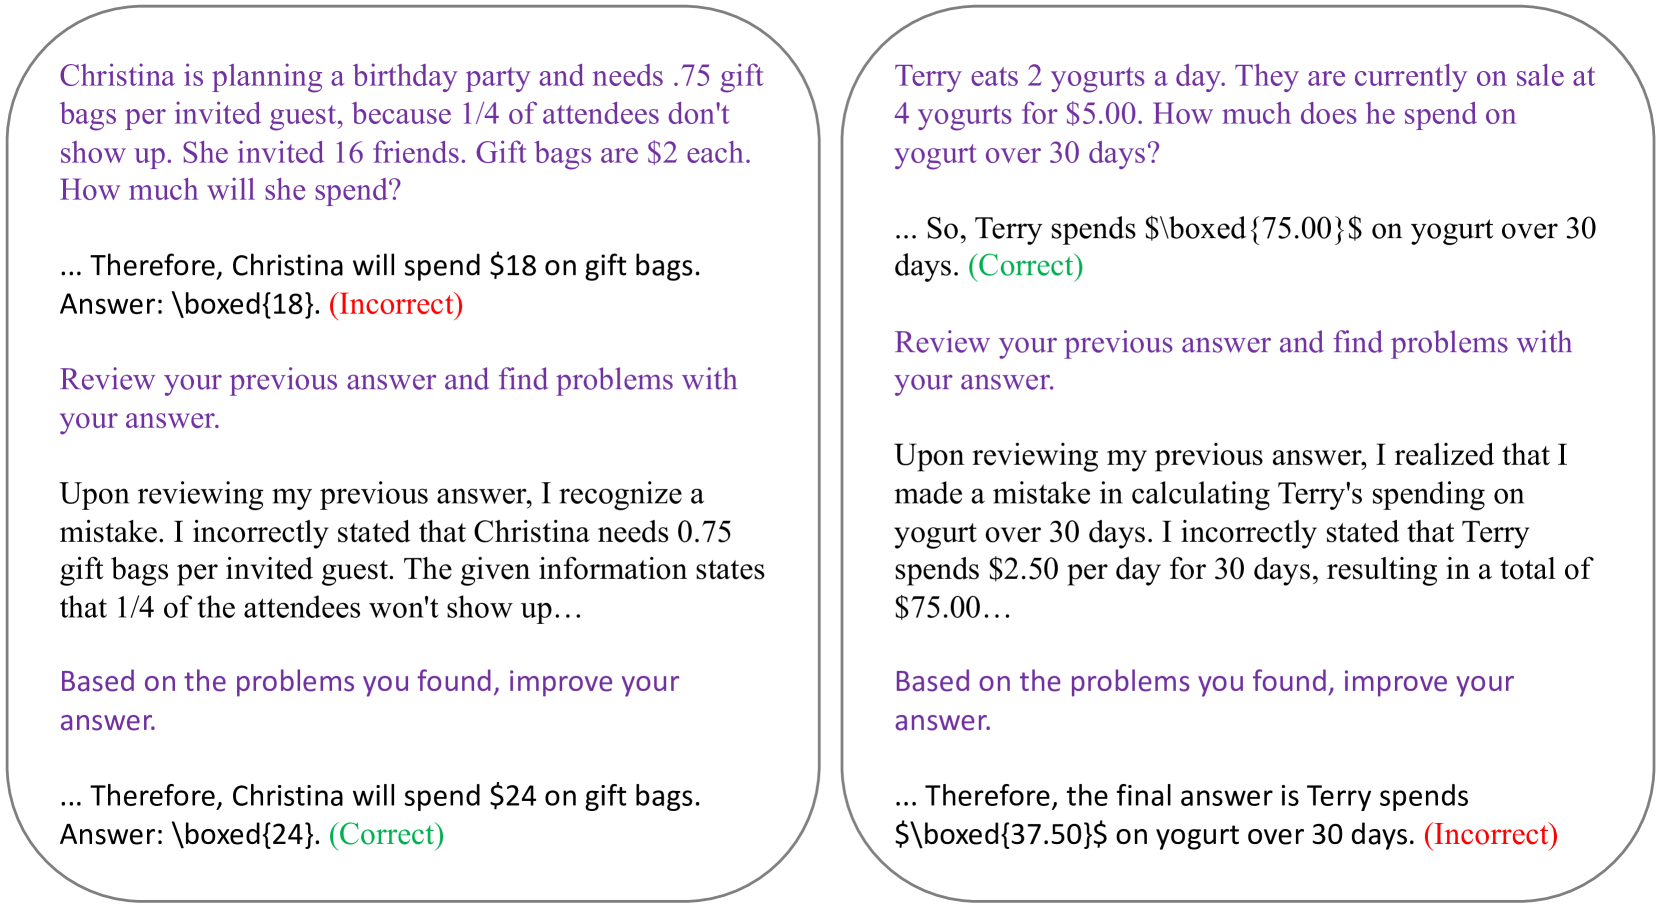
Fig. 2. GPT-3.5로 GSM8K를 푼 예시. 보라색이 "Review your previous answer and find problems with your answer.", "Based on the problems you found, improve your answer." 같은 self-correction 프롬프트다. 왼쪽은 틀린 답 18을 24로 고친 성공 사례이고, 오른쪽은 맞는 답 75.00을 37.50으로 바꿔 버린 실패 사례다.출처: Huang et al., ICLR 2024 (arXiv:2310.01798v2, CC BY 4.0)
오른쪽 예시가 이 논문의 문제의식을 잘 보여준다. 문제점을 찾으라고 하면 모델은 실제로 문제가 없어도 "실수를 발견했다"고 답하고, 맞는 답을 고쳐 버린다.
같은 파이프라인을 두 버전으로 돌린다. oracle 버전은 정답 라벨로 답이 맞았는지 판정해서 맞으면 멈춘다. intrinsic 버전은 라벨 없이 모델이 스스로 멈출지 정한다. 두 버전의 차이는 정답 라벨 하나뿐이다.
oracle 실험에 대해서는 저자들 스스로 비현실적인 가정이라고 못 박는다. 정답을 이미 갖고 있다면 굳이 LLM으로 문제를 풀 이유가 거의 없다는 것이다("there seems to be little reason to deploy LLMs for problem-solving"). 결과표에도 "Self-Correct (Oracle)"라고 따로 이름을 붙였다. 개인적으로는 이렇게 oracle을 명시해 둔 것 자체가 다른 self-correction 논문들과 비교되는 부분이라고 생각한다.
4장의 Multi-Agent Debate와 self-consistency 비교에는 oracle이 필요 없다. 대신 같은 수의 응답을 생성한다는 예산 조건을 맞춘다. 5장의 프롬프트 대조는 과제의 요구사항을 자동으로 채점할 수 있는 형태로 적을 수 있다는 전제 위에 서 있다. 논문에서 직접 다루지는 않지만, 열린 대화의 품질처럼 요구사항을 이렇게 적기 어려운 과제에는 이 대조를 그대로 쓰기 어렵다고 본다.
4. 실험 결과
데이터셋은 세 개다. GSM8K(초등 수학 서술형 1,319문항), CommonSenseQA(dev set 1,221문항, 다지선다 상식 추론), HotpotQA(100문항, closed-book 멀티홉 QA, exact match)로, 모두 기존 self-correction 연구가 oracle을 쓰고 큰 개선을 보고한 데이터셋이다. 모델은 GPT-3.5-Turbo(gpt-3.5-turbo-0613)와 GPT-4를 쓰고, intrinsic 실험에는 GPT-4-Turbo(gpt-4-1106-preview)와 Llama-2-70b-chat을 추가했다. GPT-3.5-Turbo는 평가셋 전체를, 나머지 모델은 비용 때문에 데이터셋마다 200문항(HotpotQA는 100문항)을 무작위로 뽑아 썼다. temperature는 GPT-3.5-Turbo와 GPT-4가 1, GPT-4-Turbo와 Llama-2가 0이다. 서로 다른 decoding 방식에서 평가하려고 일부러 섞었다고 한다. 채점은 세 과제 모두 자동이고, 사람 평가나 LLM-as-judge는 쓰지 않았다.
논문 전체의 핵심 증거는 Table 2(oracle)와 Table 3(intrinsic)을 나란히 놓은 비교다. GPT-4의 GSM8K 정확도는 oracle이 있으면 95.5에서 97.5로 2.0%p 오른다. oracle을 빼면 95.5에서 91.5, 다시 89.0으로 6.5%p 떨어진다. GPT-3.5의 CommonSenseQA는 더 극적이다. oracle이 있으면 75.8에서 89.7로 13.9%p 오르지만, 없으면 75.8에서 38.1, 41.8로 33.9%p 떨어져 거의 반토막이 난다. 다른 조건은 그대로 두고 정답 라벨 하나만 뺐는데 결론이 정반대로 뒤집힌다. intrinsic 설정에서는 모든 모델과 모든 벤치마크에서 정확도가 떨어졌다.
CommonSenseQA 1,221문항에 대입하면 2라운드 self-correction 뒤에 약 415문항을 더 틀리게 된다.
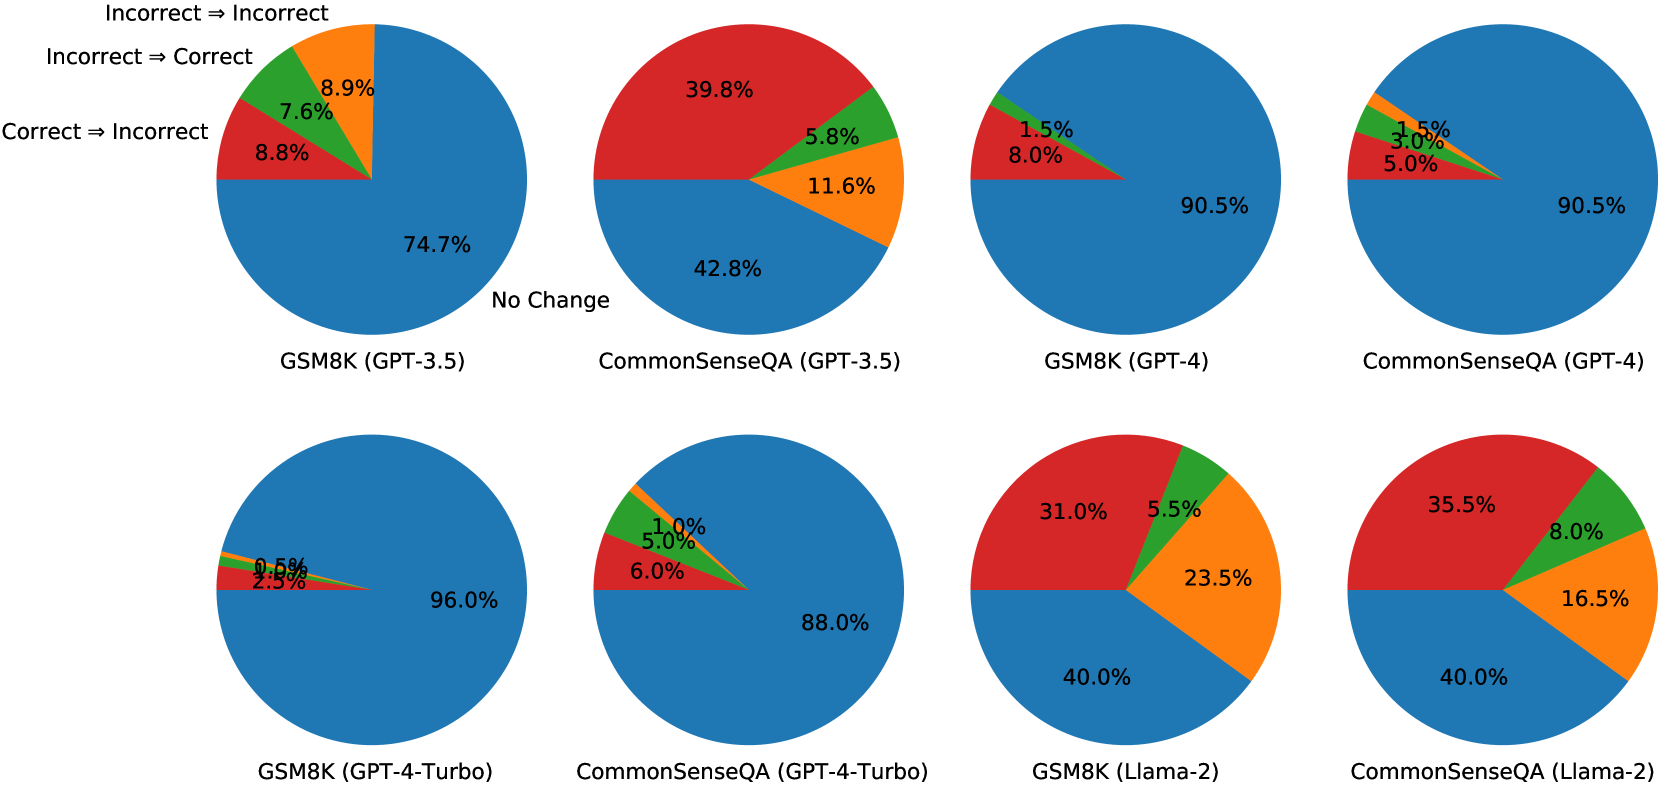
Fig. 1. self-correction을 2라운드 돌린 뒤 답이 어떻게 바뀌었는지를 모델과 데이터셋별로 나눈 그림. 파란색은 답이 바뀌지 않은 경우, 빨간색은 정답이 오답으로, 초록색은 오답이 정답으로, 주황색은 오답이 다른 오답으로 바뀐 경우다.출처: Huang et al., ICLR 2024 (arXiv:2310.01798v2, CC BY 4.0)
GSM8K에서 GPT-3.5는 74.7%의 답을 그대로 두었다. 바뀐 답 중에서는 정답이 오답이 된 경우(8.8%)가 오답이 정답이 된 경우(7.6%)보다 조금 많다. CommonSenseQA에서는 GPT-3.5가 훨씬 자주 답을 바꾸는데, 그림을 보면 정답이 오답으로 바뀐 경우가 39.8%로 가장 크다. 오답이 정답으로 바뀐 경우는 5.8%에 그친다. 저자들은 다지선다 선택지의 오답들이 그럴듯하게 관련돼 있어서 self-correction 프롬프트가 모델을 다른 선택지로 쉽게 끌고 간다고 설명한다. GPT-4와 GPT-4-Turbo는 답을 바꾸지 않은 비율이 88~96%로 첫 답을 잘 유지한다. 반대로 Llama-2는 두 데이터셋 모두 40%만 그대로 두었고, 정답이 오답으로 바뀐 비율이 31.0%(GSM8K), 35.5%(CommonSenseQA)나 된다.
"피드백 프롬프트를 잘못 짜서 그런 것 아니냐"는 반론은 Table 5와 6이 미리 막는다. GPT-4-Turbo와 Llama-2에 피드백 프롬프트 세 가지를 바꿔 넣어 봐도 oracle이 없으면 성능이 꾸준히 떨어지고, 가장 잘 나온 경우도 원래 수준을 크게 넘지 못했다.
Multi-Agent Debate와 self-consistency 비교(Table 7)는 Du et al.의 원 실험이 100문항이었던 것을 GSM8K 1,319문항 전체로 늘려 다시 돌렸다. Multi-Agent Debate(1라운드)는 응답 6개로 83.2를 냈는데, 이는 Du et al.이 비교 기준으로 썼던 응답 3개짜리 self-consistency(82.5)보다 근소하게 높을 뿐이다. 같은 6개 응답을 쓰면 self-consistency가 85.3으로 이미 앞서고, 응답 9개(debate 2라운드)에서는 88.2 대 83.0으로 차이가 더 벌어진다. 9개 기준 5.2%p 차이는 약 69문항이다. 응답 수를 늘려도 debate는 제자리이고, 개선의 상당 부분은 토론보다 여러 답 사이의 일관성에서 나온다는 게 저자들의 해석이다.
Self-Refine 재현(Table 8)도 흥미롭다. 원 논문은 Constrained Generation에서 44.0에서 67.0으로 올랐다고 보고했고, 저자들이 원래 프롬프트로 다시 돌렸을 때는 53.0에서 61.1로 8.1%p 올랐다. 그런데 요구사항을 초기 프롬프트에 적어 주자 첫 답이 81.8이 나왔고, 여기에 self-correction을 하자 오히려 75.1로 떨어졌다. 초기 프롬프트만 제대로 써도 self-correction을 거친 결과보다 낫다는 뜻이다.
5. 읽으면서 든 의문
첫 번째는 분산을 보고하지 않았다는 점이다. Table 2부터 8까지 모두 한 번씩 실행한 결과로 보이고 시드나 신뢰구간이 없다. GPT-3.5와 GPT-4는 temperature 1로 샘플링했는데도 그렇다. oracle 없는 self-correction이 불안정하다는 게 이 논문의 핵심 주장인데, 정작 자기 실험의 분산은 보여주지 않는다는 점이 아쉬웠다.
두 번째는 표본 크기와 그걸 다루는 기준이다. GPT-3.5-Turbo는 평가셋 전체를 썼지만 나머지 세 모델은 200문항, HotpotQA는 100문항만 썼다. 게다가 각주 1에서 HotpotQA는 원 논문의 표본이 100문항으로 작아서 Figure 1의 유형 분석에서 뺀다고 밝힌다. 그러면서도 같은 100문항으로 잰 정확도는 Table 2와 3의 핵심 결과에 그대로 넣었다. 같은 데이터셋을 두 가지 기준으로 다룬 셈이다.
세 번째는 모델 버전이 섞여 있다는 점이다. Table 7의 GSM8K Standard Prompting은 76.7인데 Table 2와 3에서는 75.9다. Table 7은 Du et al.의 실험을 재현하려고 gpt-3.5-turbo-0301을 썼고 Table 2와 3은 gpt-3.5-turbo-0613을 썼으니, 이 버전 차이 때문일 가능성이 높다. 그런데 본문은 이 차이를 따로 짚지 않는다. 같은 "GPT-3.5"라는 이름 아래 서로 다른 스냅샷의 수치가 섞여 있어서, 읽는 사람이 직접 찾아내야 한다.
네 번째는 방법마다 근거의 양이 다르다는 점이다. Table 1은 RCI, Reflexion, Multi-Agent Debate, Self-Refine을 모두 문제가 있는 방법으로 나란히 놓는다. 하지만 RCI와 Reflexion은 벤치마크 세 개로 폭넓게 다시 검증한 반면, Self-Refine은 7개 과제 중 Constrained Generation 하나만으로 비판한다. Self-Refine에 대한 결론은 다른 방법들만큼 탄탄하다고 보기 어렵다.
그래도 좋았던 점이 많다. oracle을 쓴 실험에 스스로 이름을 붙이고 그 가정이 비현실적이라고 먼저 밝혔다. 피드백 프롬프트를 바꿔 가며 예상되는 반론을 미리 막았다. Multi-Agent Debate 비교에서는 원 논문보다 표본을 열 배 넘게 늘렸고, 쓴 프롬프트와 예시 응답도 모두 부록에 공개했다. 저자들도 한계를 인정한다. 이 결론은 추론 과제에만 해당하고, 스타일을 바꾸거나 안전성을 높이는 일처럼 답이 적절한지 LLM이 잘 판단할 수 있는 과제에서는 self-correction이 더 잘 될 수 있다고 한다. 코드 실행 결과나 검색 도구 같은 외부 피드백이 있으면 Self-Debug나 CRITIC처럼 실제로 효과를 보는 방법이 있다는 것도 밝혀 두었다.
6. 정리
이 논문에서 가장 설득력 있는 부분은 Table 2와 3의 비교다. 같은 모델, 같은 벤치마크, 같은 프롬프트에서 oracle 하나만 뺐더니 GPT-4 GSM8K는 +2.0%p에서 −6.5%p로, GPT-3.5 CommonSenseQA는 +13.9%p에서 −33.9%p로 바뀌었다. self-correction의 이득 대부분이 정답 라벨에서 나왔다는 주장은 반박하기 어렵다. 실행을 한 번씩만 한 점, HotpotQA를 두 기준으로 다룬 점, 모델 버전이 섞인 점은 분명한 약점이다. 다만 이 약점들은 수치를 얼마나 믿을 수 있느냐의 문제이고, oracle이 있으면 좋아지고 없으면 나빠진다는 방향까지 바꾸지는 못한다고 본다.
결론만큼 오래 남는 건 6장과 7장에서 정리한 평가 원칙이다. 호출 수가 같은 베이스라인과 비교할 것, oracle을 썼으면 밝힐 것, 초기 프롬프트에도 피드백 프롬프트만큼 공을 들일 것. self-correction 논문뿐 아니라 여러 번 호출하는 추론 기법을 평가할 때도 이 세 가지는 꼭 확인해야겠다고 생각했다.
7. 같이 읽어볼 논문
- Kim et al. (NeurIPS 2023), Language Models can Solve Computer Tasks. RCI를 제안한 논문으로, 이 논문이 oracle label 문제를 지적한 첫 번째 대상이다.
- Shinn et al. (NeurIPS 2023), Reflexion. 역시 oracle label 문제로 비판받은 방법이다.
- Madaan et al. (NeurIPS 2023), Self-Refine. 초기 프롬프트 문제로 비판받은 방법이다. 원 논문의 프롬프트와 이 논문의 Figure 7, 8을 같이 보면 차이가 잘 보인다.
- Wang et al. (ICLR 2023), Self-Consistency Improves Chain of Thought Reasoning in Language Models. 4장에서 Multi-Agent Debate와 비교하는 베이스라인이다.
- Tyen et al. (Findings of ACL 2024), LLMs cannot find reasoning errors, but can correct them given the error location. 문제를 오류를 찾는 단계와 고치는 단계로 나눠서, oracle이 있느냐 없느냐로 나눈 이 논문의 구도를 더 세밀하게 본다.
- Gou et al. (2023), CRITIC. 외부 도구가 있으면 self-correction이 잘 된다는 사례로 이 논문이 직접 인용한다.
- Chen et al. (2023), Teaching Large Language Models to Self-Debug. 코드 실행 결과라는 확실한 검증 신호가 있을 때의 self-correction이다.