ProcessBench: Identifying Process Errors in Mathematical Reasoning
수학 풀이의 첫 오류 단계를 찾는 3,400문항 전문가 라벨 벤치마크. 기존 PRM은 어려운 문제에서 무너지고, 정답 풀이도 어려운 문제에선 과정이 틀린 경우가 많다.
Qwen 팀이 ACL 2025에 낸 ProcessBench 논문을 읽고 정리했다. PRM이나 self-correction 논문을 읽다 보면 "모델이 풀이에서 틀린 곳을 정확히 짚을 수 있는가"라는 질문이 자꾸 나오는데, 이 논문은 바로 그 능력을 재는 벤치마크를 만들었다. 풀이에서 처음 틀린 단계를 찾게 하는 과제는 Tyen et al.의 BIG-Bench Mistake와 같다. 그래서 개인적으로는 이 과제를 경시대회·올림피아드 수준 문제와 전문가 라벨로 키운 후속 작업으로 읽었다. 다만 ProcessBench 논문은 BIG-Bench Mistake를 인용하지 않는다.
- 저자: Chujie Zheng, Zhenru Zhang, Beichen Zhang, Runji Lin, Keming Lu, Bowen Yu, Dayiheng Liu, Jingren Zhou, Junyang Lin (Qwen Team, Alibaba)
- 게재: ACL 2025 Long (2025.acl-long.50), arXiv 2412.06559
- 데이터·코드: Qwen/ProcessBench (Hugging Face), QwenLM/ProcessBench (GitHub)
0. 한 줄 요약
수학 풀이에서 처음 틀린 단계를 찾게 하는 3,400문항짜리 전문가 라벨 벤치마크를 만들었다. 이걸로 평가해 보니 기존 PRM은 어려운 문제로 갈수록 성능이 크게 떨어졌고, 어려운 문제에서는 최종 답을 맞힌 풀이도 중간 과정이 틀린 경우가 많았다.
1. 문제 정의
논문 Figure 2의 예시를 보면 문제가 바로 이해된다. 풀이는 "cos 568° = cos 208°"까지는 제대로 가다가, 2번 단계(0부터 센다)에서 성립하지 않는 항등식 "cos θ = cos(180° − θ)"를 쓴다. 그 뒤 단계들은 잘못된 값을 받아서 계산 자체는 규칙대로 이어 가고, 결국 오답에 도착한다.
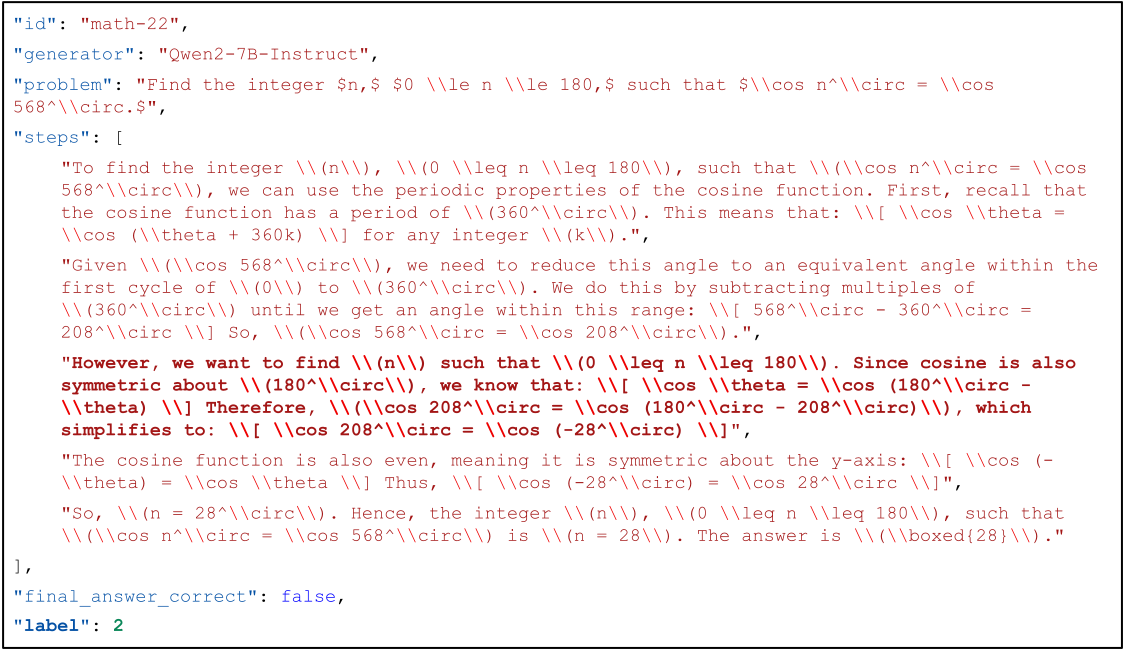
Fig. 1. ProcessBench의 데이터 예시. 라벨 2는 처음 틀린 곳이 2번 단계(0부터 셈)라는 뜻이고, 오류가 없는 풀이의 라벨은 −1이다. (논문 Figure 2)출처: Zheng et al., ACL 2025 (CC BY 4.0)
최종 답만 채점하면 틀렸다는 사실만 알 수 있고, 어디서 틀렸는지는 알 수 없다. 더 곤란한 경우는 답은 맞았는데 과정이 틀린 풀이다. 답만 보는 채점은 이런 풀이를 정답으로 처리한다. 저자들은 §3.3 끝에서 최종 답의 정오만으로 보상을 주는 rule-based RL도 이런 한계가 있다고 지적한다. 개인적으로는 추론 모델 학습에 이런 보상을 많이 쓰는 만큼, 과정을 검증하는 능력이 학습 신호의 질과 바로 이어진다고 생각한다.
과제 정의는 단순하다(§3.1). 문제 와 단계별 풀이 가 주어지면 처음 틀린 단계의 인덱스를 내놓는다. 오류가 없으면 −1이다.
굳이 처음 틀린 단계만 묻는 이유도 논문에 나온다. 첫 오류 뒤의 단계는 틀린 전제 위에 있어서, 그 단계만 떼어 보면 맞는 계산일 수 있다. 예를 들어 이어야 하는데 로 잘못 구했다면, 그다음 단계들은 대수 규칙을 제대로 따르더라도 틀린 값으로 계산하는 셈이라 맞았다고 해야 할지 애매해진다. 개인적으로는 이렇게 범위를 좁혀야 라벨러끼리 합의도 가능해진다고 생각한다.
오류 유형으로는 계산 오류, 논리 오류, 개념 오류, 완결성 오류(필요한 조건이나 근거를 빠뜨린 경우) 네 가지를 예로 든다. 다만 이 네 가지로 한정하지는 않고 라벨러가 전문성에 따라 판단하게 했다. 유형 라벨은 따로 붙이지 않았다.
2. 기존 방법들의 한계
논문이 짚는 문제는 크게 세 가지다.
첫째는 기존 평가셋이다. MathCheck-GSM은 GSM8K로 오류 풀이를 합성해서 만들었고 풀이를 생성한 모델이 하나뿐이다. PRM800K 테스트셋도 MATH 문제에 생성 모델이 하나이고, Table 1은 1단계 테스트셋의 완전한 풀이 90개만 센다. 2단계 테스트셋의 풀이는 모두 첫 오류에서 끝나기 때문이다. CriticBench는 최종 답의 정오만 라벨링해서 단계 라벨이 없다. 이 비교는 Table 1에 정리돼 있는데, 개인적으로는 난이도와 다양성을 별 개수로 매긴 표라서 근거로는 약하다고 본다. 앞에서 말한 BIG-Bench Mistake도 이 표와 참고문헌 어디에도 없다. 과제 정의가 같은 선행 연구가 있으니, 내 생각에 ProcessBench가 새로운 점은 과제가 아니라 난이도, 규모, 전문가 라벨에 있다.
둘째는 PRM을 평가하는 관행이다. 보통은 PRM으로 다른 모델의 풀이 N개 중 하나를 고르게 하는 Best-of-N 성능으로 평가한다. 저자들은 이 방식이 단계 판정 능력을 직접 보지 않고, 결과도 풀이를 생성한 모델에 크게 좌우된다고 지적한다(§4.1). 실험이 아니라 논증으로 제시한 문제다.
셋째는 합성 라벨로 학습한 PRM이다. Math-Shepherd 방식은 어떤 단계 뒤로 풀이를 여러 번 이어서 생성해 보고, 최종 정답에 도달한 비율을 그 단계의 라벨로 쓴다. §4.2는 이 방식에 두 가지 문제가 있다고 본다. 하나는 라벨이 on-policy라서, 즉 풀이를 생성한 모델에 묶여 있어서 다른 모델의 풀이에는 잘 맞지 않는다는 점이다. 다른 하나는 답만 맞고 과정이 틀린 풀이의 단계도 좋은 단계로 라벨링된다는 점이다. 저자들도 이 둘을 "직관적인" 문제라고 표현하는데, 원인을 실험으로 확인한 것은 아니다.
3. 방법
개인적으로는 이 논문의 핵심 기여를 평가셋 하나로 본다. 저자들은 대규모 평가에서 얻은 두 가지 관찰도 기여로 내세우지만, 이 관찰들도 결국 이 평가셋이 있어서 가능했던 결과다. 경시대회·올림피아드 수준 문제를 중심으로 실제 모델이 푼 풀이에, 박사급 전문가 여러 명이 합의한 첫 오류 라벨을 붙였다. 단계 재분할, 정답·오답 균형 샘플링, 다수 합의 절차는 이 라벨을 믿을 수 있게 만들려고 넣은 장치들이고, F1 지표는 한쪽으로 몰아 찍는 모델을 걸러내려는 지표다.
구축 과정(§3.2)은 이렇다. 문제는 GSM8K, MATH, OlympiadBench, Omni-MATH의 테스트셋에서 가져왔고, GSM8K를 뺀 셋은 경시대회나 올림피아드 수준이다. 풀이는 Qwen과 LLaMA 계열 오픈 모델 12개가 생성했다. 모델마다 단계를 나누는 습관이 달라서, 줄바꿈을 모두 지운 뒤 Qwen2.5-72B-Instruct에게 단락을 다시 나누게 했다. 이 과정에서 내용이 바뀐 경우가 0.5% 미만 있었고, 재분할 뒤 최종 답이 달라진 풀이는 버렸다.
그다음 Qwen2.5-72B-Instruct가 참조 답과 비교해 최종 답의 정오를 판정하고, 정답 풀이와 오답 풀이를 나눠서 뽑았다. 라벨러는 수학 박사급 전문가이고 숙련도 시험을 통과해야 했다. 풀이 하나에 처음 3명을 배정하고, 의견이 갈리면 3명이 같은 답을 낼 때까지 사람을 늘렸다. 5명까지 가도 합의가 안 되면 버렸는데, 전체 과정에서 약 30%가 이렇게 버려졌다. 최종 답이 틀렸는데 사람들은 오류가 없다고 판정한 풀이도 버렸고, 이런 경우는 1% 미만이었다. 그렇게 남은 것이 GSM8K 400개, 나머지 세 데이터셋 1,000개씩, 총 3,400문항이다. 최종 답 기준으로는 정답·오답이 GSM8K 200개씩, 나머지 500개씩이 되도록 맞췄다.
라벨 과정에서 눈에 띄는 부분이 하나 있다. 올림피아드 문제는 수학 박사과정생에게도 어려워서, 라벨러가 풀이 방향을 확신하지 못하면 판정이 느려지고 품질도 떨어졌다고 한다. 그래서 원 데이터셋의 참조 풀이와 답을 보여 주되, 모델 풀이를 단계별로 직접 검증하라고 지시했다. 개인적으로는 이 때문에 라벨러가 참조 풀이와 다른 경로로 푼 풀이를 오류로 판정하는 쪽으로 기울 수 있다고 생각한다. 논문은 이 영향을 따로 재지 않았다. 평가받는 모델에게 참조 답을 주지는 않는다. 다만 점수를 내는 Skywork PRM은 테스트셋인 GSM8K 부분집합의 라벨로 임계값을 골랐기 때문에, 이 모델들의 GSM8K 수치에는 정답 라벨 정보가 들어가 있다(5장에서 다시 다룬다).
평가 지표는 오류가 있는 풀이에서의 정확도와 오류가 없는 풀이에서의 정확도를 구한 다음, 둘의 조화평균을 F1으로 쓴다(§4.1). 보통 쓰는 정밀도·재현율 F1과는 다르다.
모든 풀이에 −1을 찍는 모델은 오류 풀이 정확도가 0이라 F1도 0이 된다. 반대로 모든 풀이를 틀렸다고 하는 모델도 높은 점수를 받을 수 없다. 인덱스가 정확히 일치해야 맞힌 것으로 치는지는 논문에 명시돼 있지 않지만, 과제 정의로 보면 정확 일치로 보인다.
평가 대상은 두 종류다. PRM은 단계별 판정에서 처음 "틀림"이 나온 위치를 답으로 쓴다. 점수를 출력하는 Skywork PRM은 임계값으로 맞음과 틀림을 나누는데, 이 임계값은 GSM8K 부분집합에서 F1이 가장 높게 나오는 값으로 정했다. critic model은 범용 LLM에 프롬프트를 줘서 단계별로 검토하게 하고, 처음 틀린 단락의 인덱스를 최종 답으로 쓰게 한다(Appendix E). 따로 학습시키지는 않는다.
실제로 쓰려면 짚어볼 전제도 있다. 개인적으로는 정답 인덱스가 Qwen2.5-72B가 나눈 단락을 기준으로 정해지니, 단계를 다르게 나누는 PRM에는 불리할 수 있다고 생각한다. 그리고 단계 구분이 분명한 풀이를 전제로 하기 때문에, 내 생각에는 o1류 모델처럼 단계 경계가 흐릿한 긴 CoT에는 그대로 적용하기 어려울 것 같다.
4. 실험 결과
PRM은 Math-Shepherd-PRM-7B, RLHFlow의 LLaMA-3.1 기반 PRM 두 개, Skywork의 Qwen2.5-Math 기반 PRM 두 개(1.5B, 7B)를 평가했다. 여기에 저자들이 Qwen2.5-Math-7B-Instruct를 PRM800K로 그냥 fine-tuning한 Qwen2.5-Math-7B-PRM800K를 더했다. ProcessBench와 문제가 겹치는 PRM800K 학습 샘플은 뺐다. critic으로는 오픈 모델 17개, GPT-4o-0806, o1-mini를 썼다. 디코딩 조건은 모델마다 다르다. 오픈 모델은 8번 샘플링해서 다수결, GPT-4o는 greedy 한 번, o1-mini는 API가 디코딩 설정을 지원하지 않아서 샘플 한 번이다. 반복 실행이나 신뢰구간은 보고하지 않았다.
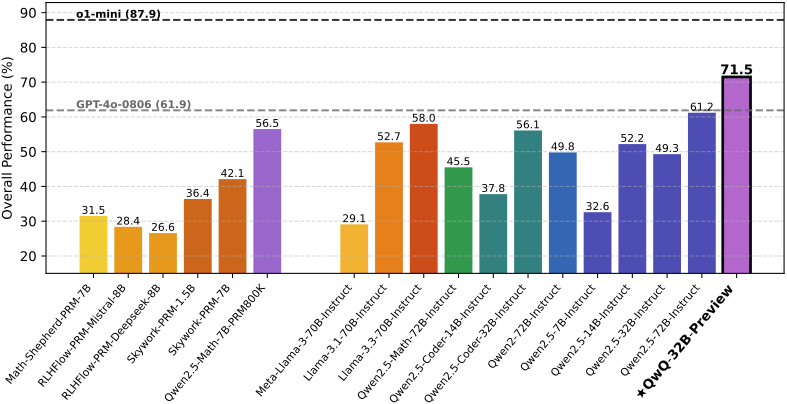
Fig. 2. ProcessBench 평가 결과 요약. 세부 수치는 논문 Table 3에 있다. (논문 Figure 1)출처: Zheng et al., ACL 2025 (CC BY 4.0)
PRM과 critic의 모델별 평균 F1을 한 그림에 모았고, GPT-4o(61.9)와 o1-mini(87.9)는 점선으로 표시했다. 아래에서 부분집합별 숫자를 하나씩 본다.
가장 눈에 띄는 결과는 PRM 성능이 난이도에 따라 급하게 떨어진다는 것이다. 평균 기준으로 기존 PRM 중 가장 좋은 Skywork-PRM-7B는 GSM8K에서 70.8(임계값을 이 부분집합 라벨로 골랐다)이었는데 OlympiadBench에서 22.9, Omni-MATH에서 21.0까지 내려가 평균 42.1이다. Omni-MATH의 오류 풀이 759개 중 Skywork-PRM-7B가 첫 오류 위치를 맞힌 비율은 14.0%다. Omni-MATH에서는 오류 7개 중 6개 정도를 놓친다는 뜻이다. 반면 PRM800K로 학습한 모델은 OlympiadBench 50.7, Omni-MATH 44.3으로 평균 56.5였고, Omni-MATH 오류 풀이 정확도도 29.8%로 두 배 남짓이다.
임계값 탓은 아닌 것 같다. Skywork PRM의 임계값을 부분집합마다 따로 최적화한 상한값(Table 8)도 7B 모델 기준 OlympiadBench 27.1, Omni-MATH 23.1에 그친다.
critic 쪽은 평균 F1이 GPT-4o 61.9, QwQ-32B-Preview 71.5, o1-mini 87.9였다. 이 숫자들을 바탕으로 저자들은 QwQ가 GPT-4o와 경쟁할 만하다고 결론 내리는데, 이 비교에는 문제가 있어서 5장에서 다시 다루겠다. 저자들은 GSM8K·MATH에서 OlympiadBench·Omni-MATH로 넘어가면 모든 모델의 성능이 떨어진다고 쓴다. 다만 표를 보면 Qwen2-7B-Instruct처럼 원래 점수가 매우 낮은 모델 중에는 예외도 있다.
F1이 몰아 찍는 모델을 걸러내는 모습도 표에서 확인된다. Omni-MATH에서 Llama-3.1-8B-Instruct는 오류 풀이 정확도 32.0%, 오류 없는 풀이 정확도 0.8%로 거의 모든 풀이를 틀렸다고 판정했다. Qwen2.5-Coder-7B-Instruct는 0.9%와 98.3%로 거의 모든 풀이를 맞다고 판정했다(Table 7). 둘 다 F1은 2점 안팎이다.
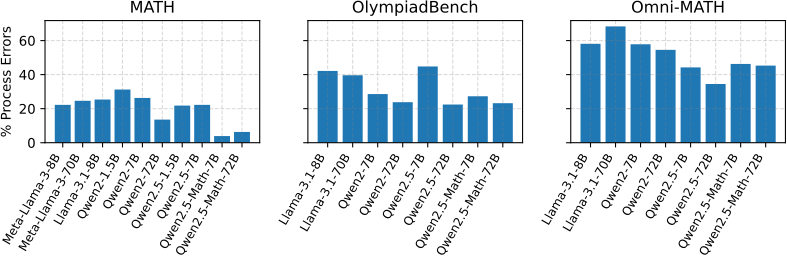
Fig. 3. 생성 모델별, 부분집합별 과정 오류 비율. 최종 답을 맞힌 풀이 가운데 사람이 오류가 있다고 판정한 비율이다. (논문 Figure 4)출처: Zheng et al., ACL 2025 (CC BY 4.0)
개인적으로는 벤치마크 성능보다 데이터 통계가 더 흥미로웠다. 최종 답이 맞은 풀이 중 과정에 오류가 있는 비율은 GSM8K 3.5%, MATH 18.8%, OlympiadBench 32.2%, Omni-MATH 51.8%였다(Table 2). Omni-MATH에서는 정답 풀이 500개 중 259개, 그러니까 절반 정도가 과정상 틀린 풀이였다. 그림을 보면 이 비율이 유독 높은 모델은 없고, 모든 생성 모델에서 문제가 어려울수록 높아진다. 특정 모델만의 문제가 아니라는 얘기다. 저자들은 어려운 문제에서 답을 맞혀도 과정 오류가 더 잦아진다는 증거를 자기들이 아는 한 처음 보였다고 주장한다.
라벨 합의 통계도 같은 경향을 보인다. 오류가 있다고 라벨된 풀이에서 처음 배정된 3명의 의견이 바로 일치한 비율은 GSM8K 66.7%에서 Omni-MATH 47.8%로 떨어진다. Omni-MATH에서 오류가 있다고 라벨된 풀이의 26.6%는 5명까지 가서야 3명이 합의했다. 문제가 어려우면 사람끼리도 오류 위치에 대한 의견이 잘 안 맞는다.
5. 읽으면서 든 의문
첫 번째는 비교 조건이 공정한지다. 초록과 결론은 QwQ-32B-Preview가 GPT-4o와 경쟁할 만하다고 말한다. 그런데 QwQ의 71.5는 8번 샘플링한 다수결 결과이고, GPT-4o의 61.9는 greedy 한 번의 결과다. 부록의 Table 9에서 QwQ의 greedy 결과를 찾아보면 70.9, 56.3, 34.6, 34.6으로 평균이 49.1이다. 같은 greedy 조건이면 GPT-4o보다 12.8 낮고, 다수결이 QwQ 점수를 22.4나 올려 준 셈이다. Qwen2.5-72B-Instruct도 greedy 평균은 58.5로 GPT-4o보다 낮다. 논문의 두 가지 핵심 결론 중 하나가 계산량을 8배 더 쓴 조건에서 나왔다는 점이 이 논문에서 가장 아쉬운 부분이었다. 그래도 greedy 결과를 부록에 다 공개해서 독자가 직접 다시 계산해 볼 수 있다는 점은 좋았다.
두 번째는 합성 라벨이 PRM 실패의 원인이라는 해석이다. PRM800K로 학습한 모델(56.5)과 기존 PRM(26.6~42.1)은 라벨을 어디서 얻었는지만 다른 게 아니다. 기반 모델도, 학습 문제의 분포도, 학습 세부사항도 다르다. 특히 PRM800K는 MATH 문제로 만들어졌기 때문에 ProcessBench의 MATH 부분집합과 같은 분포에서 학습한 셈이다. 겹치는 문제를 빼긴 했지만 분포가 같다는 사실은 그대로다. Skywork PRM도 Qwen2.5-Math 기반이라 기반 모델은 어느 정도 비슷하지만, 학습 데이터를 어떻게 만들었는지는 논문에 나오지 않는다. 저자들은 "현재 데이터 합성 방법이 일반화되는지 의문이 든다"는 정도로 표현하지만, §4.2를 읽으면 원인을 합성 라벨로 보는 것처럼 읽힌다. 그런 주장을 하기에는 다른 변수들을 통제하지 않은 비교다.
세 번째는 임계값을 테스트셋에서 골랐다는 점이다. Skywork PRM의 임계값은 GSM8K 부분집합에서 F1이 최대가 되도록 정했으니, GSM8K 수치는 부분집합별 최적 임계값으로 구한 상한값(Table 6)과 똑같다. 어려운 문제에서 PRM 성능이 떨어진다는 결론은 Table 8로 보면 바뀌지 않는다. 다만 GSM8K에서 Skywork-PRM-7B(70.8)가 critic과 비슷해 보이는 데는 이 유리한 조건이 섞여 있다.
네 번째는 51.8%라는 숫자가 오류를 어떻게 정의하느냐에 얼마나 민감한지다. 완결성 오류, 즉 필요한 근거를 빠뜨린 것도 오류로 치는데, 올림피아드 문제에서 어디까지 엄밀해야 하는지는 라벨러마다 기준이 다를 수 있다. 오류 없음으로 라벨된 풀이에서 3명이 바로 합의한 비율도 Omni-MATH 80.1%, GSM8K 95.9%로 차이가 나지만, 과정 오류 풀이만 따로 본 합의도는 Table 2에 없어서 이 문제를 직접 보여 주지는 못한다. 오류 유형 라벨이 없어서, 51.8% 중 계산·논리 오류가 얼마이고 증명 수준의 엄밀함이 부족했던 경우가 얼마인지 구분할 수 없다. 모델이 답만 맞히고 과정은 틀린다는 강한 해석과, 라벨러가 엄밀한 근거를 요구했다는 약한 해석 중 어느 쪽이 맞는지 이 데이터만으로는 판단하기 어렵다. 앞에서 말한 참조 풀이 제공도 여기에 영향을 줬을 수 있다고 생각한다.
다섯 번째는 데이터가 Qwen 계열에 쏠려 있다는 점이다. 생성 모델 12개 중 8개가 Qwen이고, 단계 재분할과 최종 답 판정도 Qwen2.5-72B-Instruct가 했으며, 오픈 모델 중 가장 좋은 모델로 내세운 것도 QwQ다. 개인적으로는 Qwen critic이 Qwen 풀이 스타일에 익숙해서 유리했을 가능성을 배제할 수 없다고 본다. 논문은 이 부분을 따로 분석하지 않았다. 덧붙여 평가가 수학 한 분야에서만 이루어졌다는 점도 결과를 해석할 때 염두에 둬야 한다.
저자들이 직접 밝힌 한계는 두 가지다(Limitations). 어려운 올림피아드 문제에서는 라벨이 부정확할 수 있다는 점, 그리고 합의 실패로 버린 풀이에 특히 어려운 문제가 섞여 있어서 문제 분포가 치우쳤을 수 있다는 점이다.
그래도 좋은 점이 많은 논문이다. 라벨 합의 절차와 합의도 통계를 그대로 공개했고, F1을 두 정확도의 조화평균으로 정의해서 한쪽으로 몰아 찍는 모델을 걸러냈다. greedy 결과와 부분집합별 최적 임계값 결과까지 부록에 넣어서, 위에서 말한 문제들을 독자가 직접 확인할 수 있게 해 둔 점도 좋았다.
6. 정리
이 논문에서 오래 쓰일 부분은 데이터다. 경시대회·올림피아드 수준 문제를 중심으로 한 실제 모델 풀이 3,400개에 박사급 전문가 3~5명이 합의한 첫 오류 라벨을 붙이고 합의도 통계까지 공개했다. 덕분에 PRM과 critic을 같은 기준으로 바로 비교할 수 있게 됐다. Best-of-N처럼 생성 모델에 좌우되는 간접 평가 대신, 단계를 얼마나 정확히 판정하는지 직접 잴 수 있게 된 것이다.
반면 결론 중 두 개는 근거가 약하다. QwQ가 GPT-4o와 경쟁할 만하다는 결론은 디코딩 조건이 다른 비교에서 나왔다. greedy끼리 비교하면 QwQ(49.1)가 GPT-4o(61.9)보다 낮아서, 이 결론은 QwQ에만 8번 다수결을 적용한 비교에서만 성립한다. 합성 라벨이 PRM 실패의 원인이라는 해석도 기반 모델과 학습 분포를 통제하지 않은 비교에서 나왔다. 다만 벤치마크 논문에서 핵심은 데이터와 측정 방법이고, 그 부분은 탄탄하다.
이 논문에서 하나만 가져간다면 Omni-MATH 정답 풀이의 절반이 과정상 틀렸다는 숫자다. 오류를 어떻게 정의했는지에 따라 정확한 값은 달라질 수 있다. 하지만 어려운 문제일수록 최종 답이 맞았다는 사실만으로 풀이가 맞았다고 보기 어렵다는 점은 분명해 보인다. 답만 보고 보상을 주는 RL이든, 답만 보고 채점하는 평가든 이 점을 고려해야 한다는 생각이 들었다.
7. 같이 읽어볼 논문
- Lightman et al. (2023), Let's Verify Step by Step. PRM800K 데이터셋을 공개하고 PRM 개념을 본격적으로 다룬 논문이다. 이 논문에서 자체 PRM을 학습시킬 때 쓴 데이터도 PRM800K다.
- Wang et al. (ACL 2024), Math-Shepherd: Verify and Reinforce LLMs Step-by-step without Human Annotations. 이 논문이 비판하는 몬테카를로 추정 라벨의 대표적인 방법이다.
- Tyen et al. (Findings of ACL 2024), LLMs cannot find reasoning errors, but can correct them given the error location. 첫 오류 위치를 찾는다는 같은 과제를 먼저 다룬 BIG-Bench Mistake 논문인데, ProcessBench는 이 논문을 인용하지 않는다.
- Zhang et al. (Findings of ACL 2025), The Lessons of Developing Process Reward Models in Mathematical Reasoning. 같은 Qwen 팀의 후속 연구다. PRM 라벨을 몬테카를로 추정으로 만들 때의 문제를 더 깊게 다룬다고 알고 있다.
- McAleese et al. (2024), LLM Critics Help Catch LLM Bugs. 프롬프트만 준 범용 모델이 아니라 critic model을 따로 학습시키는 방향의 연구다.