Reasoning Models Know When They're Right: Probing Hidden States for Self-Verification
추론 모델의 중간 답 지점 hidden state에 선형 probe를 붙여 정답 여부를 예측하고, 그 확신도로 조기 종료해 MATH에서 토큰 24% 절감
추론 모델이 답을 맞히는 것과, 맞힌 시점에 추론을 멈추는 것은 다른 문제다. 이미 정답에 도달했는데도 다른 풀이를 찾거나 같은 계산을 다시 확인한다면, 뒤에 생성한 토큰은 정확도를 높이지 못한 채 비용만 늘릴 수 있다. 이 논문은 그런 overthinking을 모델 내부의 정답 관련 정보와 연결해서 살펴본다.
Azaria와 Mitchell의 「The Internal State of an LLM Knows When It's Lying」이 진술의 진위를 hidden state에서 읽는 접근이었다면, 이 논문은 긴 CoT 안에서 반복해서 등장하는 중간 답을 대상으로 삼는다. 관심을 끈 부분은 probe의 분류 성능 자체보다, 그 점수를 이용해 추론을 일찍 끝낼 수 있는지까지 확인했다는 점이다.
- 저자: Anqi Zhang, Yulin Chen, Jane Pan, Chen Zhao, Aurojit Panda, Jinyang Li, He He
- 게재: COLM 2025
- 분석 판본: arXiv v1, 2025년 4월 7일
- 코드·학습된 probe: reasoning_models_probing
0. 한 줄 요약
긴 CoT의 중간 답 지점에서 hidden state를 읽어 정답 여부를 예측하고, 그 점수가 높을 때 추론을 끝내면 Llama-8B의 MATH 실험에서 정확도 0.4%p 하락과 함께 토큰을 약 24% 줄일 수 있다는 논문이다.
1. 문제 정의
논문이 다루는 상황은 모델이 답을 몰라서 계속 생각하는 경우만이 아니다. 이미 맞는 답을 냈는데도 “다른 방법으로 확인해 보자”라며 추론을 이어가는 경우다. 긴 CoT에는 이런 재검토 과정에서 원래 문제에 대한 답이 여러 번 등장한다. 저자들은 이를 intermediate answer라고 부른다.
여기서 두 질문이 생긴다. 모델 내부에는 현재 답이 맞는지 예측할 만한 정보가 있는가? 그 정보가 있다면, 이를 읽어서 불필요한 추론을 줄일 수 있는가?
첫 질문에는 probing으로 접근한다. 추론 모델의 가중치는 고정하고, hidden state를 입력받는 작은 분류기를 따로 학습한다. 이 분류기가 정답과 오답을 구별한다면 해당 표현에 정답 여부와 관련된 정보가 있다는 근거가 된다.
다만 probe가 정보를 읽을 수 있다는 사실만으로 모델이 그 정보를 스스로 판단에 활용한다고 말할 수는 없다. 이 논문의 결과를 해석할 때도 이 차이가 중요하다.
2. 기존 방법들의 한계
LLM의 확신도를 알아내는 가장 간단한 방법은 모델에게 직접 물어보는 것이다. 답이 맞을 확률을 말하게 하거나, 여러 번 생성한 답이 얼마나 일치하는지 살펴볼 수 있다. 이런 방법은 hidden state에 접근하지 않아도 된다는 장점이 있다. 반면 모델이 말로 표현한 확신도가 실제 정답률과 잘 맞는지는 별도로 확인해야 한다.
내부 표현에 작은 분류기를 붙이는 방법도 이미 연구돼 있었다. 이 논문이 넓힌 부분은 적용 대상이다. 짧은 진술이나 최종 답만 보는 대신, 추론 모델이 여러 경로를 탐색하는 동안 내놓는 중간 답마다 정답 여부를 예측한다.
효율적인 추론에 관한 연구와도 목적이 겹친다. 짧은 풀이를 학습시키거나, 성공할 가능성이 낮은 생성을 중단하거나, 문제에 따라 추론 예산을 조절하는 방법들이 있다. 이 논문은 현재 중간 답에 대한 probe 점수로 종료 시점을 정한다. 다만 조기 종료 실험에서 직접 비교한 대상은 정해진 번째 청크에서 멈추는 static early-exit이다. 다른 효율적 추론 방법보다 우수하다는 결과로 읽어서는 안 된다.
3. 방법
핵심은 긴 CoT를 중간 답이 들어 있는 청크로 나누고, 각 청크 끝의 hidden state에 정답 라벨을 붙여 probe를 학습하는 것이다.
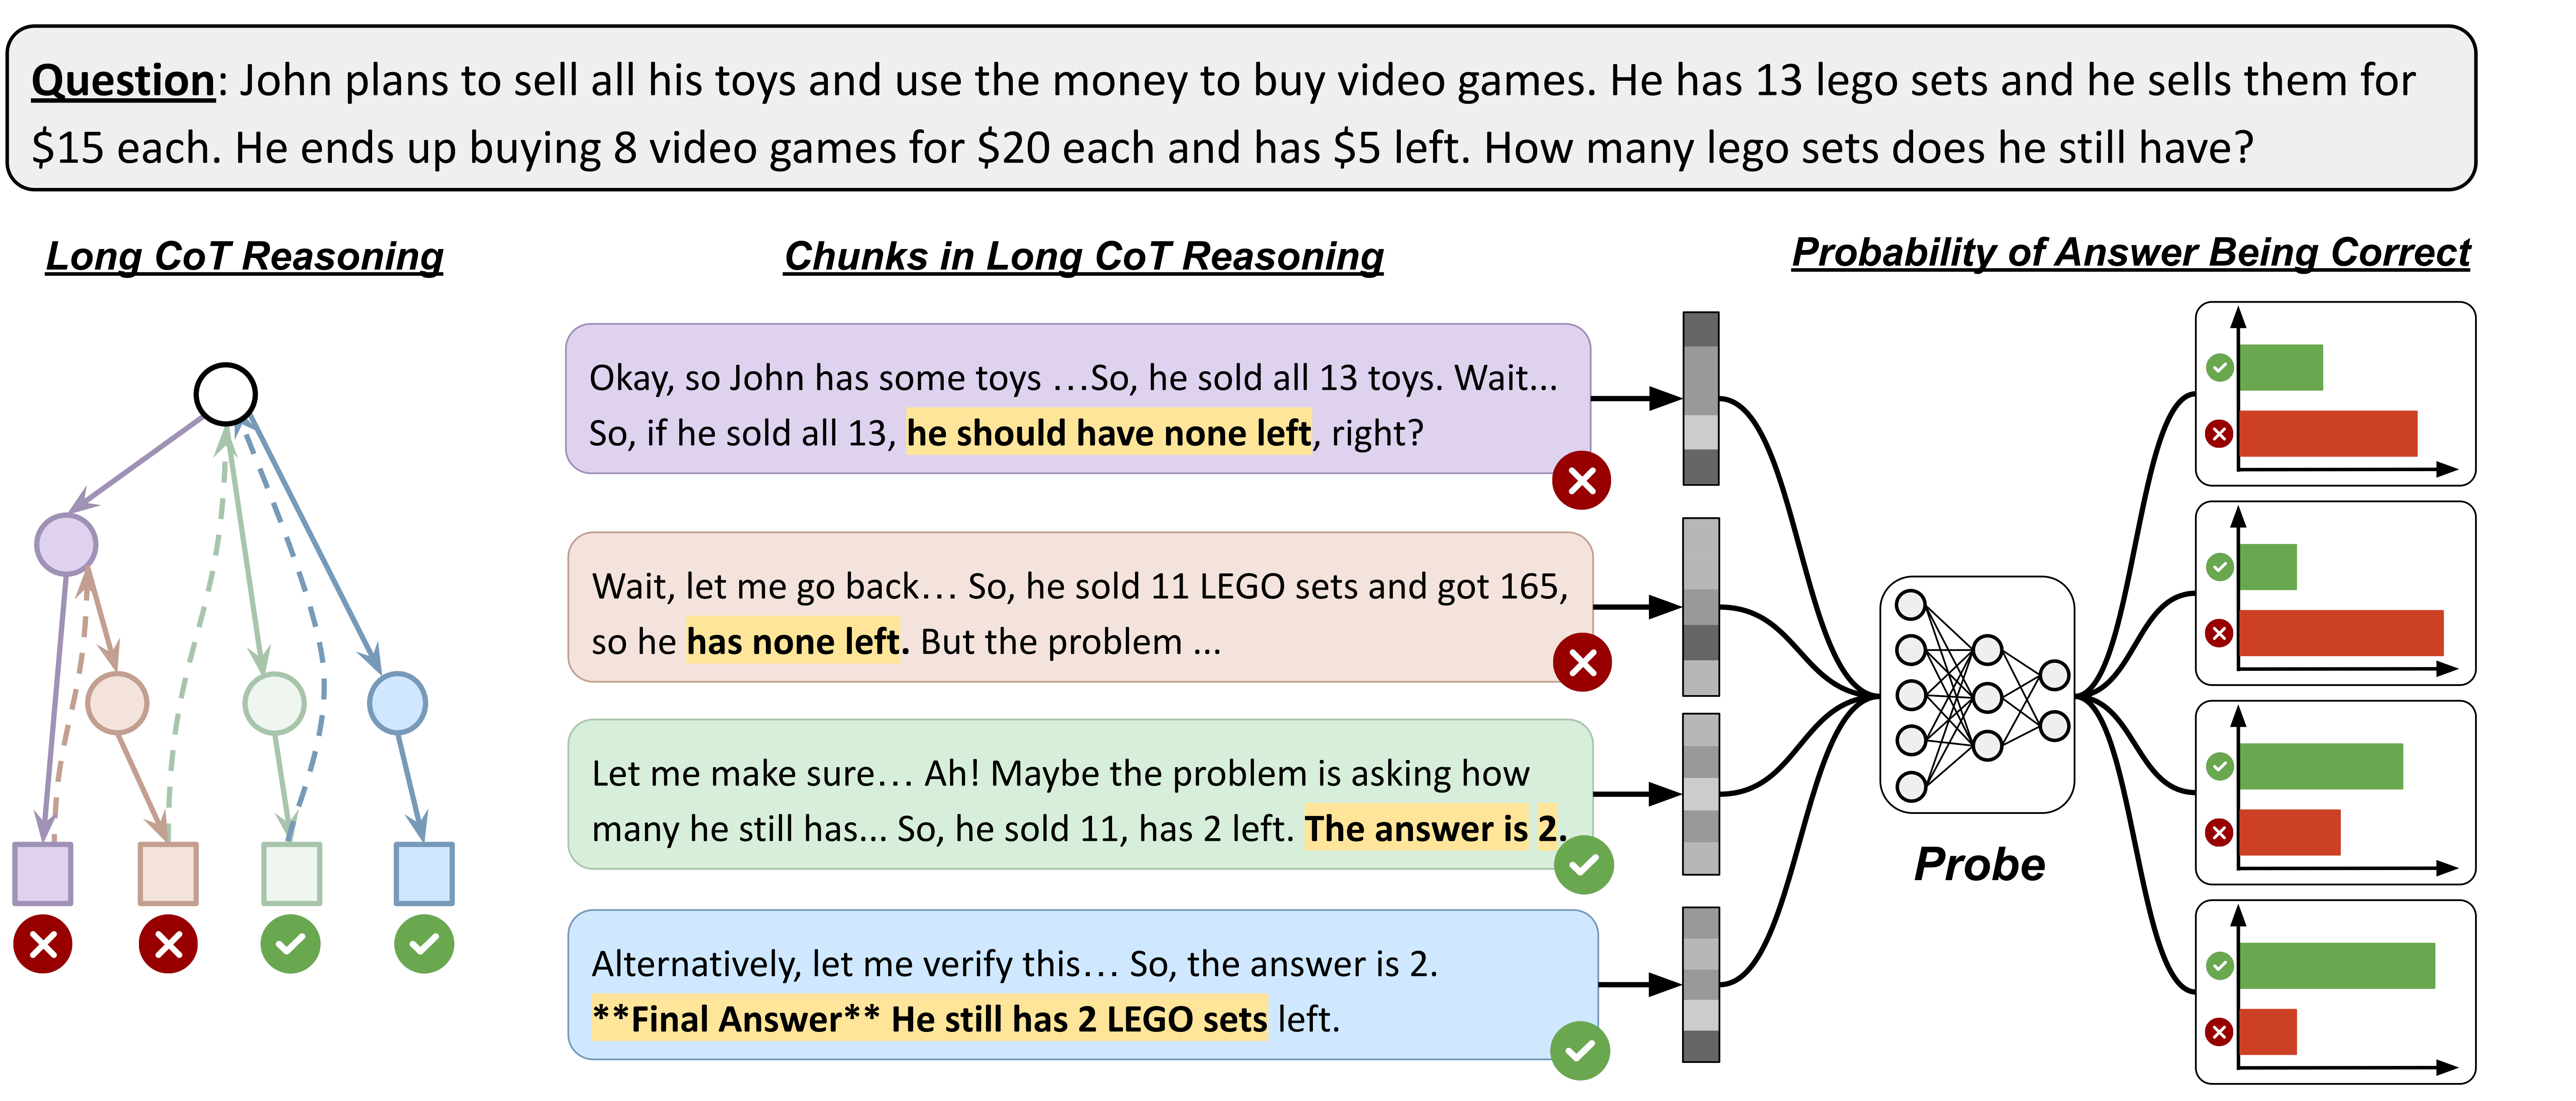
Fig. 1. 긴 CoT를 중간 답이 포함된 청크로 나누고, 각 청크 끝의 내부 표현으로 정답 여부를 예측한다. 논문 Figure 1.출처: Zhang et al., 2025, arXiv v1, CC BY 4.0. 원본 SVG를 PNG로 변환했다.
Fig. 1의 왼쪽에서는 한 문제의 풀이 안에서도 여러 중간 답이 나온다. 오른쪽의 probe는 각 청크 끝의 표현을 따로 읽는다. 문제 전체에 점수 하나를 붙이는 것과, 각각의 중간 답을 평가하는 것이 어떻게 다른지 보여준다.
중간 답과 라벨 만들기
먼저 추론 모델의 <think> 안에 있는 텍스트를 빈 줄 기준으로 문단으로 나눈다. 이어서 “wait”, “double-check”, “alternatively”, “verify” 같은 표현을 찾아 새로운 추론 경로가 시작되는 지점을 정한다. 같은 경로에 속하는 문단들을 합친 것이 청크다.
그다음 Gemini 2.0 Flash가 각 청크에서 중간 답을 추출하고, 참조 정답과 비교해 True 또는 False를 부여한다. 답 없이 재검토만 하는 청크에는 None을 부여하고, 이를 가장 가까운 답이 있는 청크와 합친다. 따라서 청크 경계는 키워드뿐 아니라 답 추출 결과에도 영향을 받는다.
각 청크의 표현은 마지막 토큰 위치에서 얻은 마지막 층 hidden state다. 여기에 작은 MLP를 붙여 그 청크의 답이 맞을 확률을 예측한다.
이 과정은 정답 라벨을 사용하는 지도 학습이다. 원래 추론 모델을 다시 학습하지는 않지만, probe를 만들 때는 참조 정답과 외부 모델의 판정이 필요하다.
작은 probe로 읽을 수 있는가
논문은 은닉 크기가 0, 16, 32인 probe를 탐색한다. 저자들이 선형 probe라고 부르는 설정이 은닉 크기 0이다. validation 정확도가 높은 상위 10개 후보 중에서 은닉 크기가 가장 작은 모델을 선택한다.
공개된 arXiv v1의 Table 8에서는 24개 모델·데이터셋 조합 중 15개가 선형 설정으로 선택됐다. 적어도 이 조합들에서는 복잡한 비선형 분류기 없이 정답 관련 정보를 읽을 수 있었다는 결과다. 그렇다고 정답 여부를 결정하는 내부 계산 자체가 선형이라는 뜻은 아니다.
학습에는 클래스 불균형을 보정한 binary cross-entropy를 쓴다.
여기서 는 probe가 예측한 정답 확률이고, 는 정답이면 1, 오답이면 0인 라벨이다. 는 학습 데이터의 오답 수를 정답 수로 나눈 값이며, 는 그 가중치를 조절하는 하이퍼파라미터다.
예를 들어 MATH·Llama-8B의 학습 청크는 76.91%가 정답이다. 이 비율로 계산하면 는 약 0.30이다. 다만 양성 항에 실제로 곱해지는 값은 이므로, 만 보고 최종 가중치를 판단하면 안 된다. 이 설정에서 선택된 는 2.0이다.
점수로 종료 시점 정하기
조기 종료에서는 청크 순서대로 probe 점수를 확인한다. 점수가 임계값을 처음 넘은 청크에서 추적을 자르고, 그 청크의 중간 답을 최종 답으로 사용한다.
종료 조건에 참조 정답은 들어가지 않는다. 정답을 보고 멈추는 oracle 방식과는 다르다. 다만 논문의 §5.1은 전체 추론 추적을 먼저 얻은 뒤 자르는 절차를 설명한다. 따라서 보고된 토큰 절감은 실시간 시스템을 실행해 측정한 전체 비용이나 지연 감소와 구분해서 봐야 한다.
4. 실험 결과
arXiv v1의 실험은 GSM8K, MATH, AIME, KnowLogic을 대상으로 한다. 모델은 DeepSeek-R1-Distill 계열 다섯 개와 QwQ-32B다. 학습 문제는 데이터셋마다 최대 1,000개를 사용하고, 문제 하나에서 여러 중간 답 청크를 얻는다.
MATH는 MATH-500으로 평가한다. AIME는 1983–2024년 문제로 학습하고 2025년 문제로 평가한다. 최대 생성 길이를 넘긴 출력은 제외하므로, 실제 평가 문제 수는 모델에 따라 다르다. AIME의 유효 테스트 문제는 25–30개다.
정답 판별과 calibration
Llama-8B·MATH에서 probe의 정확도는 0.80, ROC-AUC는 0.84, ECE는 0.03이다. 여기서 맞혀야 하는 대상은 Gemini가 참조 정답과 비교해 붙인 청크별 라벨이다.
정확도 0.80만 보면 꽤 높아 보이지만, 정답 청크가 많은 데이터라는 점을 같이 봐야 한다. 앞서 나온 76.91%는 학습셋 비율이다. 테스트셋도 같은 비율이라고 가정하면, 전부 정답이라고 예측해도 약 0.77의 정확도를 얻는다. 다만 테스트셋의 실제 비율이 제시되지 않았으므로 이를 정확한 기준선으로 쓸 수는 없다.
이 때문에 판별력은 AUC와 함께 보는 편이 낫다. AUC 0.84는 정답 청크와 오답 청크를 하나씩 골랐을 때 정답 청크에 더 높은 점수를 주는 경향을 보여준다. ECE는 점수의 순서보다 확률값 자체가 실제 정답률과 얼마나 맞는지 평가한다. 설명을 위한 예로, 0.8 부근의 점수를 받은 답들이 실제로도 약 80% 맞는다면 그 구간에서는 calibration이 좋은 것이다.
두 성질은 전이 실험에서 다르게 나타난다. Llama-8B의 GSM8K probe를 MATH에 적용하면 AUC 0.80, ECE 0.08이고, 반대 방향은 AUC 0.83, ECE 0.04다. 반면 MATH probe를 AIME에 적용하면 AUC는 0.76이지만 ECE는 0.28이다. 정답과 오답의 순서를 어느 정도 구별하더라도, 출력한 확률을 그대로 종료 기준으로 쓰기는 어려울 수 있다.
조기 종료의 효과
조기 종료 실험은 Llama-8B와 MATH 한 조합에서 수행됐다. 최대 생성 길이는 10K다.
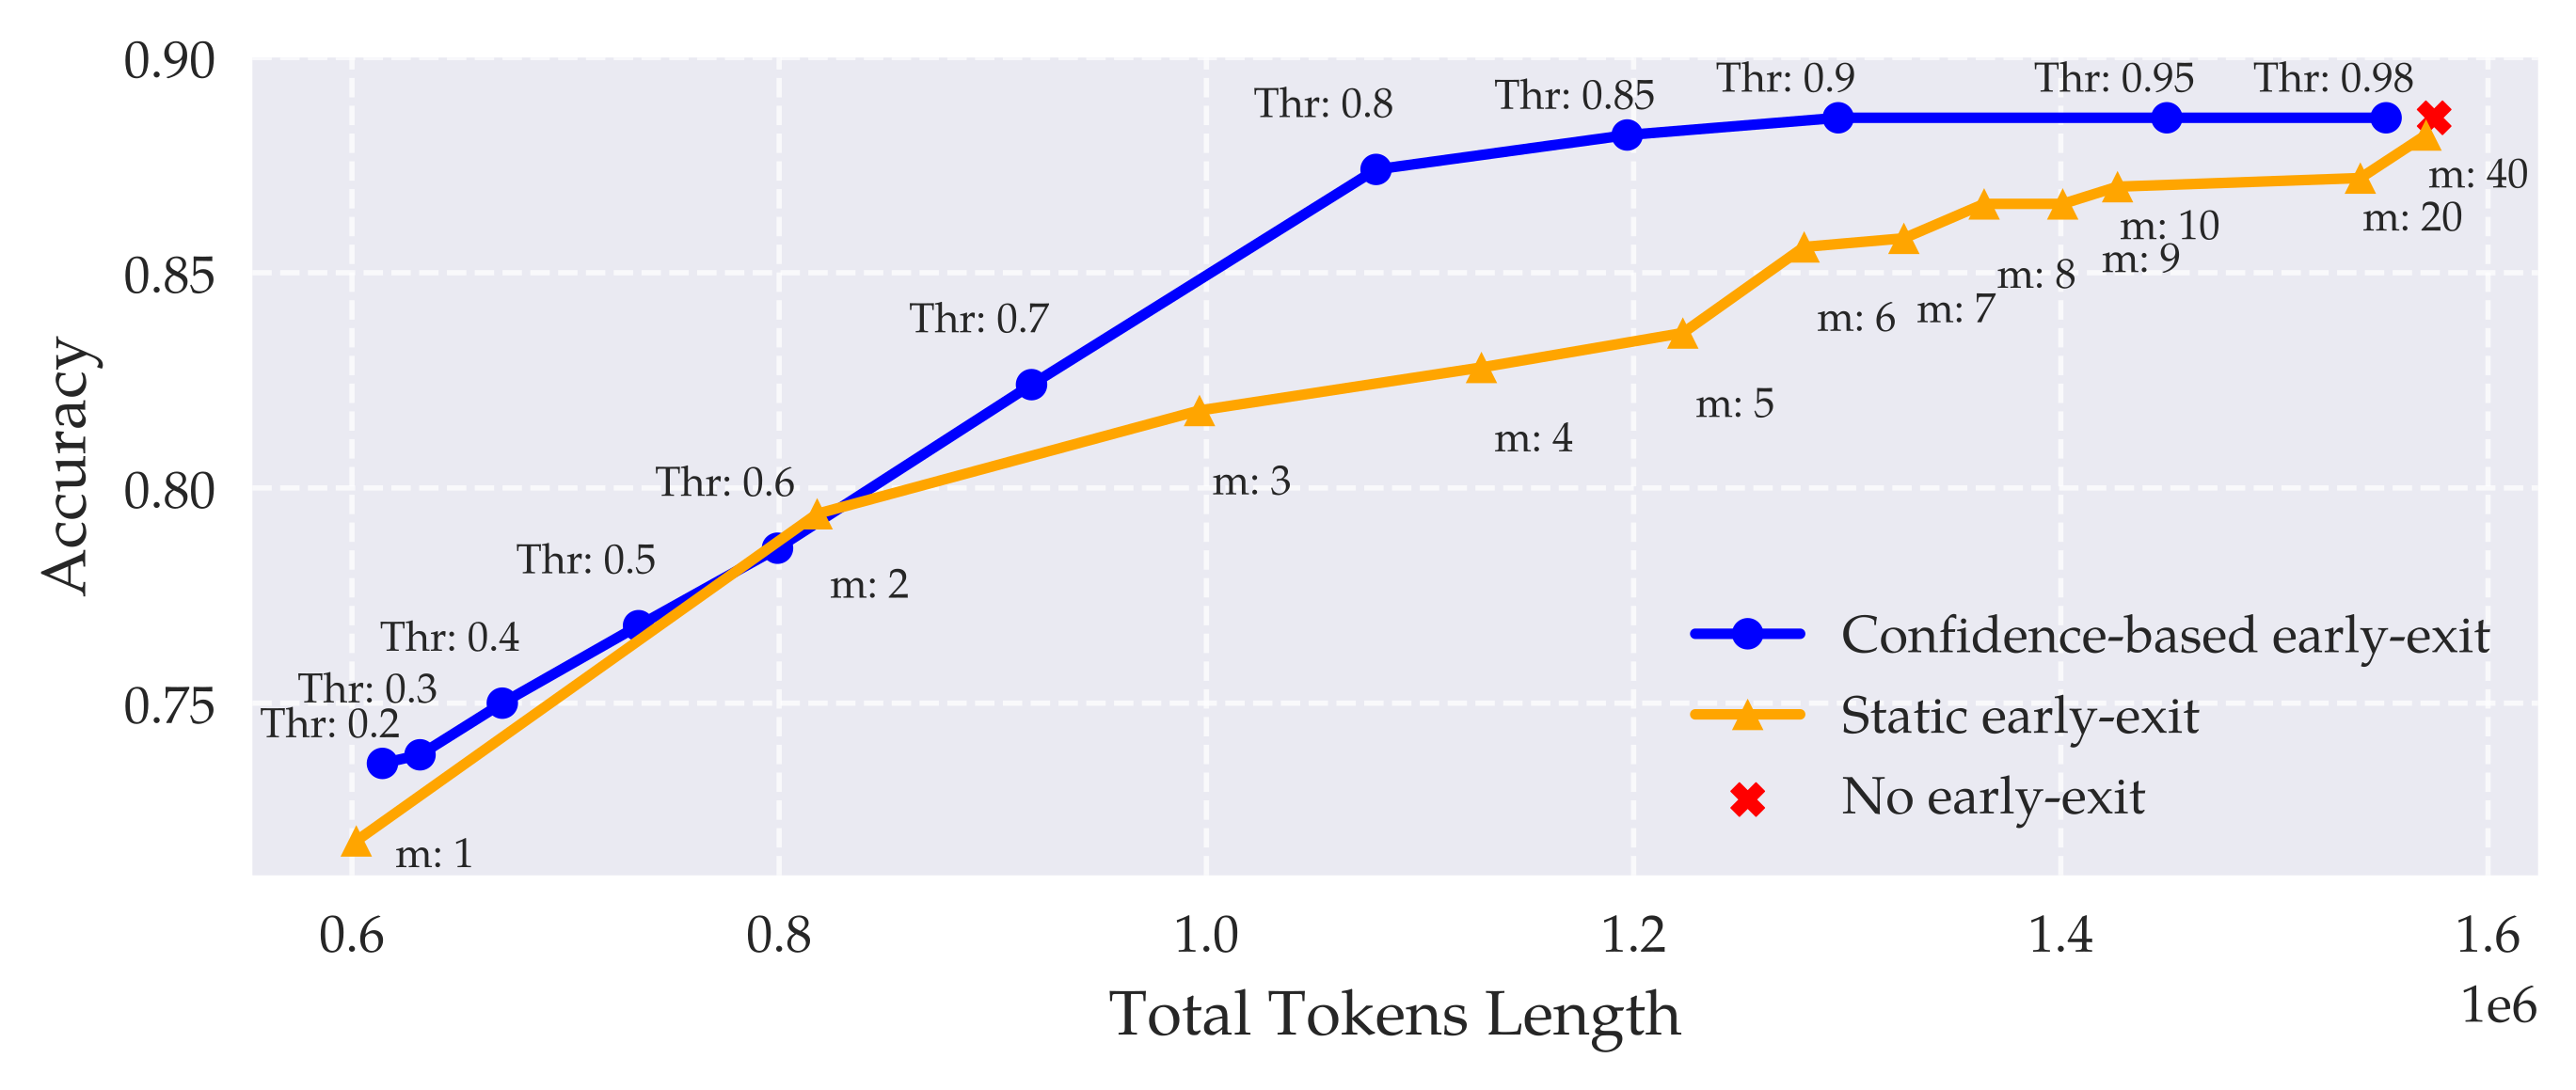
Fig. 2. 종료 임계값과 고정 청크 수를 바꿨을 때의 최종 답 정확도와 총 토큰 사용량이다. 논문 Figure 5.출처: Zhang et al., 2025, arXiv v1, CC BY 4.0. 원본 SVG를 PNG로 변환했다.
Fig. 2에서 파란 원은 probe 기반 종료, 주황 삼각형은 고정 청크 수 기반 종료, 빨간 표시는 조기 종료하지 않은 결과다. 가로축은 평가 문제 전체의 토큰 합계이므로, 같은 정확도에서 왼쪽에 있을수록 토큰을 적게 쓴 것이다.
조기 종료를 하지 않았을 때 정확도는 88.6%다. 임계값을 0.85로 정하면 토큰을 약 24% 줄이면서 정확도 88.2%를 얻는다. 정확히 같은 정확도를 유지한 설정은 임계값 0.9 이상이며, 이때 토큰 절감률은 19%다. 따라서 “정확도 유지와 24% 절감”이라는 요약에는 0.4%p 차이가 생략돼 있다.
고정 청크 수를 기준으로 종료하는 방법과의 차이는 더 뚜렷하다. 비슷한 토큰 사용량에서 probe 기반 종료는 87.4%, static early-exit은 약 82.5%의 정확도를 보인다. static early-exit은 미리 정한 m번째 청크에서 멈추되, 전체 청크가 m개보다 적은 문제에서는 조기 종료하지 않는다. 이 예외를 포함한 비교에서 probe 점수로 종료 시점을 정하는 편이 효과적이었다.
답이 나오기 전의 신호
저자들은 청크 끝뿐 아니라 중간 문단의 hidden state로도 이후 답의 정답 여부를 예측했다. arXiv v1 Figure 4(b)의 정확도 곡선에서 읽으면 Llama-8B·MATH의 청크 끝 정확도는 약 79%이고, 문단 진행률 10%, 50%, 95% 지점에서는 각각 약 66%, 69%, 74%다.
답에 가까워질수록 예측 정확도가 높아지는 결과는 흥미롭다. 다만 이 실험만으로 모델이 앞으로 낼 답의 오류를 미리 알아챈다고 단정하기는 어렵다. 문제 자체의 난이도도 이후 정답 여부를 예측하는 단서가 될 수 있기 때문이다.
5. 읽으면서 든 의문
첫 번째는 probe가 무엇을 읽었는가다. 쉬운 문제에서는 여러 중간 답이 모두 맞고, 어려운 문제에서는 여러 답이 함께 틀릴 수 있다. 이 경우 hidden state에서 문제 난이도와 관련된 정보를 읽어도 청크별 정답 여부를 어느 정도 예측할 수 있다. 개인적으로는 정답과 관련된 정보가 있다는 결과에는 동의하지만, 이를 곧바로 “현재 답이 맞는지 안다”는 능력으로 해석하기는 조심스럽다. 답이 나오기 전에도 예측이 가능하다는 결과 역시 이런 대안 설명을 배제하지 않는다.
두 번째는 조기 종료 수치가 뜻하는 범위다. 실험에서는 완성된 추적을 사후에 자른다. 실제 생성 중에는 답이 끝났는지 감지하고 그 답을 추출해야 하는데, 데이터 구축에 쓰인 Gemini 절차를 실시간으로 어떻게 대신할지는 이 결과만으로 알기 어렵다. 논문의 토큰 수는 잘랐을 때 남는 추론 길이를 보여주지만, 이를 곧바로 전체 시스템의 비용 절감률로 옮길 수는 없다. 임계값도 여러 값을 바꿔 그린 평가 곡선으로 제시돼 있어, 별도 데이터에서 고정한 값이 새 문제에서도 같은 절감률을 내는지는 확인되지 않는다.
세 번째는 arXiv v1 본문의 포괄적인 표현과 표의 차이다. §4.2는 모든 probe가 AUC 0.7 초과, ECE 0.1 미만이라고 설명하지만, Table 2의 Llama-8B·KnowLogic AUC는 0.67이다. Table 1에는 ECE 0.13과 0.14인 조합도 있다. 여러 설정에서 calibration이 좋다는 결과와, 모든 설정이 같은 기준을 만족한다는 주장은 구별해야 한다.
네 번째는 arXiv v1 부록의 전이 결과다. Table 11–15는 서로 다른 모델의 결과인데도 분포 내 기준값이 반복된다. 예를 들어 MATH의 기준 ECE는 이 표들에서 모두 0.03이지만, Table 1의 모델별 값은 그렇지 않다. 복사 과정의 오류일 가능성은 있지만 원인을 단정할 수는 없다. 다만 이 표들의 증감 수치를 근거로 모델 전반의 전이 성능을 평가하기는 어렵다.
다섯 번째는 long CoT가 정답 관련 정보를 만들어냈다는 해석이다. arXiv v1 Figure 3에 표시된 최종 답 probe의 AUC는 추론 모델이 0.86, 비추론 모델이 0.82다. calibration 차이는 더 크지만, 이를 long CoT 학습 하나의 효과로 설명하기에는 모델의 학습 과정과 데이터 차이가 남아 있다. 저자들도 이 능력의 정확한 기원은 알기 어렵다고 Discussion에서 밝힌다.
마지막은 평가 표본과 불확실성이다. 특히 AIME는 테스트 문제가 적고, 같은 문제에서 나온 여러 청크는 서로 관련돼 있다. 청크 수가 늘었다고 그만큼 독립적인 문제를 평가한 것은 아니다. 88.2%와 88.6%의 차이 역시 반복 실험이나 신뢰구간 없이 유의미한 하락이라고 단정할 수는 없지만, 통계적으로 같은 성능이 확인됐다고 말할 근거도 부족하다.
6. 정리
이 논문에서 설득력 있었던 부분은 hidden state에서 읽은 점수를 종료 결정에 연결했다는 점이다. 내부 표현을 분석하는 데서 그치지 않고, 그 정보를 어떤 판단에 쓸 것인지까지 구체화한 접근에 의미가 있다고 생각한다.
개인적으로 가장 아쉬운 부분은 그 정보가 답의 정확성을 얼마나 구체적으로 반영하는지다. 문제 난이도만으로 설명할 수 있는 부분이 남아 있고, 사후 절단 실험과 실시간 추론 시스템 사이에도 차이가 있다. 그래서 제목의 “Know When They're Right”보다는, “중간 답의 정답 여부를 예측하는 정보를 작은 probe로 읽을 수 있다”는 설명이 실험 결과에 더 가깝다고 생각한다.
7. 같이 읽어볼 논문
- Belinkov, Probing Classifiers: Promises, Shortcomings, and Advances. probe가 정보를 읽는다는 결과를 어떻게 해석해야 하는지 다룬다. 이 논문의 정답 관련 신호와 자기검증 능력을 구별해서 읽는 데 도움이 된다.
- Azaria & Mitchell, The Internal State of an LLM Knows When It's Lying. 내부 표현에서 진위 정보를 읽는 선행 연구다. 긴 CoT의 중간 답으로 대상을 넓히면서 무엇이 달라졌는지 비교할 수 있다.
- Chen et al., Do NOT Think That Much for 2+3=? On the Overthinking of o1-like LLMs. 이 논문이 줄이려는 overthinking을 다룬다. 정답에 도달한 뒤 이어지는 추론을 왜 비용 문제로 보는지 함께 살펴보기 좋다.