Reflexion: Language Agents with Verbal Reinforcement Learning
가중치 업데이트 없이, 실패한 시도에 대한 스칼라/바이너리 피드백을 LLM 자신이 자연어로 증폭한 "self-reflection"을 슬라이딩 윈도우 메모리에 축적해 다음 시도의 프롬프트에 주입함으로써, 의사결정·추론·코드생성 세 과제에서 학습 효과를 얻는 "언어적 강화학습(verbal reinforcement learning)" 프레임워크.
LLM의 self-correction 쪽 논문을 차례로 읽고 있는데, 그러다 보면 꼭 만나는 논문이 Reflexion이다. "모델이 자기 실수를 말로 돌아보면 다음 시도에서 더 잘한다"는 아이디어를 에이전트 설정까지 넓혀서 실험한 논문이다. 이후 나온 self-correction 비판 논문들에서 자주 비교 대상으로 등장해서, 한 번은 제대로 읽어 두고 싶었다. 에이전트 실험은 저자 일부가 겹치는 ReAct 위에서 돌아가기 때문에 ReAct를 알고 읽으면 훨씬 수월하다.
- 저자: Noah Shinn, Federico Cassano, Edward Berman (Northeastern University), Ashwin Gopinath (MIT), Karthik Narasimhan, Shunyu Yao (Princeton University)
- 게재: NeurIPS 2023 (arXiv:2303.11366)
- 코드: noahshinn024/reflexion
0. 한 줄 요약
가중치는 건드리지 않는다. 실패한 시도에서 나온 성공/실패 신호를 LLM이 직접 자연어 반성문으로 풀어 쓰게 하고, 그 반성문을 메모리에 쌓아 다음 시도의 프롬프트에 넣는다. 이것만으로 의사결정, 추론, 코드 생성 세 과제에서 학습 효과를 얻었다는 논문이다.
1. 문제 정의
ReAct, SayCan, Toolformer 같은 LLM 에이전트는 게임, 컴파일러, API 같은 외부 환경과 상호작용한다. 하지만 파라미터가 워낙 많아서 전통적인 gradient 기반 RL로 파인튜닝하려면 샘플도 연산도 너무 많이 든다. 그래서 지금은 in-context few-shot 예시를 보여 주는 것 말고는 에이전트를 가르칠 방법이 마땅치 않다.
논문 4.1절의 분석을 보면 실제로 어떻게 실패하는지가 잘 드러난다. AlfWorld처럼 여러 단계를 거쳐야 하는 과제에서 에이전트는 아직 아이템을 손에 넣지 않았는데도 넣었다고 착각한다. 그 상태로 긴 trajectory를 계속 실행하고, 나중에 돌아가서 어디서 틀렸는지 찾아내지 못한다. ReAct만 쓴 baseline은 6~7번째 trial 사이에서 성능이 더 오르지 않고, hallucination으로 실패하는 비율도 22%에서 내려오지 않는다(Fig. 2).
결국 RL에서 말하는 credit assignment 문제다. 긴 trajectory가 실패로 끝났을 때 어떤 행동이 원인이었는지 알아내야 한다. 파라미터를 업데이트하지 않고 몇 번의 trial만으로 에이전트가 경험에서 배우게 할 수 있다면, RL의 샘플 비효율 문제를 피해 가면서도 LLM 에이전트의 성능을 끌어올릴 수 있다. 이 논문이 노리는 게 바로 이 지점이다.
2. 기존 방법들의 한계
논문은 관련 연구를 크게 세 갈래로 나눈다.
첫째는 생성을 한 번만 하는 과제에서 자기 개선을 하는 방법들이다. Self-Refine은 반복해서 스스로 고치는 프레임워크지만 대상이 생성 한 번으로 끝나는 추론 과제뿐이고, 의사결정이나 이진 보상, 메모리를 다루지 않는다. Xie et al.의 stochastic beam search는 self-evaluation으로 앞을 내다보긴 하지만 메모리가 없다. 프롬프트를 최적화하는 Pryzant et al.도 생성 한 번으로 끝나는 과제에 머물고, Paul et al.은 critic 모델을 파인튜닝해서 trajectory 중간에 피드백을 준다.
둘째는 테스트를 기반으로 하는 코드 디버깅이다. AlphaCode는 hidden test case로 생성물을 평가하고, Self-Debugging과 CodeRL은 실행 결과를 보고 디버깅한다. 저자들은 이 세 방법이 모두 ground truth test case에 기대기 때문에 pass@1이라고 부를 자격이 없다고 지적한다. CodeT는 hidden test 없이 직접 만든 unit test로 채점하지만 반복해서 고치는 단계가 없다.
셋째는 여러 번 생성하거나 재시도하는 에이전트다. Kim et al.은 평가 단계 없이 정해진 횟수만큼 다시 시도한다. Goodman은 정성적으로 평가한 뒤 이전 생성을 고쳐 나가는 방식을 제안했는데, 참고문헌을 보면 피어 리뷰를 거치지 않은 블로그 글이다.
하나 짚고 넘어갈 점이 있다. 이 비교는 대부분 2장에 있는 속성 비교표 두 개에 기대고 있다. 추론·의사결정 쪽은 self-refine, hidden constraints, decision making, binary reward, memory를, 프로그래밍 쪽은 테스트 실행, 디버깅, 테스트 자체 생성, 다중 언어, self-reflection을 체크한 표다. 코드 생성에서 CodeT의 수치를 Table 1에 이전 SOTA로 옮겨 둔 것을 빼면, 이 방법들을 같은 조건에서 돌려 수치로 비교한 게 아니라 저자들이 분류하고 논증한 것에 가깝다. "ground truth test에 의존하니까 pass@1이 아니다"라는 핵심 비판도 실험이 아니라 논증으로만 제시된다.
3. 방법
핵심 아이디어는 하나다. 실패한 trajectory에 대한 스칼라나 이진 피드백을 LLM이 자연어 요약, 즉 self-reflection으로 부풀려서 장기 메모리에 저장하고, 다음 trial의 프롬프트에 넣어 준다. Actor와 Evaluator는 이 self-reflection을 만들어 내고 소비하기 위한 부품이라고 보면 된다.
시스템은 LLM 모듈 세 개로 이루어진다. Actor는 CoT나 ReAct 프롬프팅으로 행동을 만든다. Evaluator는 그 결과를 채점한다. Self-Reflection 모델은 채점 결과를 보고 자연어 피드백을 쓴다. 한 바퀴를 돌면 이렇게 된다. Actor가 환경과 상호작용해서 trajectory 를 만들고, Evaluator가 이를 채점해 스칼라 보상 를 낸다.
그다음 Self-Reflection 모델이 와 를 함께 보고 반성문 를 쓴다. 이 반성문은 메모리에 붙는다. 메모리는 최대 개, 보통 1~3개만 유지하는 sliding window다. 다음 trial에서 Actor는 이 메모리를 컨텍스트로 받아 다시 시도하고, Evaluator가 통과로 판정하거나 최대 trial 수에 닿을 때까지 이걸 반복한다. 논문은 정책 의 를 "LLM 파라미터와 메모리"로 다시 정의하는데(Algorithm 1), 가중치 대신 메모리가 업데이트된다는 뜻에서 verbal reinforcement learning이라고 이름 붙인 것이다.
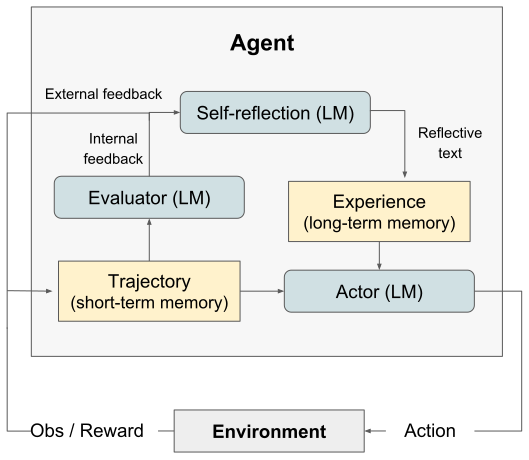
Fig. 1. Reflexion의 전체 구조. Actor, Evaluator, Self-reflection 세 모듈과 두 종류의 메모리, 환경 사이의 흐름을 보여 준다(논문 Figure 2a).출처: Shinn et al., arXiv 2023 (CC BY 4.0)
그림을 보면 세 모듈이 모두 같은 LM으로 그려져 있고, 메모리는 한 시도 안에서 쌓이는 trajectory인 단기 메모리와 반성문이 쌓이는 장기 메모리로 따로 나뉘어 있다. 환경에서 오는 외부 피드백과 Evaluator가 내는 내부 피드백이 Self-reflection을 거쳐 반성문이 되고, 이 반성문이 장기 메모리를 통해 다시 Actor로 돌아가는 구조다.
는 숫자 하나라서 어디가 왜 틀렸는지는 말해 주지 않는다. 이 숫자를 말로 풀어 주는 단계가 왜 필요한지는 4장에서 다룰 ablation이 직접 보여 준다.
Evaluator는 과제마다 완전히 다르다. 이 점은 짚고 넘어가는 게 좋다. HotPotQA에서는 trial 사이에 정답 라벨과 exact match로 비교해서 성공 여부를 알려 준다. 환경이 이미 정답을 알고 있다는 뜻이고, 실제 서비스에서는 얻을 수 없는 신호다. 그런데 논문은 이를 오라클이라고 부르지 않고 그냥 "environment feedback"이라고 쓴다. AlfWorld에서는 환경이 주는 task complete 신호에 더해, 같은 행동에 같은 응답이 3회를 넘게 반복되거나 행동이 30개를 넘으면 반성하게 하는 heuristic, 또는 LLM이 직접 판단하는 자기 평가를 쓴다. 정답 라벨은 아니지만 결국 환경의 완료 신호에 기대는 건 마찬가지다. 코드 생성에서는 모델이 직접 만든 unit test로 판정한다. 이건 오라클이 아니라 스스로 만든 검증기라서 틀릴 수 있다. 실제로 논문의 Table 2는 MBPP Python에서 false positive 비율이 16.3%라는 걸 스스로 보여 준다.
언제 멈출지도 과제마다 제각각이다. HotPotQA는 세 번 연속 실패할 때까지, AlfWorld는 12 trial까지 돌리고, 프로그래밍은 모델이 만든 테스트를 모두 통과하면 멈춘다. 프로그래밍의 최대 trial 수는 논문에 적혀 있지 않다. 정답을 모르는 실제 배포 환경에서는 이 종료 신호를 어디서 얻을지부터가 풀리지 않은 문제다.
내 식으로 구성 요소를 나눠 보면, 모델의 언어 능력이 새로 하는 일은 사실상 Self-Reflection 하나다. Actor는 기존 CoT나 ReAct에 few-shot 프롬프트를 얹은 것이고, Evaluator는 정답과의 EM 비교, 손으로 짠 heuristic이나 LLM 분류, LLM이 만든 unit test 실행처럼 과제마다 따로 붙인 장치다. 메모리는 엔지니어링에 가깝고, 저자들도 5장에서 vector DB나 SQL로 넓히는 걸 향후 과제로 남겨 두었다. 이렇게 나눠서 보니 이 논문이 실제로 무엇을 보여 줬는지가 더 분명해졌다.
4. 실험 결과
실험 환경은 꽤 다양하다. AlfWorld는 TextWorld 기반의 134개 환경에 6가지 태스크가 있다. HotPotQA는 11만 3천 개 QA 쌍 중 100문항을 뽑아 썼다. 코드 생성은 HumanEval, MBPP, 그리고 저자들이 새로 만든 LeetcodeHardGym을 썼다. LeetcodeHardGym은 19개 언어 40문항으로 이루어져 있고, 오염을 막으려고 GPT-4 사전학습 컷오프인 2022년 10월 8일 이후에 나온 문제만 골랐다. 부록에는 WebShop 100개 환경 실험도 있다. 모델은 text-davinci-003, gpt-3.5-turbo, GPT-4를 주로 쓰고, 부록 A에서 작은 오픈소스 모델인 starchat-beta로도 확인했다. 파인튜닝은 전혀 없고 순수하게 프롬프팅만 한다. temperature는 HotPotQA baseline의 재시도에 0.7을 썼다는 언급만 있고, Reflexion 자체와 나머지 과제의 설정은 나와 있지 않다.
가장 눈에 띄는 건 코드 생성 결과(Table 1)다. HumanEval Python에서 Reflexion은 91.0으로, GPT-4 zero-shot의 80.1보다 10.9%p 높다. 이전 SOTA였던 CodeT+GPT-3.5는 65.8이었다. 164문항으로 환산하면 GPT-4 zero-shot이 틀린 문제 중 대략 18문항을 더 맞힌 셈이다. 다만 두 조건이 정확히 같은 164문항으로 평가한 것인지는 논문에 적혀 있지 않아서 대략적인 숫자로만 보는 게 맞다. LeetcodeHard Python은 7.5에서 15.0으로 두 배가 됐다.
예외는 MBPP Python이다. 77.1로 GPT-4 zero-shot의 80.1보다 낮은데, Table 1의 코드 생성 벤치마크 중 Reflexion이 baseline보다 낮게 나온 건 이 경우뿐이다. 저자들은 Table 2로 원인을 직접 보여 준다. 모델이 만든 테스트의 false positive 비율이 HumanEval Python은 1.4%인데 MBPP Python은 16.3%다. 틀린 코드가 테스트를 통과했다고 잘못 판정되어 일찍 멈춰 버리는 경우가 많았던 것이다. 실패를 숨기지 않고 원인까지 분석해 둔 점은 좋았다.
AlfWorld에서는 Heuristic으로 판정한 설정에서 134개 중 130개, 97.0%를 끝냈다. ReAct만 쓴 baseline이 hallucination 22%에서 멈춰 있던 것과 대비된다. 남은 4개는 본문에서 따로 다루지 않지만, Fig. 2(b)를 보면 마지막 trial에서 남은 실패는 모두 hallucination으로 분류되어 있다.
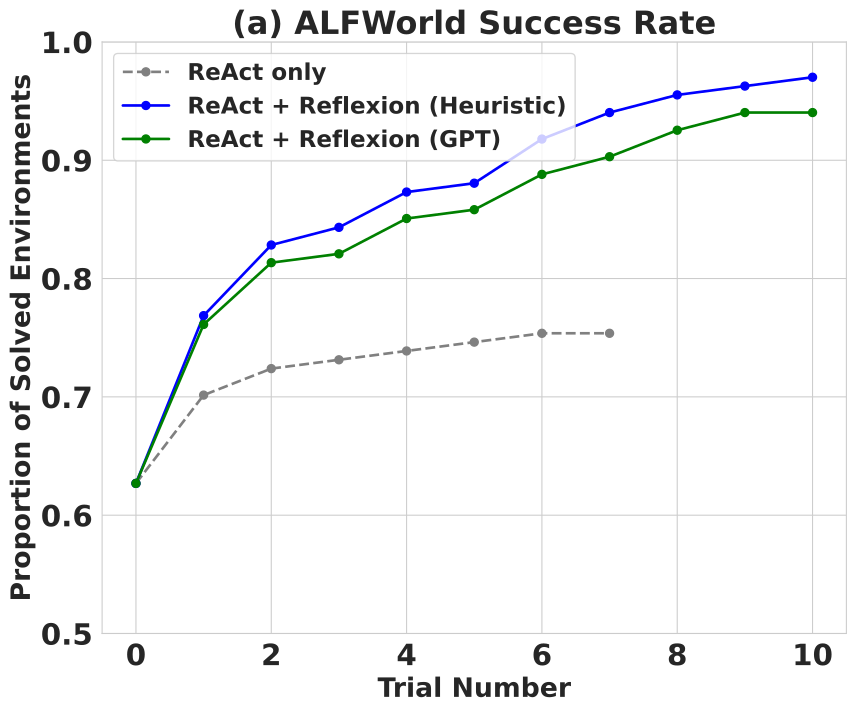
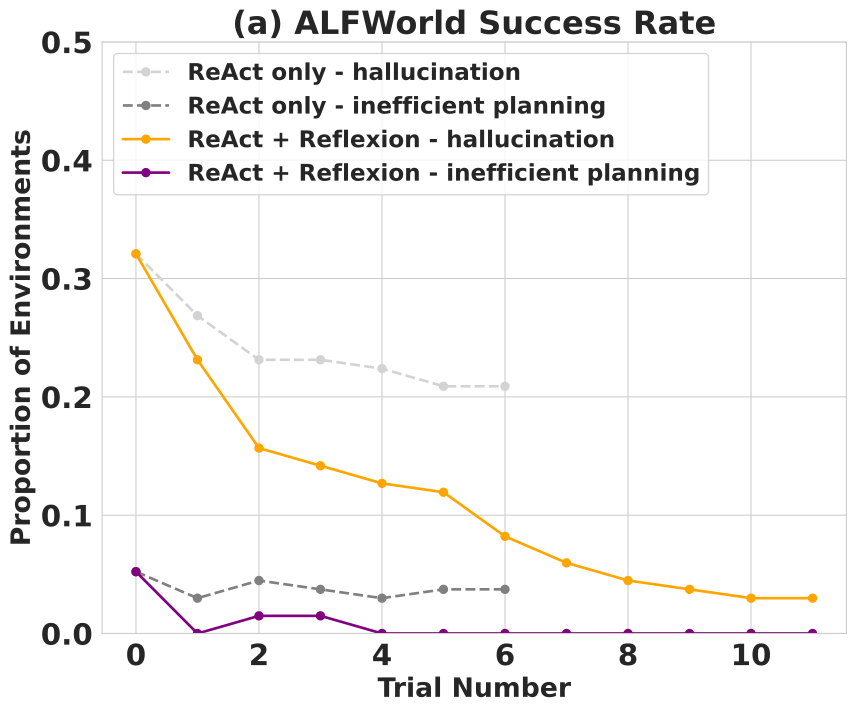
Fig. 2. (a) AlfWorld 134개 과제에서 trial이 늘어날 때 누적으로 푼 과제 비율. Reflexion은 Heuristic과 GPT 두 가지 자기 평가 방식으로 성공 여부를 판정했다.
(b) 실패 원인(hallucination, inefficient planning)별로, 그 원인으로 실패한 환경이 전체에서 차지하는 비율. 그림 안 제목이 "(a) ALFWorld Success Rate"로 되어 있는 건 원논문 그림의 표기를 그대로 옮긴 것이다(논문 Figure 3).출처: Shinn et al., arXiv 2023 (CC BY 4.0)
(a)를 보면 ReAct만 쓴 곡선은 6~7번째 trial쯤에서 평평해지는데, Reflexion을 붙인 곡선은 그 뒤로도 계속 올라간다. Heuristic 곡선은 trial 10에서 0.97, 즉 130/134 근처에 닿고, GPT로 판정한 곡선은 0.94 근처에서 멈춘다. (b)에서는 ReAct만 쓴 경우 hallucination 때문에 실패하는 비율이 20%를 조금 넘는 선에서 내려오지 않는다. 1장에서 말한, 이미 틀린 상태를 알아채지 못하고 그대로 끌고 가는 실패가 trial을 반복해도 고쳐지지 않는다는 뜻이다.
HotPotQA에서는 정답 문맥을 준 CoT(GT)만으로도 39% 문항을 틀렸는데, Reflexion을 붙이니 정확도가 14% 올랐다(§4.2). 이를 절대값으로 읽으면 오답률이 대략 39%에서 25%로, 100문항 기준 14문항 정도가 바뀐 셈이다. 이 숫자는 trial마다 정답과의 exact match로 성공 여부를 알려 준 설정에서 나왔다. 참고로 서론에서는 HotPotQA 개선 폭을 20%로 적고 있어서, 어떤 설정의 숫자인지 구분해서 읽어야 한다.
이 논문에서 가장 설득력 있었던 건 Table 3의 ablation이다. HumanEval Rust에서 가장 어려운 50문항으로 GPT-4 기반 실험을 했다. baseline이 0.60, 전체 Reflexion이 0.68이다. 여기서 test 생성을 빼고 self-reflection만 하면 0.52로 오히려 baseline보다 떨어진다. 반대로 테스트는 있는데 self-reflection을 빼면 0.60으로 baseline과 똑같아져서 개선이 완전히 사라진다. 무엇을 고쳐야 하는지 알려 주는 오류 신호와, 그 신호를 말로 해석하는 단계가 둘 다 있어야 작동한다는 뜻이다. 저자들의 설명으로는, 테스트가 없으면 지금 코드가 맞는지 판단할 수 없어서 일찍 멈추지 못하고 정해진 반복을 끝까지 돌면서 오히려 코드를 망가뜨리는 수정을 하게 된다. 반성만으로는 손해를 볼 수 있다는 점이 흥미로웠다.
HotPotQA에서도 비슷한 ablation이 있다(논문 Figure 4c). 가장 최근 trajectory를 그대로 다시 보여 주는 episodic memory 방식과 비교했을 때, self-reflection을 쓰면 정확도가 8%p 더 오른다. 단순히 지난 시도를 기억하는 것과 그걸 말로 정리하는 것 사이에 차이가 있다는 얘기다.
실패 사례도 있다. 부록 B.1의 WebShop에서는 4 trial을 돌려도 나아질 기미가 없어서 실험을 중단했다(논문 Figure 6). 저자들은 다양하고 창의적인 탐색이 필요한 과제에서는 Reflexion이 local minimum을 벗어나지 못한다고 분명히 적었다. 부록 A의 starchat-beta 결과도 눈여겨볼 만하다. HumanEval Python에서 8번 평균을 냈는데 baseline 0.26±0.00481, Reflexion 0.26±0.00305로 차이가 없다. 저자들은 이 결과를 근거로 스스로 고치는 능력이 더 크고 강한 모델에서 나타나는 성질이라고 본다.
5. 읽으면서 든 의문
첫 번째는 HotPotQA의 피드백 신호다. trial 사이에 exact match로 성공 여부를 알려 주는 건 사실상 정답 라벨을 쓰는 것이다. 그런데 논문은 이걸 오라클이라고 밝히지 않을 뿐 아니라, 같은 §4.2에서 Reflexion이 "정답에 접근하지 않고도(without access to the ground truth answer)" 실수를 고친다고 쓴다. 정답 텍스트를 직접 보여 주지는 않았다는 뜻이겠지만, 맞았는지 틀렸는지를 정답으로 판정해 알려 주는 것도 정답에 대한 접근이다. 정답을 아는 상태에서 얻은 성능 향상은 credit assignment를 진짜로 해결했다기보다, 정답 확인을 이용해 걸러 낸 결과에 가까울 수 있다. 오라클 없이 자기 평가만 쓰면 14%p 가운데 얼마가 남을지 이 논문만으로는 알 수 없다. 개인적으로는 verbal reinforcement learning이라는 이름과 실제 실험 설정 사이의 이 간극이 이 논문에서 가장 아쉬운 부분이었다.
두 번째는 반복 실행이 없다는 점이다. AlfWorld, HotPotQA, 코드 생성의 메인 결과(Table 1, 논문 Figure 3·4)가 모두 한 번씩만 돌린 결과로 보이고, 표준편차나 신뢰구간이 없다. 8번 평균과 표준편차를 낸 건 부록의 starchat-beta 실험 하나뿐인데, 하필 거기서는 개선이 없었다. 메인 결과도 여러 번 돌렸다면 결론이 그대로였을지 궁금하다.
세 번째는 비교 예산이다. baseline은 zero-shot으로 한 번 생성한 결과인데, Reflexion이 과제마다 trial을 몇 번 돌렸는지는 Table 1에 나와 있지 않다. 그래서 API 호출 수를 맞춰 놓고 비교했을 때도 같은 차이가 나는지는 확인할 수 없다. baseline 숫자도 일관되지 않다. HumanEval Python의 GPT-4 baseline이 Table 1에서는 80.1, Table 2에서는 0.80, 본문에서는 82%로 적혀 있다. Table 1의 80.1은 어디서 잰 값인지 출처가 적혀 있지 않아서, Reflexion과 같은 조건에서 잰 baseline인지부터 불분명하다.
네 번째는 데이터 오염이다. LeetcodeHardGym은 GPT-4 컷오프 이후 문제만 골라서 오염을 신경 썼지만, HumanEval, MBPP, HotPotQA는 모두 공개 벤치마크이고 GPT-3.5와 GPT-4로 실험했다. 오염 가능성을 충분히 의심할 만한데 이 세 벤치마크의 오염 가능성은 논문에서 다루지 않는다.
마지막으로 기여 목록도 조금 걸렸다. 서론의 contribution 네 개 중 첫째(verbal RL이라는 패러다임)와 둘째(self-reflection이 유용하다는 실증)는 사실상 같은 이야기를 두 번 한 것에 가깝다. 실질적인 방법론 기여는 self-reflection 메커니즘 하나이고, 나머지 독립 기여는 LeetcodeHardGym이라고 보는 게 정확할 것 같다.
6. 정리
이 논문의 주장을 가장 잘 받쳐 주는 건 Table 3의 ablation이다. HumanEval Rust 50문항이라는 좁은 설정이긴 하지만, self-reflection을 빼면 개선이 baseline 수준으로 완전히 사라지고, 테스트를 빼면 오히려 손해를 본다. 말로 된 피드백이 credit assignment에 실제로 도움이 된다는 핵심 주장을 이 실험이 직접, 그리고 꽤 정직하게 보여 준다. MBPP에서 성능이 떨어진 원인을 false positive 비율로 설명하고, WebShop 실패를 감추지 않은 점도 좋았다.
반면 메인 결과가 모두 한 번씩만 돌린 실험이라는 점, HotPotQA에서 정답과의 exact match로 성공 여부를 알려 주면서도 "정답에 접근하지 않고" 고쳤다고 설명한 점은 약점이다. 특히 오라클 문제 때문에 "언어로 하는 강화학습"이라는 주장이 실험으로 얼마나 뒷받침되는지가 애매해진다. 이 두 가지가 해결되지 않으면 결과를 그대로 믿기는 어렵다고 생각한다.
이 논문에서 하나 가져간다면, 자기 반성이 효과를 보려면 반성할 근거가 되는 외부 신호가 꼭 있어야 한다는 점이다. Rust ablation에서는 테스트 없이 반성만 하면 성능이 떨어졌고, starchat-beta에서는 반성 자체가 힘을 쓰지 못했다. self-correction이 된다 안 된다를 따질 때도 그 신호가 어디서 오는지부터 확인해야겠다는 생각이 들었다.
7. 같이 읽어볼 논문
- Yao et al. (ICLR 2023), ReAct: Synergizing Reasoning and Acting in Language Models. Reflexion의 Actor가 쓰는 프롬프팅 방식을 제안한 논문이다. AlfWorld 실험과 HotPotQA의 ReAct 설정이 이 위에서 돌아간다.
- Shridhar et al. (ICLR 2021), ALFWorld. 의사결정 실험에 쓰인 환경을 소개한 논문이다.
- Madaan et al. (NeurIPS 2023), Self-Refine. 2장에서 대비시키는 방법으로, 생성 한 번으로 끝나는 과제에서 피드백과 수정을 반복한다.
- Chen et al. (ICLR 2024), Teaching Large Language Models to Self-Debug. 이 논문이 ground truth test case에 기댄다고 비판한 코드 디버깅 쪽 경쟁 방법이다.
- Huang et al. (ICLR 2024), Large Language Models Cannot Self-Correct Reasoning Yet. 외부 피드백 없이는 LLM이 추론을 스스로 고치지 못한다고 반박하는 논문이다. Reflexion의 오라클 문제와 함께 읽으면 좋다.
- Tyen et al. (Findings of ACL 2024), LLMs cannot find reasoning errors, but can correct them given the error location. self-correction을 오류를 찾는 문제와 고치는 문제로 나눠서 다시 보는 논문이다.