Return or Revise? Learning When Revision Helps Retrieval-Augmented QA
검색 근거로 초안을 고칠지는 '초안이 맞나'가 아니라 '고치면 고침-망침이 어떻게 되나'로 정해야 하며, 초안 대신 근거로 새로 푼 답(standard RAG)과 고를 수 있으면 수정은 더할 가치가 없다.
검색 없이 만든 초안을 검색 근거로 고칠지, 그대로 낼지를 학습하는 논문이다. RARR처럼 검색으로 답을 점검하고 수정하는 방법에서도, 수정이 맞는 답을 틀리게 바꿀 수 있다. 이 논문은 고칠지 말지를 수정하기 전에 결정하는 문제로 따로 떼어 측정한다. 수정 효과를 예측하는 정책이 얼마나 나은지에 더해, 초안을 보지 않고 근거로 새로 푼 답을 선택지에 넣으면 수정의 가치가 어떻게 달라지는지도 비교한다.
- 저자: Nicholas Kashani Motlagh (DCS Corp), Tim Anderson, Jeremy Gwinnup, Grant Erdmann (Air Force Research Laboratory)
- 게재: arXiv preprint, 2026 (arxiv.org/abs/2609.30087)
- 코드: 실험 코드, 생성 답안, 학습 정책은 공개되지 않았다. 부록 B와 C에 분할 규칙, 프롬프트, 모델 리비전 등 재현을 위한 세부 정보가 있다.
0. 한 줄 요약
초안의 정답 여부에 더해 수정의 이득과 손해를 예측하면 선택이 조금 나아지지만, 실험한 설정에서는 초안과 standard RAG 답 중 고르는 정책에 수정안을 더해도 유의한 정확도 향상이 없었다.
1. 문제 정의
논문 Figure 2에 실린 예시가 문제를 잘 보여 준다. TriviaQA에서 "헨리 8세의 두 번째 아내는?"이라고 물으면 초안은 Anne Boleyn으로 맞게 답한다. 그런데 DPR이 가져온 문단에 Anne Boleyn의 처형과 함께 Anne of Cleves와의 결혼이 나오고, 수정 모델은 정답이던 초안을 같은 문단에 있는 다른 이름 Anne of Cleves로 바꿔 버린다. 반대로 NQ-Open의 "Going to Kansas City를 쓴 사람은?"에서는 초안이 Charlie Christian으로 틀렸지만, 문단에 Leiber and Stoller가 명시돼 있어서 제대로 고쳐진다.
초안 하나와 수정안 하나를 같은 판정기로 채점하면 결과는 네 칸으로 나뉜다. 초안과 수정안이 모두 맞거나 모두 틀리면 달라진 게 없다. 틀린 초안이 맞게 바뀌면 repair, 맞던 초안이 틀리게 바뀌면 harm이다. Fig. 1에서 초안의 정답 여부는 행만 알려 준다. 수정이 도움이 될지는 수정안의 정답 여부까지 함께 봐야 알 수 있다. 같은 오답 초안도 고쳐지거나 그대로 틀릴 수 있고, 같은 정답 초안도 보존되거나 망가질 수 있다.
평균 정확도만 봐서는 이 차이를 알 수 없다는 것이 §2의 논증이다. 두 수정 방식이 모두 정확도를 3점 올린다고 하자. 하나는 초안의 3%를 repair하고 harm이 0이라서 무조건 수정하면 된다. 다른 하나는 13%를 repair하고 10%를 harm한다. 평균은 같지만 두 번째 경우에는 수정이 맞는 답을 망가뜨리는 열 개 중 하나를 미리 알아보는 정책이 의미가 있다. 그래서 논문은 답마다 어디로 가는지를 직접 관측하고 예측하자고 한다.
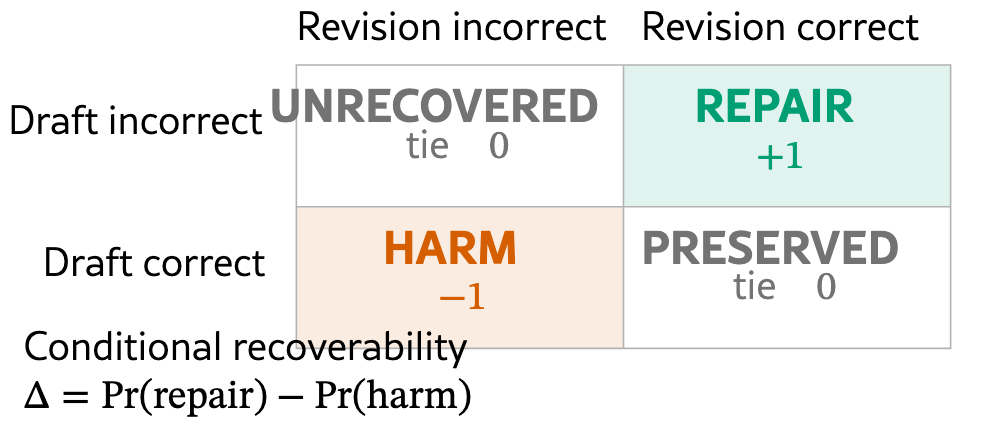
Fig. 1. 초안과 수정안을 함께 채점한 네 가지 결과. 대각선은 정답 여부가 유지되는 경우이고, 음영 칸은 repair와 harm이다.출처: Kashani Motlagh et al., arXiv 2026, Figure 1, CC0 1.0.
2. 기존 방법들의 한계
논문은 이 설정을 이웃한 결정들과 구분한다. selective prediction은 현재 답을 믿을지를 확신도로 정한다. adaptive RAG는 검색을 할지, 어떻게 할지를 검색 전이나 검색 중에 정한다. 이 논문의 결정은 검색이 끝나고 수정을 디코딩하기 직전에 일어나므로 시점이 다르다. Tian et al. 같은 검색 효용 예측 연구는 근거가 새 답에 도움이 되는지를 보는데, 여기서는 이미 있는 초안의 수정이 대상이다. 저자들은 검색 효용 예측 구조를 수정 여부 결정에 맞춘 Tian-style 회귀 기준선을 둔다. 다만 Tian et al.의 학습된 검색 품질 예측기를 그대로 재현한 것은 아니다.
확신도의 한계를 저자가 얼마나 강하게 주장하는지는 조심해서 읽어야 한다. 논문은 모델 cascade에서 확신도만으로 충분한 경우가 많다는 Jitkrittum et al.의 결과를 인용하고, 자기 비교는 "검색 근거로 수정하는 설정에서는 확신도가 얼마나 충분에 가까운가"를 재는 것이라고 말한다. 실제로 뒤에서 보겠지만 draft correctness를 학습한 모델이 이득의 상당 부분을 이미 가져간다. 확신도가 틀렸다는 주장이 아니라 확신도가 어디까지 가는지를 측정한 논문에 가깝다.
3. 방법
핵심 아이디어는 수정 전 결정의 학습 목표를 초안의 정답 여부에서 짝지은 수정 효과로 바꾸는 것 하나다. 나머지는 그걸 측정하고 비교하기 위한 장치다.
파이프라인은 이렇다. Llama 3.1 8B Instruct가 질문에 검색 없이 초안을 쓰고, DPR, BM25, BM25 뒤에 MonoT5 reranking을 적용한 검색기가 각각 같은 Wikipedia 자료에서 문단 5개를 가져온다. 같은 Llama가 질문, 초안, 근거를 보고 수정안을 쓴다. 이 논문에서는 retriever, 근거 프롬프트, 수정 모델을 묶어 revision setup이라고 부른다. Llama 3.3 70B 판정기는 초안과 수정안을 각각 허용 정답 목록과 비교해 의미상 정답인지 채점한다. 초안의 정답 여부를 , 수정안의 정답 여부를 라고 하면 예제 하나의 결과와 수정 효과는 다음과 같다.
가 +1이면 repair, −1이면 harm, 0이면 변화가 없다. 는 수정 직전까지 볼 수 있는 입력이고, 는 결국 repair 확률에서 harm 확률을 뺀 값이다. 정책은 예측한 가 개발 데이터에서 정한 threshold보다 크면 수정하고 아니면 초안을 낸다. 수정안, 정답, 판정 결과는 입력에 들어가지 않는다.
Table 1의 DPR 숫자로 계산해 보면 이 정의가 잘 이해된다. 초안을 그대로 내면 정확도가 47.38%다. 전부 수정하면 repair 9.32%가 더해지고 harm 3.05%가 빠져서 47.38 + 9.32 − 3.05 = 53.65%가 된다. 두 답의 판정 결과를 미리 아는 oracle은 정답으로 채점된 답이 있으면 그쪽을 고르므로 47.38 + 9.32 = 56.70%다. 평가한 설정에서는 전부 수정이 두 고정 전략 중 더 나았으므로, oracle과 전부 수정의 정확도 차이는 각 설정의 harm 비율과 같다. DPR에서는 56.70 − 53.65 = 3.05점이다. 이것은 자동 판정 결과에 따른 상한이다. 두 답이 모두 오답으로 채점되면 oracle도 실패하고, 판정기 자체의 오류도 남는다.
결정 모델은 크게 두 계열이다. 고정된 hidden state 위에 Ridge, Linear, MLP를 얹은 모델과 attention pooling 모델이 있고, 수정 모델과 같은 Llama를 rank 16 LoRA로 학습한 모델이 있다. LoRA의 학습 파라미터는 약 4,200만 개다. 신경망 분류기는 repair, harm, tie를 예측하고 repair와 harm의 softmax 출력 차이를 점수로 쓴다. 이 출력을 보정된 확률로 검증한 것은 아니다. 입력은 질문만 주는 경우, 질문과 초안을 주는 경우, 지시문과 근거 5개까지 담은 전체 프롬프트를 주는 경우로 나눈다.
비교의 공정성을 위해 같은 LoRA, 같은 전체 프롬프트, 같은 학습 예산, 같은 시드로 두 모델을 따로 학습한다. 하나는 초안이 맞는지를, 다른 하나는 수정 효과를 맞히도록 한다. 두 모델 모두 근거를 읽는다는 점이 이 비교의 핵심이다. 다만 예측 대상에 맞춰 출력 head와 체크포인트 선택 규칙은 달라진다.
이 방법에는 전제가 있다. 학습 데이터 134,847개에 대해 수정안을 실제로 만들고 정답 기준으로 채점해야 라벨이 생긴다. 정답 라벨은 학습·개발 단계에서 정책을 학습하고 임계값을 고르는 데 쓰고, 배포 시점에는 정책이 수정 직전의 정보만 보고 확률을 예측한다. 예측이 완전하지 않으므로 harm을 일으킬 수정도 일부 선택한다. 또 초안과 수정을 같은 모델이 하고, 짧은 답을 요구하는 오픈 도메인 QA만 다룬다.
4. 실험 결과
학습은 NQ-Open과 TriviaQA의 134,847개, 개발은 14,966개로 한다. 테스트는 25,870개이고 NQ-Open 3,610개, TriviaQA 7,993개, PopQA 14,267개로 이루어진다. PopQA는 학습 분할이 없어서 평가에만 쓰이며 테스트의 55%를 차지한다. 학습 시드 3개의 평균과 표준편차를 보고하고, 세 시드의 차이에 대한 양측 paired t-test로 유의성을 표시한다. 유의수준은 0.05이고 다중 비교 보정은 하지 않았다. 아래 주 결과의 정확도와 repair·harm은 Llama 3.3 70B의 정답 판정에 따른 수치다.
먼저 repair와 harm이다(Table 1, DPR). 수정은 초안의 9.32%를 고치지만 3.05%를 망친다. 전부 수정은 53.65%로 초안만 내는 47.38%보다 높지만, harm이 모든 설정에 남아 있다. MonoT5 reranking은 repair를 13.42%로 늘리지만 harm은 3.06%로 그대로다. 학습한 정책은 DPR에서 54.91 ± 0.18%를 얻는다. 전부 수정보다 1.26점 높고, oracle 격차 3.05점의 약 41%를 메운 셈이다. 세 설정 전체로는 1.101.33점, 격차의 35.941.4%다. 정책은 repair의 96.0 ± 1.1%를 선택하는 반면 harm의 46.4 ± 8.9%도 여전히 선택한다. 정확도 개선이 남아 있어도 해로운 수정을 잘 가려냈다고 보기는 어렵다.
핵심 비교는 수정 효과 예측과 draft correctness 예측이다. Table 2는 각 정책이 개발 데이터로 고른 임계값의 결과를, Fig. 2는 같은 수정 비율에서의 차이를 보여 준다. 수정 효과를 학습한 모델은 아홉 개 설정-시드 조합에서 모두 accuracy–revision-rate 곡선 아래 넓이가 더 컸다. 차이가 가장 벌어지는 지점은 대개 revision rate가 낮은 구간이고 그 크기는 1.373.06점이다. 각자 개발 데이터에서 고른 threshold에서의 정확도 차이는 DPR에서 +0.68점으로 시드 간 검정을 통과하고, BM25는 +0.23점으로 한 시드에서 음수이며, MonoT5는 +0.33점으로 p=0.058이다. 1.101.33점의 이득 중 draft correctness만으로 0.581.11점이 나오고 수정 효과를 직접 예측하면 0.230.68점이 더해진다. DPR에서 draft correctness 정책은 전체의 57.8 ± 2.0%를 수정하며 harm의 74.1 ± 3.6%를 선택한다. 수정 효과 정책은 전체의 38.8 ± 5.1%를 수정하며 harm의 46.4 ± 8.9%를 선택한다. 두 정책의 revision rate가 달라서 단순 비교는 어렵지만 방향은 이해가 된다. 근거 없이 초안만 보고 "맞나?"를 묻는 verbalized P(true)는 8593%를 수정하고 전부 수정보다 +0.030.09점만 낫다.
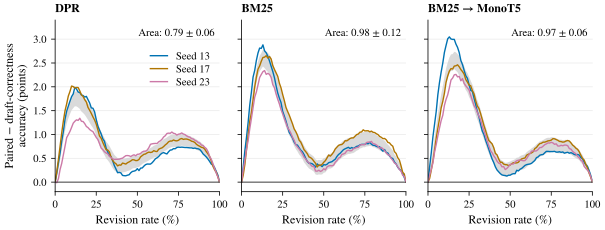
Fig. 2. 같은 수정 비율에서 수정 효과 예측 정책의 정확도에서 draft correctness 정책의 정확도를 뺀 값. 선은 학습 시드이고 회색 띠는 시드 평균의 95% bootstrap 구간이다. 면적 표기는 차이를 적분한 값의 시드 평균과 표준편차다.출처: Kashani Motlagh et al., arXiv 2026, Figure 3, CC0 1.0.
어떤 정보가 신호를 주는지는 입력 소거로 확인한다. 근거를 바꾼 결과는 Table 11, 입력과 모델 종류를 함께 비교한 결과는 논문 Figure 4에 있다. 질문만으로는 신호가 거의 없다. 같은 LoRA에서 근거를 가리거나 다른 질문의 근거로 바꾸면 이득이 1.101.33점에서 0.180.25점으로 줄어든다. 초안을 지우면 0.56~0.69점이 남는다. 반면 고정 hidden state 위의 모델은 전체 프롬프트를 줘도 oracle 격차의 13.5% 이상을 메우지 못했다. 다만 고정 특징 모델과 LoRA 사이에는 학습 방식과 파라미터 수 차이도 있다. 그래서 저자들은 같은 LoRA에서 입력만 바꾸고 각각 다시 학습한 소거 결과를 따로 제시한다. 이것은 필요한 입력을 비교한 것이며, 이미 학습된 정책이 어느 입력을 실제로 쓰는지 직접 측정한 결과는 아니다.
harm 사례는 비슷하지만 다른 대상을 말하는 근거를 충실히 따른 경우가 많다. NQ-Open에서 Golden State Warriors의 첫 우승을 물으면 초안 1947은 맞는데, 가져온 문단이 20152018년 팀에 관한 것이라 수정안은 2015가 된다. PopQA에서 The Terminal의 각본가를 물으면 The Terminator 문단이 들어와 맞던 Sacha Gervasi가 William Wisher Jr.로 바뀐다. Table 7을 보면 근거 문단 중 정답 별칭이 하나도 없을 때 맞은 초안의 harm 비율이 DPR 16.5%, MonoT5 21.1%이고, 3개 이상일 때는 2.22.7%다.
가장 중요한 결과는 standard RAG와의 비교다(Table 4). standard RAG는 초안을 보지 않고 질문과 근거만으로 새로 푼 답이다. Llama에서 이 답은 단독으로는 전부 수정보다 약하다(DPR 49.12% 대 53.65%). 이 비교에서는 세 답의 정답 여부를 각각 예측하는 별도의 per-action 모델을 학습한 뒤, 같은 모델을 고정하고 허용하는 선택지만 바꾼다. DPR에서 초안과 standard RAG 중 고르면 57.08%, 초안과 수정안 중 고르면 55.03%로 2.05점 차이다. 앞서 나온 54.91%는 세 가지 수정 결과를 학습한 별도 정책의 수치다. 세 설정에서 1.952.10점이고 모두 시드 간 검정을 통과한다. 여기에 수정안을 세 번째 선택지로 더해도 −0.150.00점이라 유의한 이득이 없다. 수정안만 정답인 예제는 181, 222, 323개로 oracle을 올려 주지만, 학습한 정책은 그중 724%만 잡고 정답이던 선택을 수정안으로 바꿔 잃는 경우가 더 많다. Llama에서 standard RAG가 단독 정확도는 낮아도 도움이 되는 이유는, 초안이 틀린 문제에서 수정안보다 더 자주 맞기 때문이다. 틀리는 예제가 서로 다르게 겹치니 둘을 짝지으면 보완된다. OLMo 3 7B에서는 standard RAG가 단독으로도 수정보다 강하고 두 선택 집합의 차이가 4.04.6점으로 벌어진다.
판정기 의존성도 확인한다. 2차 판정기 GPT-OSS-120B로 다시 채점하면 답 하나 단위의 일치도는 96.596.7%(κ=0.93)다. 판정기를 바꿔도 이득의 부호는 유지되지만 harm이 가장 불안정해서 1차 판정이 harm으로 본 답 중 85.786.7%만 harm으로 남는다. 저자가 아닌 사람 한 명이 480쌍을 라벨링한 점검에서는 판정 가능한 답을 기준으로 초안 93.2%(κ=0.86), 수정안 91.6%(κ=0.83) 일치했다. 다른 생성 모델에서는 이득이 달라지는데, GPT-OSS-20B는 0.120.19점으로 작다. harm이 적어 oracle 격차 자체가 1.241.64점으로 작다는 점이 한 이유다. 다만 그 격차를 메우는 비율도 9.911.6%로 Llama의 35.941.4%보다 낮으므로, 작은 상한만으로 차이를 설명할 수는 없다.
5. 읽으면서 든 의문
첫 번째는 근거가 선택 성능에 얼마나 기여했는지에 대한 내 의문이다. P(true)는 근거도 보지 않고 학습도 하지 않았고, LoRA draft correctness 모델은 근거를 읽으면서 학습까지 했다. 그래서 두 결과의 차이를 "근거를 본 효과"라고 부를 수는 없다. 근거를 가린 소거는 수정 효과 정책에만 있어서, draft correctness 쪽에서는 근거가 기여한 몫을 따로 말할 수 없다. 이 비교의 핵심 기준선은 같은 입력과 학습 예산을 쓰는 draft correctness 모델이다. P(true)와의 큰 차이만 보고 수정 효과라는 학습 목표의 이득으로 해석하면 과장이다.
두 번째는 정답 라벨 의존이다. 정책 학습에 정답 기준으로 채점한 13만 개 이상의 수정 결과가 필요하다. 배포 시점에는 정답이 필요 없지만, 이 데이터를 만드는 비용이 결과의 전제다. PopQA는 평가에만 썼으므로 학습 데이터와 다른 질문 집합에 대한 결과도 포함한다. 다만 이 결과를 라벨 수를 줄여 학습한 정책의 성능으로 해석할 수는 없다. 저자도 장문, 멀티홉, 특정 도메인, 고위험 설정은 검증하지 않았다고 Limitations에서 밝힌다.
세 번째는 판정기에 대한 민감도다. 오라클 격차가 곧 harm 비율인데, harm이 판정기 간에 가장 불안정한 지표다. 핵심 분모가 판정기에 흔들리는 셈이다. 사람 검증도 한 명이어서 판정기의 오류와 라벨러 개인의 편향을 구분하지 못하고, 저자들도 이 점을 인정한다. 사람 라벨로 본 순 효과는 +2.8점이고 95% bootstrap 구간이 [−0.6, +6.1]로 0을 포함하며 TriviaQA 추정은 음수다. 이 수치는 처음 뽑은 480쌍 중 두 답에 확정 라벨이 있는 470쌍에 대한 것이다. 표본은 세 데이터셋에서 160쌍씩, DPR과 BM25에서 균등하게 뽑았다. 전체 테스트 분포를 그대로 대표하지 않으며, 이 순 효과는 학습 정책의 추가 이득을 사람 평가로 검증한 수치도 아니다.
네 번째는 변동성이다. 학습 시드는 정책 학습만 바꾸고 초안과 수정안은 greedy로 한 번만 만들었다. 저자들은 Limitations에서 이 시드 비교가 생성이나 판정기 샘플링의 분산을 측정하지 않는다고 밝힌다. 게다가 draft correctness와의 차이는 0.23~0.68점으로 작고, DPR에서만 검정을 통과하며, 시드가 3개뿐이라 검정의 힘도 약하다. 내 해석으로는, 수정 효과 예측의 장점은 선택된 임계값의 정확도보다 아홉 개 조합에서 일관되게 컸던 곡선 아래 넓이에서 더 분명하게 드러난다.
다섯 번째는 이 논문의 두 메시지가 서로를 깎는다는 점이다. 하나는 수정 효과 예측이 약간 낫다는 것이고, 다른 하나는 평가한 선택 집합에서 standard RAG를 더하면 수정안의 추가 이득이 유의하지 않았다는 것이다. 두 번째가 첫 번째의 실용 가치를 상당 부분 상쇄한다. 내 해석으로는, 수정 여부를 잘 고르는 방법의 기여를 이 선택지 비교까지 포함해 평가해야 한다. 다만 standard RAG를 한 번 더 생성하는 비용은 비교에 반영되지 않았고, 저자도 §5.6에서 이 점을 명시한다. 또 "유의하지 않다"는 "동등하다"와 같지 않다는 점도 Limitations에 적혀 있다. 개인적으로는 초안이 검색 없이 만들어져서 오류가 지식이 부족한 쪽에 몰려 있을 수 있다고 생각한다. 초안이 이미 검색을 한 설정에서도 결과가 유지되는지는 이 논문만으로는 알 수 없다.
6. 정리
이 논문의 강점은 수정 전후를 짝지어 채점하고, 추가 이득을 같은 조건의 기준선과 비교한 평가 방식에 있다. 초안과 수정안을 같은 판정기로 모두 채점하니 repair, harm, oracle 격차가 모두 관측 가능해졌고, "평균 정확도가 올랐다"로 가려지던 harm이 별도의 지표로 드러났다. 같은 LoRA와 같은 입력, 같은 예산으로 목표만 바꾼 비교도 설득력이 있었다. 반면 핵심 방법의 추가 이득은 0.23~0.68점으로 작고 한 설정에서만 시드 간 검정을 통과한다. 실용적인 결론이 standard RAG와 고르는 쪽으로 귀결되어서 방법 자체의 기여는 제한적이다. 범위도 짧은 답 오픈 도메인 QA, 20B 이하 모델, Wikipedia 한 가지로 좁다.
7. 같이 읽어볼 논문
- Gao et al., RARR, ACL 2023. 검색으로 답을 사후에 조사하고 고치는 시스템이다. 이 논문이 수정 시스템의 배경으로 인용한다.
- Jitkrittum et al., When Does Confidence-Based Cascade Deferral Suffice?, NeurIPS 2023. 확신도만으로 충분한 경우와 아닌 경우를 다룬다. 이 논문이 draft correctness와 수정 효과 예측의 차이를 해석하는 배경이다.
- Huang and Deng, CounterRefine, 2026. 답안에 조건화한 반증 근거를 검색해 keep-or-revise를 결정한다. 이 논문이 관련 연구로 인용한다.
- Ning et al., Revision or Re-Solving?, COLM 2026. 2차 수정의 이득을 분해한다. 수정과 새로 풀기를 가르는 문제의식이 standard RAG 결과와 맞닿아 있다.