Revisiting Uncertainty Quantification Evaluation in Language Models: Spurious Interactions with Response Length Bias Results
UQ 방법과 정답 판정 함수가 같은 변수(응답 길이)에 함께 끌려가면 AUROC에 잡음이 아니라 편향이 생기고 방법 간 순위가 뒤집힌다
LLM 불확실성 추정 논문을 읽다 보면 결과를 AUROC로 정리한 경우가 많다. 그런데 AUROC를 계산하려면 먼저 각 답이 맞았는지 틀렸는지 정해야 하고, 이 일은 대개 ROUGE 같은 자동 지표가 맡는다. 이 논문은 바로 그 채점 단계가 공정한지를 따진다. 새 UQ 방법을 제안하는 논문이 아니고 평가 방법을 다시 점검하는 논문이다. 실험 셋업은 semantic entropy 논문(Farquhar et al., Nature 2024)의 공개 코드를 따랐다고 적혀 있어서, 그 논문과 이어서 읽기 좋았다.
- 저자: Andrea Santilli, Adam Goliński (공동 1저자), Michael Kirchhof, Federico Danieli, Arno Blaas, Miao Xiong, Luca Zappella, Sinead Williamson (Sapienza University of Rome, Apple, NUS)
- 게재: ACL 2025 Short Papers, arXiv 2504.13677
- 코드: 논문에 공개 링크가 없다. 평가 셋업은 jlko/semantic_uncertainty를 따랐다고만 적혀 있다(App. D).
0. 한 줄 요약
UQ 방법과 정답 판정 함수가 둘 다 응답 길이에 영향을 받으면, AUROC가 단순히 흔들리는 데 그치지 않고 특정 방법 쪽으로 치우치게 되어 방법 간 순위가 뒤바뀐다는 논문이다.
1. 문제 정의
UQ 방법은 답마다 "이 답을 얼마나 못 믿겠는가"를 점수로 매긴다. 좋은 UQ 방법이라면 맞은 답에는 낮은 점수를, 틀린 답에는 높은 점수를 줘야 한다. 그런데 불확실성의 정답값이라는 건 없으니, 보통은 질문을 바꿔서 평가한다. 불확실성 점수가 맞은 답과 틀린 답을 얼마나 잘 갈라내는지를 보는 것이고, 그 지표가 AUROC다.
맞은 샘플 하나와 틀린 샘플 하나를 무작위로 골랐을 때, 맞은 쪽의 불확실성이 더 낮게 나올 확률이다. 불확실성이 낮은 순서로 답을 줄 세우고 O/X를 붙였을 때, O가 X보다 앞에 선 쌍의 비율이라고 생각하면 쉽다.
문제는 참 정답 여부 를 실제로는 모른다는 점이다. 그래서 참조 답과 비교해 맞음/틀림을 매기는 함수 를 대신 쓴다. 논문은 이를 correctness function이라고 부르고, 이 글에서는 정답 판정 함수라고 쓰겠다. 결국 우리가 재는 값은 진짜 AUROC가 아니라 로 계산한 추정치 이고(Eq. 3), 판정 함수가 틀리는 만큼 이 값도 틀어진다.
저자들이 길이를 문제 삼는 이유는 이렇다. 가장 단순한 UQ 방법인 음의 시퀀스 확률은 인데, 토큰 확률이 모두 1보다 작으니 답이 길어지기만 해도 불확실성이 올라간다(Eq. 1). 내가 숫자를 넣어 보면, 토큰마다 0.9로 똑같이 자신 있어도 3토큰 답은 0.9³ ≈ 0.73, 10토큰 답은 0.9¹⁰ ≈ 0.35가 된다. 한편 ROUGE-L F1은 참조 답이 짧을 때 긴 답의 정밀도를 깎는다. 내가 만든 예로 보면, 참조 답이 "Paris"이고 모델이 "The Eiffel Tower is located in Paris, France."라고 답하면 정밀도가 1/8이라 F1이 0.22 정도밖에 안 되고, 임계값을 0.3으로 두면 맞는 답인데도 오답으로 처리된다.
그러면 맞았지만 긴 답이 "불확실함"과 "틀림"을 한꺼번에 받는다. 두 판정이 잘못된 이유로 맞아떨어지니 AUROC는 오히려 올라간다. 직접 작은 예를 만들어 보면 감이 온다. 불확실성 순으로 세운 답 6개의 실제 정답 여부가 O X O O X O라면 AUROC는 0.5로 동전 던지기 수준이다. 그런데 뒤쪽의 맞은 긴 답 2개를 ROUGE가 X로 바꾸면 O X O X X X가 되고, AUROC는 약 0.88로 뛴다. 방법의 실력은 그대로인데 성적만 부풀었다.
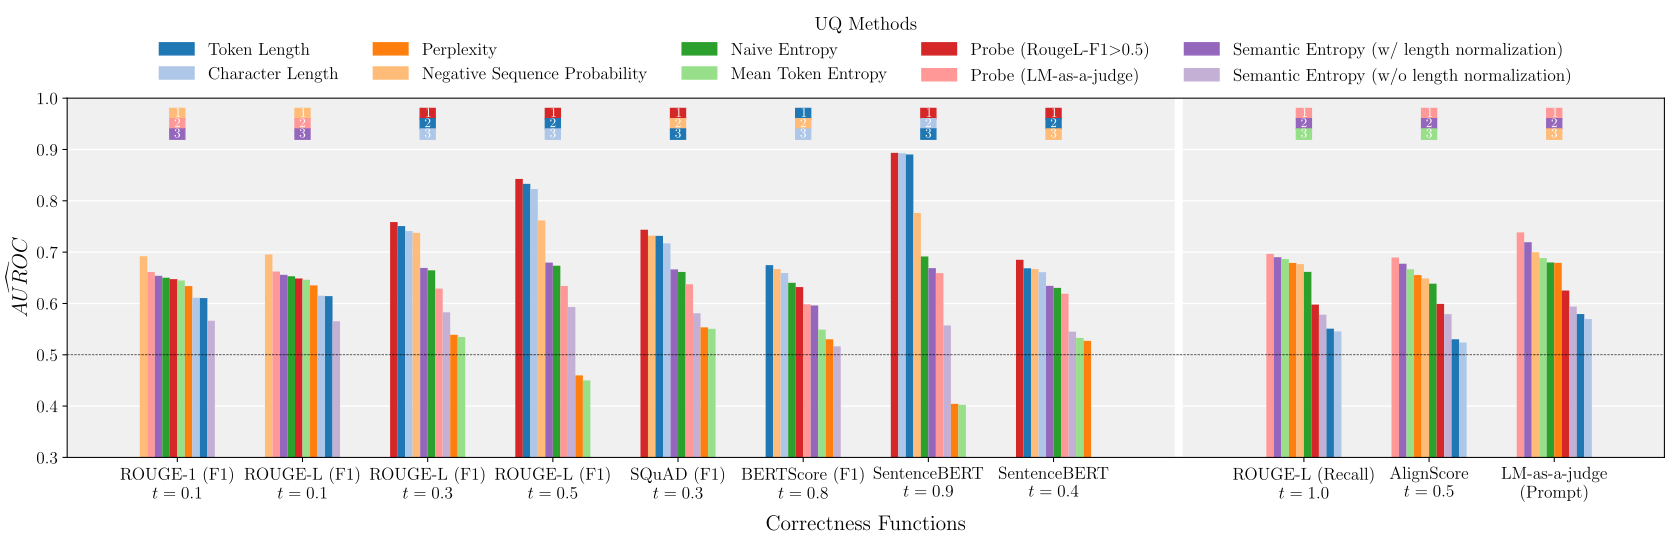
Fig. 1. 정답 판정 함수만 바꿔 가며 잰 UQ 방법별 (모델·데이터셋 평균). 맨 위 행의 순위가 판정 함수마다 달라진다. 파란 막대는 토큰 수·글자 수를 그대로 불확실성 점수로 쓴 길이 기준선이다. (논문 Figure 1) 출처: Santilli et al., ACL 2025 (CC BY 4.0)
그 결과가 Fig. 1이다. 길이 기준선은 lexical·embedding 판정 함수 기준에서는 꽤 경쟁력 있게 나오는데, LM-as-a-judge 기준에서는 꼴찌로 떨어진다(§3.3). 답 길이만 보는 "방법"이 좋아 보인다는 것 자체가 채점이 길이에 휘둘리고 있다는 신호다.
2. 기존 방법들의 한계
논문이 다루는 정답 판정 함수는 세 부류다. ROUGE-1, ROUGE-L, SQuAD F1처럼 단어가 얼마나 겹치는지 보는 lexical 계열, BERTScore와 SentenceBERT 코사인 유사도처럼 임베딩을 비교하는 embedding 계열, 그리고 다른 언어 모델에게 판정을 맡기는 LM-as-a-judge 계열이다. 마지막 부류에는 판정용으로 따로 학습된 AlignScore와, 프롬프트로 큰 모델에게 묻는 방식이 함께 들어간다.
Table 1을 보면 최근 UQ 논문들이 이 함수들을 제각각 골라 쓰고 있다. ROUGE-L F1을 0.5로 자른 논문(Fadeeva et al., Kuhn et al., Duan et al., Chen et al.)이 있는가 하면, SQuAD F1을 0.3으로 자른 논문(Farquhar et al.), SentenceBERT를 0.9로 자른 논문(Chen et al.), AlignScore를 0.5로 자른 논문(Vashurin et al.)도 있다. 임계값을 0.1부터 1.0까지 훑은 논문도 있다. AUROC에는 이진 라벨이 필요하니 연속 점수를 내는 함수는 어딘가에서 잘라야 하는데, 이 선택에 통일된 기준이 없다.
lexical 계열이 원래 어디서 쓰이던 지표였는지도 짚는다(App. B.1). 이 지표들은 출력 형식이 데이터셋의 참조 답 형식에 맞춰 학습된 QA 시스템을 평가하던 것이다. zero-shot으로 문장을 생성하는 LLM은 그 형식을 따른다는 보장이 없다. few-shot 예시를 넣으면 조금 나아지지만 근본적인 해결은 아니라고 본다.
요약 평가에서 지표가 길이에 치우친다는 건 이미 알려진 사실이고(Guo & Vosoughi 2023), 저자들은 이를 인용으로 처리한다. 이 논문의 몫은 그 치우침이 UQ 평가로 번져 방법 순위까지 바꾼다는 점을 보인 것이다. 다만 개인적으로는 "UQ 평가에 미치는 영향은 거의 탐구되지 않았다"는 신규성 서술을 조금 덜어 읽었다. App. C 첫머리에서 저자들 스스로 동시 연구인 Ielanskyi et al. (2025)이 비슷한 분석을 했다고 밝힌다.
3. 방법
이 논문의 핵심은 구분 하나다. 판정 함수의 오류가 UQ 점수와 무관하면 AUROC 왜곡은 잡음일 뿐이고, 오류가 UQ 점수와 엮여 있으면 한쪽으로 치우친 편향이 된다. 판정 함수 7종 비교, 사람 평가, 길이 상관 분석은 모두 이 엮임이 실제로 있다는 걸 보이기 위한 증거다.
먼저 이론 쪽(App. C)이다. 판정 함수의 오류가 참 라벨이 주어졌을 때 UQ 점수와 독립이라고 가정하면, 는 이렇게 풀린다(Eq. 9).
라벨상으로는 (맞음, 틀림)인 쌍이 실제로는 네 종류로 섞여 있다는 뜻이다. 앞의 두 항은 사실 같은 부류끼리 묶인 쌍이라 어떤 UQ 방법이든 0.5만큼만 기여한다. 세 번째 항은 진짜 (맞음, 틀림) 쌍이라 원래 AUROC가 그대로 들어가고, 네 번째 항은 라벨이 뒤집힌 쌍이라 반대 방향으로 계산된다. 중요한 건 계수가 전부 판정 함수의 성질이고 UQ 방법 는 들어 있지 않다는 점이다. 그래서 모든 UQ 방법에 똑같은 선형 변환이 걸리고, 이면 기댓값 기준으로 순위가 유지된다. 값은 0.5 쪽으로 끌려가지만 줄 세우기 결과는 같다.
기호 하나는 조심해서 읽어야 한다. 이 논문에서 TPR은 , 즉 판정 함수가 맞다고 한 것 가운데 실제로 맞은 비율이다. 흔히 쓰는 TPR이 아니라 정밀도에 해당하는 정의라서 처음 읽을 때 헷갈렸다.
수식만으로는 잘 와닿지 않아서 숫자를 넣어 봤다. 판정 함수 정확도가 80%라면 100쌍 중 진짜 쌍이 64, 뒤집힌 쌍이 4, 같은 부류 쌍이 32다. 이 비중은 판정 함수로만 정해진다. 실제 AUROC가 0.9인 방법 A는 57.6 + 0.4 + 16 = 74로 0.74, 0.7인 방법 B는 44.8 + 1.2 + 16 = 62로 0.62가 된다. 둘 다 깎이지만 순위는 그대로다. 그런데 판정 오류가 길이와 엮여 있고 B가 길이에 민감한 방법이라서 같은 부류 쌍 32개를 전부 "맞힌다"고 해 보자. 그러면 B는 44.8 + 1.2 + 32 = 78로 0.78이 되어 A를 앞지른다. 극단적으로 잡은 예지만 Case 2가 말하는 상황이 바로 이거다.
독립 가정이 깨지는 Case 2에서는 판정 오류가 UQ 점수와 음의 상관이면, 즉 UQ 방법이 자신 있어 하는 답일수록 잘못 "맞음"으로 찍히면 모든 에 대해 조건부 확률이 커져서 가 된다. 양의 상관이면 반대로 과소평가된다. 이 오차는 UQ 방법마다 달라서 순위가 바뀔 수 있다.
App. C.2의 "Sources of Correlation"도 좋았다. 대부분의 UQ 방법과 판정 함수는 서로의 출력을 보지 않고 따로 계산된다(판정 함수 라벨로 학습하는 probe는 예외다). 그런데도 상관이 생기는 건 둘 다 같은 답 텍스트의 어떤 성질에 각자 반응하기 때문이다. 아이스크림 판매량과 익사 사고가 서로 영향을 주지 않아도 여름 더위 때문에 같이 움직이는 것과 같은 구조이고, 이 논문에서 더위 역할을 하는 게 길이다. 저자들은 길이 말고도 드문 단어 사용 같은 교란 변수를 예로 든다. 낯선 단어가 UQ 점수를 올리는 동시에 참조 답과 덜 겹쳐 맞은 답이 오답 처리될 수도 있다는 가설이다. 저자들은 이를 후속 과제로 남겼다.
실험 셋업은 이렇다. 데이터는 TriviaQA, SQuAD, NQ-Open, SimpleQA이고, SQuAD만 지문을 프롬프트에 넣은 open-book이다. 모델은 Falcon-7B-instruct, Qwen2.5-7B-Instruct, Mistral-7B-Instruct v0.1과 v0.3이다. Farquhar et al.의 long-form 설정 프롬프트("Answer the following question in a single brief but complete sentence.")로 greedy 디코딩했다. 내 생각에는 한 문장으로 답하게 한 탓에 짧은 참조 답과 길이 차이가 구조적으로 생긴다.
UQ 방법은 음의 시퀀스 확률, perplexity, mean token entropy, naive entropy, semantic entropy(길이 정규화를 한 것과 안 한 것), 그리고 probe 두 개까지 8종이다. 여기에 토큰 수와 글자 수를 그대로 쓰는 길이 기준선 2개가 붙는다. probe는 마지막 답 토큰의 표현 위에 logistic regression을 학습한 것인데, 하나는 LM-as-a-judge 라벨로, 다른 하나는 ROUGE 라벨로 학습했다. semantic entropy의 함의 판정에는 DeBERTa를 썼다. 프롬프트 판정은 Qwen2.5-72B-Instruct에 Farquhar et al.과 같은 프롬프트를 줬다.
사람 평가는 TriviaQA, NQ-Open, SimpleQA에서 150개씩, 총 450개 답에 사람 4명이 라벨을 붙였다. 답은 모두 Qwen2.5-7B-Instruct가 생성한 것이고, SQuAD는 지문까지 보여줘야 해서 뺐다(App. E).
4. 실험 결과
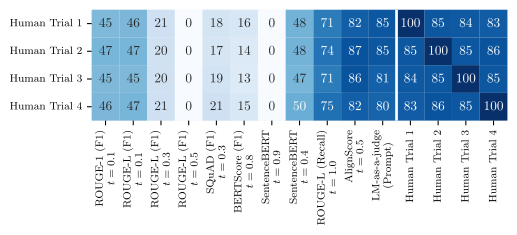
Fig. 2. 사람 평가자와 정답 판정 함수 사이의 Cohen's κ. 사람끼리의 일치도도 함께 표시되어 있다. (논문 Figure 2)출처: Santilli et al., ACL 2025 (CC BY 4.0)
Cohen's κ는 우연히 일치할 몫을 뺀 일치도다. 일치율이 높아도 한쪽이 거의 모든 답에 같은 라벨만 찍으면 κ는 0이 된다. Fig. 2에서 사람 4명 각각과의 κ는 LM-as-a-judge가 0.80–0.85, AlignScore가 0.82–0.87이고, 사람끼리는 0.83–0.86이다. 두 LM 판정의 κ는 사람끼리의 κ와 비슷한 수준이다. 개인적으로는 채점자로서 사람 한 명을 더 넣은 것에 가깝다고 읽었다. 그다음이 임계값 1로 자른 ROUGE-L Recall(0.71–0.75)이다.
반면 ROUGE-L F1을 0.5로 자르거나 SentenceBERT를 0.9로 자르면 κ가 0이다. 저자들은 임계값을 잘못 고르면 거의 모든 답에 같은 라벨이 붙어 사람과의 일치가 사라진다고 설명한다(§3.2). 내 해석으로는 한 문장으로 답하게 했으니 F1이 대부분 0.5 아래로 떨어져(앞의 에펠탑 예가 0.22였다), 그 같은 라벨이 "틀림"이었을 것이다. 문제는 이 설정이 Table 1에서 여러 UQ 논문이 실제로 쓰던 조합이라는 점이다.
임계값 민감도도 크다. 논문 Fig. 2·3에 따르면 ROUGE-L F1과 SentenceBERT는, 부록의 논문 Fig. 8에 따르면 BERTScore도 임계값에 따라 사람과의 일치도가 크게 오르내리고, 가장 좋은 임계값도 데이터셋마다 다르다. ROUGE-L Recall, AlignScore, LM-as-a-judge는 임계값을 바꿔도 비교적 안정적이다. Fig. 1로 돌아가 보면 사람과 잘 맞는 이 세 함수 기준으로는 UQ 방법 순위도 비교적 안정적이다. 저자들은 이를 오류가 작고 UQ 방법과 대체로 무관한 Case 1 상황으로 해석한다.
그다음이 원인을 길이로 좁히는 부분이다. 논문 Fig. 4는 각 점수와 응답 길이 사이의 Spearman 상관이다. 그림에서 읽으면 음의 시퀀스 확률은 길이와의 상관이 절댓값 0.9 안팎으로, 거의 길이를 재는 셈이라고 볼 수 있다. ROUGE-L F1(t=0.1)은 −0.7 안팎이고 LM-as-a-judge는 0에 가깝다. 흥미로운 건 probe다. ROUGE 라벨로 학습한 probe는 길이와 강하게 상관(절댓값 0.7 안팎)되고, LM 판정 라벨로 학습한 probe는 거의 무관하다. 개인적으로는 라벨에 있던 길이 편향이 그 라벨로 학습한 탐지기로 옮겨붙었다는 신호로 읽었다. 다만 이 해석에는 걸리는 점이 하나 있어서 5절에서 다시 다루겠다.
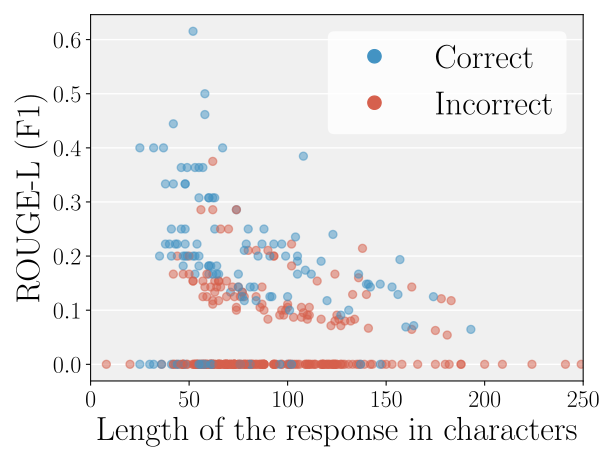
Fig. 3. 응답 길이에 따른 ROUGE-L F1 점수. 색은 사람의 정답 판정이고, 사람 4명이 모두 동의한 답만 그렸다. (논문 Figure 5a)출처: Santilli et al., ACL 2025 (CC BY 4.0)
판정 오류가 길이에 끌려간다는 더 직접적인 증거는 Fig. 3(논문 Fig. 5a)이다. 사람 전원이 맞다고 한 답도 길어질수록 ROUGE-L F1 점수가 내려가서, 하나의 임계값으로 맞은 답과 틀린 답을 가르기 어렵다. 같은 그림의 AlignScore 버전(논문 Fig. 5b)은 길이와 상관없이 맞은 답과 틀린 답을 뚜렷하게 가른다. 논문 Fig. 4와 달리 사람 라벨을 기준으로 놓고 보기 때문에, 점수가 아니라 판정 오류가 길이와 엮여 있다는 걸 보여 준다.
ROUGE-L Recall은 정의상 생성된 답 길이의 영향을 받지 않는다. 하지만 저자들은 이걸 권하지 않는다. 사람과의 일치도가 LM 판정보다 낮아 AUROC 값이 더 흔들리고, 길이 말고 다른 요인에 휘둘릴 가능성도 크다. 오답 여러 개 사이에 정답을 끼워 넣는 답에 악용될 수 있다는 약점도 지적한다(§3.3). 그래서 결론은 가능하면 LM-as-a-judge를 쓰라는 것이다. 저자들은 Fadeeva et al. (2023)에서 음의 시퀀스 확률이 높은 순위에 오른 것도 이 효과로 부풀려졌을 수 있다고 본다.
§4에서는 길이가 대표 사례일 뿐이라고 강조한다. UQ 방법과 판정 함수가 함께 반응하는 변수라면 무엇이든 같은 문제를 만든다. 예를 들어 LM-as-a-judge와 verbalized uncertainty를 함께 쓰면 어휘나 문체처럼 길이보다 훨씬 찾기 어려운 교란 변수가 생길 수 있다고 한다.
5. 읽으면서 든 의문
첫 번째는 논문 Fig. 4를 어떻게 읽느냐다. 이 그림에는 판정 함수와 길이의 상관도 함께 그려져 있는데, 이 값만으로는 편향이라고 보기 어렵다. 실제 정답 여부 자체가 길이와 상관된다면, 예를 들어 틀린 답이 원래 더 길다면 완벽한 판정 함수도 길이와 상관이 나온다. Janiak et al.의 The Illusion of Progress가 바로 틀린 답이 더 길다는 결과를 보고한다(§6.1). 따져야 할 건 점수와 길이의 상관이 아니라 판정 오류와 길이의 상관이다. 다행히 본문의 판정 함수 편향 논증은 사람 라벨을 기준으로 한 논문 Fig. 5·7에 기대고 있어서 이 점에서 올바른 방식이다. 다만 450개 중 균등 추출한 150개에서 사람 전원이 동의한 답만 그린 그림이라 근거로 쓰기엔 표본이 작다고 생각한다.
두 번째는 probe 학습 라벨 표기가 서로 맞지 않는다는 점이다. App. A에는 probe를 ROUGE-L (Recall) 0.5 기준 라벨로 학습했다고 적혀 있는데, Fig. 1과 논문 Fig. 4 범례에는 RougeL-F1>0.5로 나온다. Recall 라벨이라면 Recall 계산식에 생성 답의 길이가 들어가지 않으니, ROUGE 라벨 probe가 길이와 강하게 상관된 이유를 라벨의 길이 편향만으로는 설명하기 어려워진다. 4절에서 내가 한 "편향이 탐지기로 옮겨붙었다"는 해석이 이 표기 하나에 따라 맞기도 하고 틀리기도 해서, 이 논문에서 가장 아쉬운 부분이었다.
세 번째는 왜곡의 크기가 숫자로 나오지 않는다는 점이다. Fig. 1은 모델과 데이터셋을 평균한 막대이고 신뢰구간이 없다. 순위가 바뀐다는 게 논문의 주장인데도 신뢰구간이나 순위 변화량은 보고하지 않았다. 4개 모델 × 4개 데이터셋 중 어느 조합에서 순위가 실제로 뒤집히는지도 평균 막대 뒤에 가려져 있다. 데이터셋별 문항 수와 다중 샘플 방법의 샘플 개수 도 논문에 적혀 있지 않다.
네 번째는 길이를 직접 통제한 비교가 없다는 점이다. 지금은 상관 분석과 산점도로 정황을 쌓은 수준이다.
다섯 번째는 이론과 검증 범위다. Case 2는 치우침의 방향만 말하고, 상관이 클수록 차이가 커진다는 정성적인 서술 외에 크기의 경계는 유도하지 않았다. 사람 평가도 Qwen2.5-7B-Instruct 한 모델의 답에만 있어서, 4개 모델 전체의 결론을 받치기에는 약하다. 저자들이 Limitations에서 인정한 한계는 QA 과제만 다뤘다는 점, LM 판정의 비용과 자체 편향, judge 모델과 프롬프트 선택에 따라 신뢰도가 달라질 수 있다는 점, 같은 judge와 프롬프트가 다른 과제·데이터셋으로 일반화될지 모른다는 점, judge와 UQ에 같은 LM을 쓰면 상관이 생길 수 있다는 점, 길이 말고 다른 교란 변수는 살펴보지 않았다는 점이다. 사람 평가가 한 모델의 답에만 있다는 점은 App. E에 설정으로만 적혀 있고, 순위 변화량이 없다는 점과 함께 한계로 논의하지는 않았다.
6. 정리
이 논문에서 가장 설득력 있었던 건 App. C의 Eq. 9다. 판정 함수의 오류가 UQ 점수와 독립이면 값은 0.5 쪽으로 끌려가도 기댓값으로는 순위가 유지되고, 엮여 있으면 순위가 바뀔 수 있다는 걸 깔끔하게 갈라 놓았다. 덕분에 앞으로 UQ 평가를 할 때 무엇을 확인해야 하는지가 분명해졌다. 길이 기준선이 판정 함수에 따라 경쟁권에서 꼴찌로 오가는 Fig. 1, 사람이 맞다고 한 긴 답을 ROUGE-L F1이 깎아 버리는 Fig. 3(논문 Fig. 5a)은 그 조건이 실제 벤치마크에서 깨지고 있다는 걸 잘 보여준다.
약점은 왜곡의 크기를 숫자로 보이지 못했다는 점이다. 평균 막대만 있고 신뢰구간이나 순위 변화량이 없다. probe 라벨 표기가 서로 맞지 않아, 4절에서 내가 한 해석을 확인할 수 없다. 그래도 short paper 분량에서 이론과 사람 평가, 상관 분석을 한 방향으로 묶어 낸 점은 좋았다.
개인적으로 가져갈 교훈은, UQ 벤치마크에서 정답 판정 함수가 고정된 자가 아니라 그 자체로 실험 변수라는 점이다. 그리고 판정 함수와 UQ 방법이 함께 반응할 만한 답의 성질이 있는지부터 의심해 봐야 한다. 저자들도 결론에서 LM 판정을 권하면서, 새 과제나 데이터셋에 쓰기 전에 사람 라벨로 먼저 검증하라고 덧붙인다.
7. 같이 읽어볼 논문
- Farquhar et al. (Nature 2024), Detecting hallucinations in large language models using semantic entropy. 이 논문의 평가 셋업과 judge 프롬프트가 여기서 왔다. SQuAD F1 0.3과 LM 판정을 함께 쓴 원래 프로토콜을 확인해 볼 수 있다.
- Kuhn, Gal, Farquhar (ICLR 2023), Semantic Uncertainty. semantic entropy의 출발점이고, 이 논문의 Table 1에는 ROUGE-L F1 0.5를 쓴 논문으로 정리되어 있다.
- Fadeeva et al. (EMNLP 2023 Demo), LM-Polygraph. 이 논문이 음의 시퀀스 확률의 순위가 부풀려졌을 수 있다고 지목한 벤치마크다.
- Ielanskyi et al. (ICLR 2025 Workshop), Addressing pitfalls in the evaluation of uncertainty estimation methods for NLG. 판정 함수의 편향과 분산이 AUROC 추정에 미치는 영향을 비슷하게 분석한 동시 연구다.
- Janiak et al. (EMNLP 2025), The Illusion of Progress. 틀린 답이 더 길다는 결과를 보고하는데, 5절에서 다룬 논문 Fig. 4 해석 문제와 바로 이어진다.