Training Language Models to Self-Correct via Reinforcement Learning
자기수정 학습은 '1차에 최선, 2차는 복사'로 붕괴하므로, 1차를 base에 묶는 RL 초기화와 '틀림→맞음' 보너스로 그 지름길을 막는다.
Huang et al.의 "Large Language Models Cannot Self-Correct Reasoning Yet"을 읽은 뒤 자연스럽게 이어서 본 논문이다. 그 논문은 외부 피드백 없이 프롬프트만으로 자기 답을 고치게 하면 오히려 성능이 떨어진다고 보였다. 그렇다면 학습으로는 이 능력을 만들 수 있는지가 다음 질문이 된다. Google DeepMind의 SCoRe는 이 질문에 multi-turn RL로 답하려 한 논문이다. Aviral Kumar가 공저자로 참여한 같은 시기의 RISE(Recursive Introspection)와 문제 설정이 비슷하다.
- 저자: Aviral Kumar, Vincent Zhuang (공동 1저자) 외 총 18명, Google DeepMind
- 게재: ICLR 2025 (arXiv 2409.12917)
- 코드: 논문에 공개 언급이 없다. 실험 모델도 비공개 Gemini다.
0. 한 줄 요약
자기수정을 그냥 학습시키면 모델은 "1차에서 최선을 내고 2차는 그대로 둔다"는 지름길로 빠진다. 이 논문은 1차 응답을 base 모델 근처에 묶어 두는 RL 초기화와, 틀린 답을 맞게 고쳤을 때 큰 보너스를 주는 reward shaping으로 그 지름길이 손해가 되게 만든다.
1. 문제 정의
논문이 보여주는 출발점은 이렇다. base Gemini 1.5 Flash에게 MATH500을 풀게 한 뒤 "실수가 있을 수 있으니 고쳐서 다시 써라"라고 지시하면 정확도가 52.6%에서 41.4%로 떨어진다(Table 1). 1차에 맞았다가 2차에 틀린 문항이 15.8%이고, 틀렸다가 맞게 고친 문항은 4.6%뿐이다. 500문항으로 바꿔 보면 79개를 망가뜨리고 23개를 고친 셈이다.
저자들이 다루는 설정은 intrinsic self-correction이다. 2차 시도에서 모델이 받는 것은 문제, 자기 1차 답, 그리고 고정된 수정 지시문뿐이다. 지시문은 "There might be an error in the solution above because of lack of understanding of the question. Please correct the error, if any, and rewrite the solution."이고(App. C), 1차 답이 맞았는지는 알려주지 않는다. 정답과 비교하는 보상 함수는 학습할 때만 쓰고, 테스트할 때는 쓰지 않는다고 §3에서 분명히 밝힌다. 시도 횟수도 2턴으로 고정이라 모델이 언제 멈출지 정하지 않는다. self-correction 논문을 읽을 때는 모델이 밖에서 무엇을 받는지부터 확인해야 하는데, 이 논문은 이 부분이 깔끔하다.
평가 지표는 1차 정확도(Acc@t1), 2차 정확도(Acc@t2), 그 차이 Δ, 그리고 Δ를 둘로 나눈 Δi→c(틀림→맞음 비율)와 Δc→i(맞음→틀림 비율)다. 뒤에서 이 두 지표를 따로 보는 게 중요해진다.
저자들은 이 문제가 중요한 이유로 추론 시 계산을 쓰는 방식을 든다. 답을 여러 개 병렬로 뽑는 대신, 자기 답을 순차적으로 고치는 메타 전략을 모델이 학습할 수 있느냐는 것이다(§1).
2. 기존 방법들의 한계
논문이 다루는 기존 접근을 내 식으로 나누면 네 갈래다.
첫째는 프롬프팅이다. Self-Refine, RCI, Reflexion 같은 방법이 자기수정에 성공했다고 보고했지만, 저자들은 Huang et al.과 Kamoi et al.을 인용해 그 결과가 부풀려졌다고 본다. RCI와 Reflexion은 수정 과정에서 정답 정보를 쓰고, Self-Refine은 1차 프롬프트가 약해서 개선 폭이 커 보였다는 것이다. 저자들이 직접 돌린 Self-Refine도 MATH에서 Δ가 −1.0%였다(Table 2).
둘째는 수정 전용 모델을 따로 두거나 더 강한 교사 모델의 감독을 받는 방법이다(Welleck et al. 2023, GLoRE, RISE). 배포할 때 모델을 여러 개 돌려야 하거나 강한 교사에 의존한다는 게 저자들의 지적이다. 다만 이 부분은 논증과 인용뿐이다. Welleck et al.의 원래 방법과 직접 비교한 실험은 없고, 수정 모델을 따로 두지 않는 변형인 Pair-SFT만 실험에 들어간다.
셋째는 모델이 스스로 만든 데이터로 SFT하는 방법(STaR, Pair-SFT)이다. 논문에서 가장 공들인 부분이 이 실패를 진단한 §4다. 저자들은 실패 원인을 두 가지로 나눈다. 하나는 distribution shift다. 학습 데이터의 1차 오답은 base 모델이 낸 것이라 off-policy인데, 학습이 끝난 모델이 실제로 고쳐야 하는 건 자기 오답이다. 논문 Figure 5가 이걸 직접 보여준다. 같은 SFT 모델이 고정된 base 1차 응답은 학습이 진행될수록 잘 고치지만, 자기가 생성한 1차 응답에서는 수정 정확도가 오히려 떨어진다. 다른 하나는 behavior collapse다. Pair-SFT는 Δc→i를 15.8%에서 3.6%로 크게 줄였지만 Δi→c는 4.6%에서 5.4%로 거의 늘지 않았다(Table 1). 1차와 2차 응답 사이 편집 거리를 보면 SFT 모델들은 지나치게 보수적이 되어 아예 고치지 않는 경우가 많다(논문 Figure 4a).
넷째는 단순한 multi-turn RL이다. on-policy로 학습하니 distribution shift는 해결되지만 behavior collapse는 그대로 남는다.
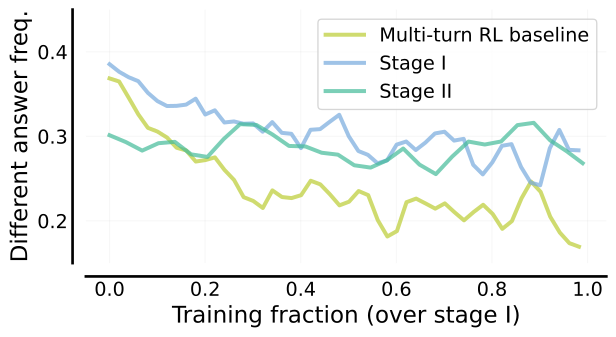
Fig. 1. 학습 중 2차 턴에서 1차와 다른 답을 내는 빈도. Stage I 없이 일반 multi-turn RL을 돌리면 이 빈도가 0.37 안팎에서 0.2 아래까지 떨어지고, SCoRe의 Stage I을 거친 Stage II는 0.3 안팎을 유지한다. (논문 Figure 6(b))출처: Kumar et al., arXiv 2024 (CC BY 4.0)
Fig. 1을 보면 일반 multi-turn RL은 학습할수록 2차에서 답을 거의 바꾸지 않는 쪽으로 간다. 저자들은 그 이유를 이렇게 설명한다(§5). 학습셋 위에서는 "1차에서 2차로 가며 고치기"와 "1차에 최선을 내고 2차는 그대로 두기"가 똑같이 최적이다. 이 둘 중 새 문제에 일반화되는 건 앞의 것뿐인데, 과매개변수화된 모델이 앞의 것을 반드시 배운다는 보장은 없다. 저자들은 이를 메타학습의 memorization 문제(Yin et al., 2019)에 비유한다. 결국 고치지 않는 전략이 학습셋에서 덜 매력적으로 보이게 만들어야 한다는 게 이 논문의 출발점이다.
3. 방법
핵심 아이디어는 하나로 정리된다. on-policy multi-turn RL에서 "복사하기"와 "고치기"가 똑같이 최적인 상황을 정규화로 깨서 복사하기를 손해로 만드는 것이다. Stage I과 reward shaping은 이 정규화를 구현하는 두 방법이고, on-policy REINFORCE(Ahmadian et al., 2024)는 distribution shift를 피하기 위한 전제 조건이다.
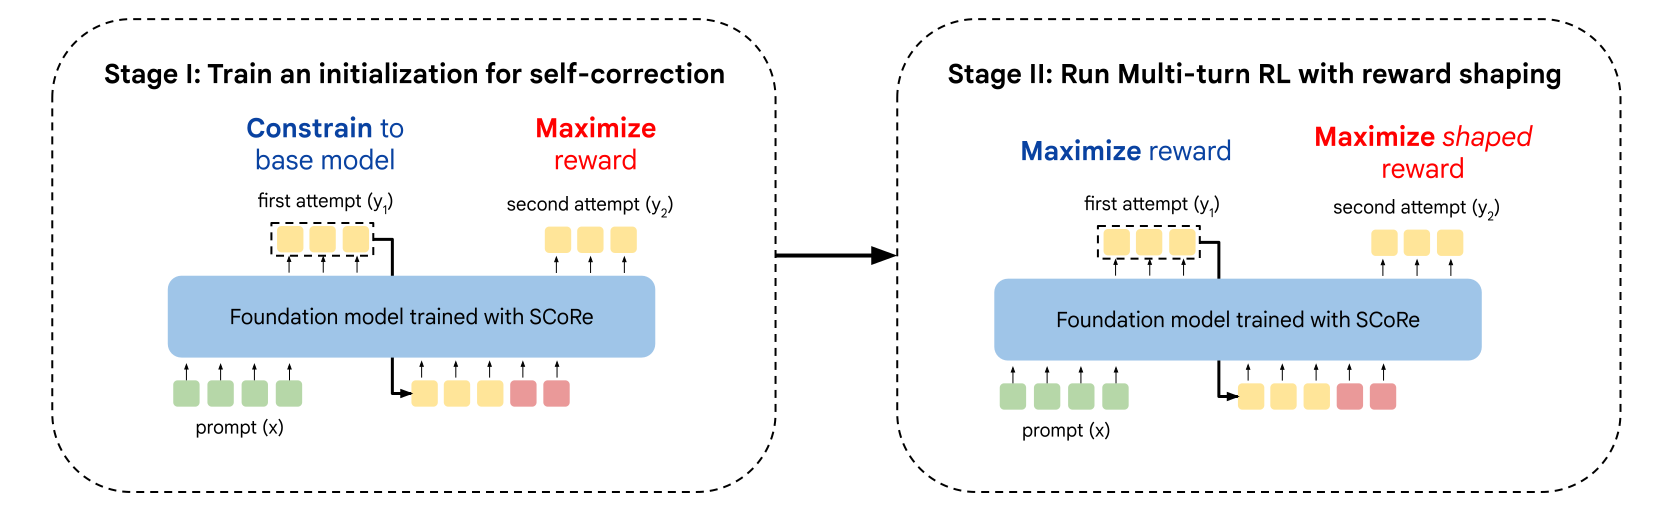
Fig. 2. SCoRe 개요. Stage I은 1차 응답을 base 모델 근처에 묶어 둔 채 2차 응답을 학습하고, Stage II는 두 턴을 함께 최적화하면서 2차 보상에 shaping 보너스를 더한다. (논문 Figure 7)출처: Kumar et al., arXiv 2024 (CC BY 4.0)
Stage I의 목적식은 Eq. 3이다.
2차 보상만 최대화하고, 1차 응답에는 강한 KL 페널티(MATH β2=0.1, MBPP β2=0.25)를 걸어 base 모델에서 멀어지지 못하게 한다. 기본 KL 페널티(β1=0.01)도 작게 함께 쓴다(Table 5). 처음 보면 이상하다. 1차를 잘해야 2차도 잘할 텐데 1차를 일부러 묶어 두기 때문이다. 하지만 KL 항이 없으면 2차를 잘하는 가장 쉬운 길이 1차를 잘하는 것이 되고, 두 턴이 같이 움직이면서 Fig. 1처럼 2차에서 답을 바꾸는 비율이 떨어진다. 1차를 base 모델의 오답 분포에 묶어 두면 모델은 다양한 실수를 고치는 연습을 할 수밖에 없다.
Stage II는 Stage I 모델에서 시작해 두 턴의 보상 합을 최대화한다(Eq. 4). 여기에 2차 보상에 다음 보너스를 더한다.
α=10이니 2차 보상은 틀림→맞음이면 11, 맞음→맞음이면 1, 틀림→틀림이면 0, 맞음→틀림이면 −10이 된다. 보너스가 없으면 맞음→맞음과 틀림→맞음이 2차에서 같은 보상을 받으니 복사 전략이 다시 똑같이 최적이 된다. 보너스는 정답 여부가 바뀌는 전이만 강조하고, 맞는 답을 틀리게 바꾸는 쪽에 큰 벌점을 준다.
개인적으로는 이 설계가 안전한 이유가 할인율 γ=0 때문이라고 생각한다(App. A.2). 1차 행동은 1차 보상만 받으니 "1차에서 일부러 틀리기"로 가는 기울기가 생기지 않는다. 그런데 γ>0이면 경로 전체로 볼 때 틀림→맞음(0+11)이 맞음→맞음(1+1)보다 커서, 1차를 일부러 틀리게 낼 유인이 생길 수 있다. App. A.2에는 Stage I 없이 일반 multi-turn RL에 γ=0.8과 reward shaping(α=1.0)을 함께 써도 고치지 않는 쪽으로 붕괴했다는 결과만 있고, 이런 유인에 대한 논의는 없다.
구현 쪽에서 하나 눈에 띈 건 §5.3의 내용이다. 일부 실험에서는 base 모델을 반복 샘플링해 얻은 1차 풀이를 RL 프롬프트에 오프라인으로 섞었다고 하는데, 특히 Stage II에서, 그리고 학습 데이터가 적을 때 도움이 될 수 있다고 한다. 어떤 실험에 이 데이터를 썼는지는 밝히지 않는다.
정리하면 이 방법이 성립하려면 학습할 때 정답을 자동으로 판정할 수 있어야 한다. MATH는 answer checker를, 코드는 모든 테스트 통과 여부를 binary 보상으로 쓴다. 그래서 정답을 자동으로 확인할 수 없는 태스크에는 바로 적용하기 어렵다. 에이전트나 RAG 같은 시스템도 아니다. 스캐폴딩은 고정 2턴과 고정 지시문뿐이고, 수정 능력은 전부 가중치 안에 있다. 체크포인트는 training reward가 가장 높은 것으로 골랐으니 테스트셋 정보가 새지도 않았다.
4. 실험 결과
MATH는 학습셋에 테스트셋 4,500문항을 더해 학습하고 나머지 MATH500으로 평가했다(Lightman et al. 분할). 모델은 Gemini 1.5 Flash다. 코드는 MBPP로 학습하고 HumanEval로 평가했으며, PaLM 2가 만든 오답 프로그램을 고치는 오프라인 수리 과제 MBPP-R도 함께 보고했다. 모델은 Gemini 1.0 Pro다. 평가는 greedy decoding이고, §6.2의 추론 계산 실험만 temperature 0.7이다. 베이스라인은 MATH에서 Self-Refine, STaR, Pair-SFT이고, HumanEval에서는 Self-Refine과 Pair-SFT다. 저자들은 모든 방법에서 샘플 수와 gradient update 예산을 고정하려 했다고 쓰지만, SCoRe의 학습 step과 batch 크기(Table 5) 말고 다른 방법들이 실제로 어떤 예산을 썼는지는 적혀 있지 않다. 계산 자원도 적혀 있지 않다.
MATH500 결과(Table 2)에서 SCoRe는 Acc@t1 60.0%, Acc@t2 64.4%, Δ +4.4%다. Δi→c는 5.8%, Δc→i는 1.4%다. 가장 강한 베이스라인인 Pair-SFT는 52.4%에서 54.2%로 Δ +1.8%였다. 문항 수로 바꾸면 SCoRe는 29문항을 고치고 7문항을 망쳐 순 +22문항이고, Pair-SFT는 27문항을 고치고 18문항을 망쳐 순 +9문항이다.
이걸 base 모델과 비교해 나눠 보면 흥미롭다. Δ가 −11.2%에서 +4.4%로 15.6%p 좋아졌는데, 그중 Δi→c 증가는 1.2%p(6문항)뿐이고 Δc→i 감소가 14.4%p(72문항)다. 내 계산으로는 MATH에서 자기수정이 좋아진 몫의 약 92%가 "덜 망가뜨린" 데서 나왔다. 1차 오답 중 몇 개를 고쳤는지로 보는 조건부 수정률을 표로 직접 계산하면 SCoRe 14.5%, Pair-SFT 11.3%, base 9.7%다(본문은 base를 9.5%로 적었다. 5장에서 다시 다룬다).
HumanEval(Table 3)은 그림이 다르다. base는 53.7%에서 56.7%로 Δ +3.0%, SCoRe는 52.4%에서 64.6%로 Δ +12.2%였고, SCoRe의 Δi→c는 15.2%, Δc→i는 3.0%다. 논문에는 적혀 있지 않지만 HumanEval은 164문항이고, 표의 HumanEval 수치는 대부분 이 수와 맞는다(52.4% = 86/164). SCoRe는 25문항을 고치고 5문항을 망쳐 순 +20문항이고, base는 13문항을 고치고 8문항을 망쳐 순 +5문항이다. 여기서는 Δi→c가 base의 약 두 배가 됐다. 틀린 답을 실제로 고치는 능력이 늘었다고 확인되는 곳은 MATH보다는 HumanEval이다. 다만 1차 정답률은 SCoRe가 base보다 1.3%p(2문항) 낮다. MBPP-R에서는 47.3%에서 60.6%로 올랐다.
HumanEval에 대해 한 가지 짚어 두고 싶은 게 있다. 숨겨진 테스트 케이스는 모델에게 보이지 않지만, App. E 예시처럼 문제 docstring 안에 입출력 예시가 들어 있다. 내 생각에는 모델이 이 예시를 머릿속으로 실행해 볼 수 있으니 MATH보다 스스로 검증하기 쉬운 환경이다.
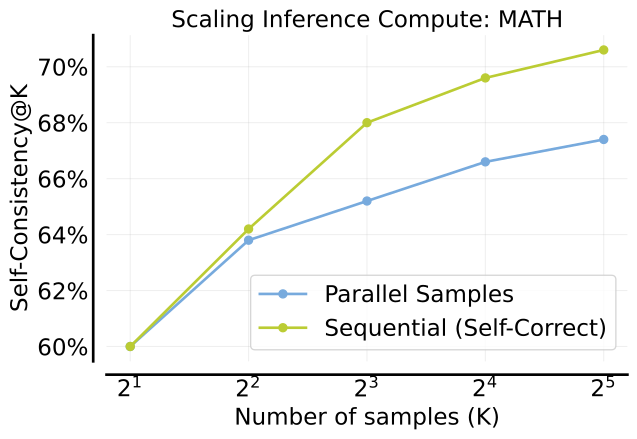
Fig. 3. MATH에서 문제당 샘플 예산을 늘릴 때 self-consistency 정확도. 모든 샘플을 병렬로 뽑는 경우와, 절반을 병렬로 뽑고 각각 한 번씩 자기수정하는 경우를 비교한다. (논문 Figure 1 오른쪽)출처: Kumar et al., arXiv 2024 (CC BY 4.0)
§6.2는 추론 계산 확장 실험이다. 2K개를 병렬로 뽑는 대신 K개를 뽑고 각각 한 번씩 수정한 다음 다수결을 하는 쪽이 더 효율적이라는 주장이다. 문제당 32개 예산에서 병렬 샘플링만 쓰면 +7.4%p, 순차 수정을 섞으면 +10.5%p였다. 그런데 병렬 샘플링 쪽 곡선이 어느 모델에서 뽑은 것인지가 본문에 분명하지 않다.
Ablation(Table 4, MATH)을 보면 각 장치의 몫이 드러난다. Stage I을 빼면 Δ가 2.2%로, reward shaping을 빼면 2.6%로 줄었다. 4.4%와 비교하면 각각 11문항, 9문항 차이다. Stage II를 STaR로 바꾸면 Acc@t1이 56.2%까지 내려간다. 개인적으로 가장 중요하다고 본 숫자는 다중 턴 학습 없이 단일 턴 RL로 학습한 모델의 Acc@t1 61.8%다. 2턴을 쓰는 SCoRe의 최종 64.4%와 비교하면 차이가 2.6%p(13문항)이고, 그 대가로 생성 비용은 두 배다. 실제로 두 번째 턴이 더해 주는 가치는 이 정도로 봐야 한다고 생각한다.
실패 사례도 몇 가지 있다. 10턴까지 반복해서 고치게 하면 SCoRe는 2턴 이후에도 조금 오르다가 곧 정체한다(App. A.1). Stage I 없이 일반 multi-turn RL에 γ=0.8과 reward shaping(α=1.0, 본 실험의 α=10보다 작다)을 함께 써도 고치지 않는 쪽으로 붕괴했다(App. A.2). App. E의 MATH Example 5는 2차 답(1/3)이 정답이긴 한데, C와 D의 위치를 정하기도 전에 "A와 C 사이의 호"를 언급하는 식이라 경우를 나눈 논리가 성립하지 않는다. 개인적으로는, 결과 보상만 쓰기 때문에 이렇게 추론은 틀리고 답만 맞은 수정도 보상을 받는다고 본다.
5. 읽으면서 든 의문
첫 번째는 헤드라인 지표인 Δ가 실제로 무엇을 재는가다. §4는 Pair-SFT가 Δc→i만 줄이고 Δi→c는 못 늘린다고 비판한다. 그런데 MATH에서는 SCoRe도 같은 패턴이다. base 대비 개선 15.6%p 중 14.4%p가 Δc→i 감소에서 나왔고, Pair-SFT와 비교한 Δi→c 차이는 0.4%p, 즉 2문항이다. 그래서 적어도 MATH에서는 "자기수정을 학습했다"보다 "맞았을 때 바꾸지 않는 법을 학습했다"에 더 가깝다고 본다. 이 논문에서 가장 아쉬운 부분이었다.
두 번째는 모든 결과가 단일 실행으로 보인다는 점이다. 반복 실행, 분산, 신뢰구간, 학습 seed 수가 어디에도 없다. RL 학습은 seed에 따라 결과가 꽤 흔들리는데, ablation의 핵심 차이는 911문항(1.82.2%p)이다. 내가 계산해 보니 시험 문항 표본 오차만 따져도 정확도 64%, N=500이면 95% 신뢰구간이 대략 ±4.2%p이고, HumanEval(N=164)은 ±7.3%p쯤 된다. seed 수를 밝히지 않았으니, "Stage I이 꼭 필요하다"는 결론이 seed 간 편차를 넘는 차이인지 판단할 수 없다.
세 번째는 같은 예산을 쓰는 대조군이 빠졌다는 점이다. SCoRe는 2턴이니 생성을 두 번 한다. Table 4에 단일 턴 RL 모델을 2턴으로 평가한 결과(Acc@t2 59.4%)가 있지만, 이 모델은 두 번째 턴을 학습하지 않았고 2차에서 오히려 성능이 떨어진다(Δ −2.4%). Table 4에는 두 번째 생성을 자기수정이 아닌 방식으로 쓰는 단일 턴 RL 대조군이 없다. Fig. 3도 병렬 샘플링 곡선이 어느 모델에서 나왔는지 분명하지 않아, 단일 턴 RL 모델의 self-consistency와 비교한 것인지 알 수 없다. 그래서 단일 턴 RL 모델의 1차 정확도 61.8%와 SCoRe의 2차 정확도 64.4% 사이의 2.6%p가 순차 수정 덕분인지, 그냥 계산을 더 써서인지 가릴 수 없다. 두 모델은 학습 방식도 다르다.
네 번째는 본문과 표의 수치가 맞지 않는 곳이 있다는 점이다. §6.1은 수정률이 "14.5% vs 9.5%"라고 하는데, 이건 1차 오답 대비 조건부 비율이고 base를 표로 계산하면 4.6/47.4 = 9.7%다. 같은 문장의 "15.8% → 1.4%"는 조건부가 아닌 비율이라 두 종류가 섞여 있다. Pair-SFT보다 "Δ는 10.2%, Acc@t2는 2.6%" 높다는 문장도 순서가 바뀌었다. 표로 계산하면 Δ 차이가 2.6%p, Acc@t2 차이가 10.2%p다. HumanEval 개선 폭도 초록은 9.1%, 표로 계산하면 9.2%p, 본문은 "9%"다. 하나하나는 사소하지만, 독자가 헤드라인 숫자를 직접 확인하기 어렵게 만든다.
다섯 번째는 태스크와 모델의 짝이 고정되어 있다는 점이다. MATH는 Gemini 1.5 Flash로만, 코드는 Gemini 1.0 Pro로만 실험했고 서로 바꿔 본 실험이 없다. 왜 이렇게 나눴는지 설명도 없다. 체리 피킹이라고 단정할 수는 없지만 약간 의심이 간다.
여섯 번째는 벤치마크 오염 가능성이다. MATH와 HumanEval은 공개 벤치마크이고 Gemini는 웹 규모 데이터로 학습했다. 모든 방법에 똑같이 작용하니 순위가 크게 바뀌지는 않을 것이다. 다만 §1의 "모델이 지식은 갖고 있는데 꺼내지 못한다"는 전제를 실제보다 크게 보이게 만들 수 있다고 생각한다.
마지막으로 재현성이다. 모델이 비공개 Gemini이고 코드도 없어서 외부에서는 결과를 재현할 방법이 없다.
그래도 좋았던 점이 분명하다. 테스트 때 정답 정보를 쓰지 않는다는 점은 고정 지시문과 고정 2턴 설정으로 확실히 지켰다. 프롬프팅 기반 연구들이 정답 정보를 쓰거나 약한 1차 프롬프트 때문에 개선 폭이 부풀려졌다는 비판을 정확히 피한 설계다. 고정된 base 1차 응답과 자기 생성 1차 응답을 나란히 놓고 비교한 논문 Figure 5도 distribution shift를 깔끔하게 보여준다.
6. 정리
이 논문에서 가장 설득력 있었던 건 방법보다 §4의 진단이다. SFT가 자기수정을 못 배우는 이유를 distribution shift와 behavior collapse로 나누고, 각각을 논문 Figure 5와 편집 거리 분포(논문 Figure 4a)로 따로 보였다. 이어서 일반 multi-turn RL도 같은 붕괴를 겪는다는 것을 Fig. 1(논문 Figure 6(b))로 보였다. Stage I과 reward shaping은 이 진단에서 바로 나온 처방이라 왜 그런 장치가 필요한지 납득이 된다. 테스트 때 정답 정보 없이 양의 Δ를 냈다는 점도 Huang et al.의 비관적 결론이 프롬프팅에 한정된 이야기일 수 있다는 근거가 된다.
반면 "자기수정을 학습했다"는 헤드라인이 틀림→맞음 비율의 큰 증가로 확인되는 곳은 HumanEval이다. PaLM 2의 오답을 고치는 오프라인 수리 과제 MBPP-R에서도 점수가 크게 올랐지만, 이 과제는 자기 답을 고치는 설정은 아니다. MATH에서는 1차 오답 대비 수정률이 오르긴 했지만, Δ 개선의 대부분은 맞음→틀림 감소에서 나왔다. 저자들이 §4에서 Pair-SFT를 비판한 것과 같은 패턴이다. 반복 실행 여부와 seed 수는 논문에 적혀 있지 않다. Table 4에 두 번째 생성을 자기수정이 아닌 방식으로 쓰는 단일 턴 RL 대조군도 없고, 조건부 비율은 일부만, 그것도 비조건부 비율과 섞여서 보고되어 있다. 그래서 내가 보기에 이 논문의 결과로 말할 수 있는 건 생각보다 적다.
이 논문에서 하나 가져간다면, 학습셋 위에서 똑같이 최적인 해가 여럿 있으면 모델이 원하는 해 대신 더 쉬운 해로 갈 수 있다는 점이다. 원하는 행동을 학습시키려면 보상을 높이는 것만으로는 부족하고, 쉬운 지름길이 손해가 되도록 문제를 바꿔야 한다.
7. 같이 읽어볼 논문
- Huang et al. (ICLR 2024), Large Language Models Cannot Self-Correct Reasoning Yet. 이 논문이 넘어서려는 출발점이다. 프롬프팅만으로는 intrinsic self-correction이 안 된다는 결과를 다시 보면 SCoRe의 설정이 왜 그렇게 짜였는지 보인다.
- Zelikman et al. (NeurIPS 2022), STaR: Bootstrapping Reasoning with Reasoning. §4에서 실패 사례로 분석한 SFT 베이스라인의 원형이다.
- Yin et al. (2019), Meta-Learning without Memorization. behavior collapse를 설명할 때 빌려 온 비유의 출처다.
- Qu et al. (2024), Recursive Introspection: Teaching Language Model Agents How to Self-Improve. Aviral Kumar가 공저자로 참여한 같은 시기의 다중 턴 자기개선 연구로, 주로 더 강한 모델의 감독을 받아 학습한다는 점이 SCoRe와 다르다.
- Xiong et al. (2025), Self-rewarding correction for mathematical reasoning. 오류 탐지와 수정, 멈출 시점 판단까지 학습시키고 Llama-3, Qwen-2.5로 실험했다. 코드와 데이터가 공개되어 있어 직접 재현해 보기 좋다.
- DeepSeek-AI (2025), DeepSeek-R1. SFT 없이 규칙 기반 보상(정답·형식)으로 대규모 RL을 돌린 R1-Zero에서 긴 CoT 안에 스스로 점검하는 행동이 나타났다는 논문이다. 개인적으로는 자기수정을 턴 사이에서 응답 안으로 옮겨 온 흐름으로 읽었다.