Self-Consistency Improves Chain of Thought Reasoning in Language Models
CoT의 greedy decoding을 다중 샘플링과 다수결로 바꾸는 디코딩 전략만으로 학습·검증기 없이 추론 성능을 크게 끌어올림
Google Research Brain Team이 ICLR 2023에 낸 self-consistency 논문을 읽고 정리했다. 요즘 LLM 추론 논문에서 여러 번 샘플링해 다수결하는 방식은 거의 기본 베이스라인처럼 들어가 있다. self-correction 논문을 읽을 때도 비교 대상으로 자주 나와서, 출처인 이 논문을 한 번 제대로 보고 싶었다. 전신은 같은 그룹의 Chain-of-Thought prompting 논문(Wei et al., NeurIPS 2022)이다. 이 논문은 CoT 프롬프트는 그대로 두고 디코딩 방식만 바꾼다.
- 저자: Xuezhi Wang, Jason Wei, Dale Schuurmans, Quoc Le, Ed H. Chi, Sharan Narang, Aakanksha Chowdhery, Denny Zhou
- 게재: ICLR 2023 (arXiv 2203.11171)
- 코드: 논문에 공식 저장소 링크는 없다. 대신 Appendix A.3에 프롬프트를 실었다(CommonsenseQA와 StrategyQA는 Wei et al.과 같다고만 적었다).
0. 한 줄 요약
CoT 프롬프트로 추론 경로를 여러 개 샘플링하고 최종 답끼리 다수결만 해도, 추가 학습이나 검증기 없이 산술·상식 추론 성능이 크게 오른다는 논문이다.
1. 문제 정의
CoT prompting은 모델이 풀이 과정을 문장으로 쓴 다음 답을 내게 한다. 그런데 Wei et al.(2022)은 이 풀이를 greedy decoding으로 딱 하나만 만든다. 저자들은 여기서 출발한다. 복잡한 추론 문제는 보통 정답에 이르는 풀이가 여러 가지 있는데, 풀이를 하나만 뽑으면 그중 한 갈래에 모든 걸 거는 셈이다. 논문은 greedy decoding이 반복적인 출력과 local optimum에 빠지기 쉽다고 지적한다. 내 식으로 풀면, 앞부분에서 한 번 계산을 틀리면 그 풀이는 끝까지 틀린 채로 가기 쉽다는 뜻이다.
저자들의 가설은 간단하다. 맞는 풀이들은 과정이 서로 달라도 최종 답이 같아지기 쉽고, 틀린 풀이들은 각자 다른 오답으로 흩어진다는 것이다. 사람도 여러 방법으로 풀어서 같은 답이 나오면 그 답을 더 믿게 되는데, 그 직관을 그대로 디코딩에 옮긴 셈이다.
2. 기존 방법들의 한계
논문이 대조하는 기존 접근은 크게 세 갈래다.
첫째는 생성 결과를 다시 채점하는 모델을 따로 학습하는 방식이다. Cobbe et al.(2021)은 GSM8K에서 verifier를 학습해 풀이를 재순위화했고, Thoppilan et al.(2022)은 사람 주석을 추가로 모아 re-ranker를 학습했다. 성능은 좋아지지만 학습 데이터와 별도 모델이 더 필요하다.
둘째는 특정 과제에 맞춘 추론 기법들이다(Andor et al. 2019, Ran et al. 2019, Geva et al. 2020 등). 논문은 이들을 특정 과제에 맞춘 접근이라고만 묶는다. 인용된 논문들을 보면 계산기를 붙이거나 수치 추론 능력을 주입하는 식이라, 다른 추론 과제로 옮기기는 어려워 보인다.
셋째는 추론 경로를 뽑아내는 데 특화된 방법들이다. semantic graph를 만들거나, Wikipedia 그래프 위에서 경로를 찾는 RNN을 학습하거나, 사람이 단 풀이로 파인튜닝하는 식인데, 모두 과제별 학습이 필요하다.
다만 이 세 갈래와의 대조는 서론과 Related Work에서 인용으로 정리한 것이다. verifier는 Table 2에 이전 SoTA 수치로만 나온다. 직접 돌려 비교한 대상은 §3.4와 Appendix의 sample-and-rank, beam search, 앙상블 방식이다.
3. 방법
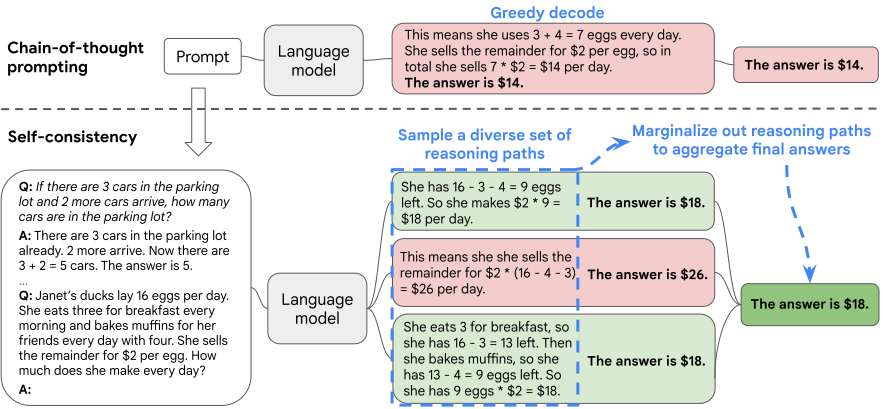
Fig. 1. self-consistency의 세 단계. CoT 프롬프트를 넣고, greedy decoding 대신 디코더에서 풀이를 여러 개 샘플링한 뒤, 최종 답을 다수결로 모은다. 예시에서 Output 1과 3은 서로 다른 풀이로 26으로 빠진다. (논문 Figure 1)출처: Wang et al., arXiv 2203.11171 (CC BY 4.0)
새로 들어간 요소는 디코딩 방식 하나뿐이다. 학습도, 검증기도, 사람 라벨도 쓰지 않는다. 절차는 세 단계다.
먼저 사람이 손으로 쓴 CoT 예시로 few-shot 프롬프트를 만든다. 다음으로 greedy decoding 대신 temperature, top-k, nucleus 같은 방식으로 샘플링해서 풀이와 답의 쌍 를 m개(주 실험에서는 40개) 독립적으로 만든다. 마지막으로 풀이 를 잠재변수로 보고 marginalize한다. 실제로 하는 일은 최종 답에 대한 다수결이다.
답은 출력에서 "The answer is " 뒤를 잘라서 얻는다. 산술 과제는 그 뒤의 첫 숫자를, 상식 과제는 그 뒤 문자열 전체를 답으로 본다(각주 1).
다수결 말고 각 경로의 확률로 가중치를 줄 수도 있다. 이때 확률을 그대로 쓸 수도 있고, 출력 길이로 정규화할 수도 있다(Eq. 1). 긴 풀이일수록 토큰 확률이 많이 곱해져 불리해지는 걸 막으려는 정규화로 보인다.
Table 1(PaLM-540B)이 집계 방식 다섯 가지를 비교한다. GSM8K에서 정규화하지 않은 가중합은 59.9%지만 정규화하면 74.1%로 오른다. 그런데 그냥 다수결을 하면 74.4%로 정규화 가중합과 거의 같다. 저자들이 출력 확률을 들여다보니 경로별 정규화 확률이 서로 아주 비슷했다고 한다. 모델이 맞는 풀이와 틀린 풀이를 비슷하게 그럴듯하다고 본다는 뜻이고, 각주 2에서는 이걸 모델의 calibration이 좋지 않다는 증거로 해석한다. 이전 연구들이 re-ranker를 따로 학습한 이유도 여기서 설명된다. 개인적으로는 이 각주가 논문에서 꽤 중요한 대목이라고 생각한다. 확률로 가중해도 이득이 없으니 다수결만으로 충분하다는 결론이 여기서 나온다.
이 방법이 성립하려면 전제가 하나 필요하다. 최종 답이 미리 정해진 답 집합 안에 있어야 한다. 같은 답인지 셀 수 있어야 다수결이 되기 때문이다. 저자들도 §2 끝에서 self-consistency는 답이 고정 집합에서 나오는 문제에만 바로 쓸 수 있고, 열린 텍스트 생성으로 넓히려면 두 생성물이 서로 일치하는지 모순되는지 판단하는 일관성 지표를 따로 정의해야 한다고 적었다. 정답 여부를 알려주는 oracle이나 학습된 검증기는 필요 없지만, 답을 셀 수 있어야 한다는 구조적인 조건은 있는 셈이다.
4. 실험 결과
과제는 세 종류다. 산술 추론은 AddSub, MultiArith, ASDiv, AQuA, GSM8K, SVAMP, 상식 추론은 CommonsenseQA, StrategyQA, ARC(easy/challenge), 기호 추론은 last letter concatenation과 Coinflip이다. 기호 추론은 프롬프트에 2글자·2번 뒤집기 예시를 넣고 4글자·4번 뒤집기로 테스트해서 길이가 프롬프트 예시보다 긴 조건을 본다. CommonsenseQA는 dev split, StrategyQA는 BIG-bench의 question-only 셋을 썼다. 모델은 UL2-20B(공개 체크포인트), GPT-3 175B(code-davinci-001/002 공개 API), LaMDA-137B, PaLM-540B 네 개다. 주 실험은 few-shot 프롬프팅만 쓰고 파인튜닝은 하지 않았다(추가 실험으로 zero-shot CoT도 있다). 프롬프트는 대부분 Wei et al.(2022)과 같고, AQuA와 ARC 프롬프트는 저자들이 새로 작성했다. 샘플링은 UL2와 LaMDA가 T=0.5·top-k 40, PaLM이 T=0.7·top-k 40, GPT-3는 T=0.7에 top-k 없이 했다. 결과는 매번 40개를 새로 샘플링한 10회 실행의 평균이고, 표준편차는 모든 과제에서 0.5 이하라서 표에서는 생략했다고 한다(각주 7). 비교 기준은 greedy decoding을 쓰는 CoT prompting이고, 채점은 데이터셋 정답과의 자동 비교다.
산술 추론 결과(Table 2)를 보면 네 모델 모두에서 성능이 올랐다. PaLM-540B 기준으로 GSM8K가 56.5에서 74.4(+17.9), AQuA가 35.8에서 48.3(+12.5), SVAMP가 79.0에서 86.6(+7.6)이다. code-davinci-002도 GSM8K에서 60.1에서 78.0으로 똑같이 +17.9가 올랐고, SVAMP는 +11.0, AQuA는 +12.2다. 초록에 나오는 숫자(GSM8K +17.9, SVAMP +11.0, AQuA +12.2, StrategyQA +6.4, ARC-challenge +3.9)는 모두 code-davinci-002 결과이고, GSM8K +17.9만 PaLM-540B와 값이 같다. 그래서 PaLM 숫자와는 조금씩 다르다. 저자들이 짚는 점은 모델이 클수록 이득이 커진다는 것이다. 저자들은 UL2-20B에서 +36%p, LaMDA-137B와 GPT-3에서 +923%p라고 요약한다. 표와 대조하면 GPT-3 쪽은 code-davinci-001에 가까운 범위이고(일부 과제는 +6.7, +8.8), code-davinci-002의 이득은 +2.2~+17.9로 더 작다. 산술 과제 대부분에서 새 SoTA를 냈는데, 이전 SoTA 중에는 GSM8K에서 파인튜닝한 GPT-3 175B에 175B verifier를 붙인 모델(55%)도 있었다.
상식·기호 추론(Table 3)도 비슷하다. PaLM-540B에서 StrategyQA가 75.3에서 81.6(+6.3), ARC-challenge가 85.2에서 88.7(+3.5)이 됐다. CommonsenseQA는 +1.7로 상대적으로 작다. 저자들은 6개 과제 중 5개에서 SoTA를 냈다고 쓰는데, 기호 추론 두 과제는 이전 SoTA 칸이 N/A라서 이 숫자는 조금 걸러서 읽는 게 맞다고 본다. UL2-20B의 last letter 과제는 CoT도 self-consistency도 0.0으로, 모델이 아예 못 푸는 과제에서는 샘플을 늘려도 소용이 없다.
샘플 수를 1, 5, 10, 20, 40으로 바꿔 본 Figure 2(LaMDA-137B)에서는 샘플이 많을수록 정확도가 꾸준히 오른다. 다만 §5에서 저자들도 말하듯 대부분 과제에서 성능이 빨리 포화돼서, 실제로는 5개나 10개 정도로 시작해도 이득의 상당 부분을 얻을 수 있다고 한다.
내가 가장 설득력 있다고 본 건 §3.4의 비교 실험이다. 같은 샘플 수(또는 같은 호출 수)를 쓰는 sample-and-rank, beam search, 프롬프트 순서를 40번 바꾼 앙상블과 붙여서, 성능이 단순히 호출을 많이 해서 오른 것만은 아니라는 걸 보여준다. 프롬프트 세트 3개로 만든 앙상블은 호출이 3번이라 같은 예산 비교는 아니다.
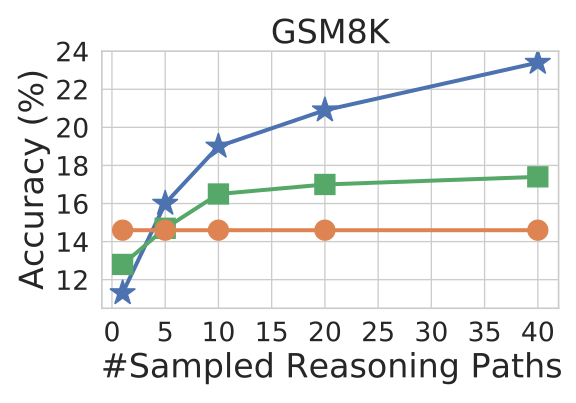
Fig. 2. GSM8K에서 샘플 수에 따른 정확도(code-davinci-001). 파란 별이 self-consistency, 초록 사각형이 sample-and-rank, 주황 원이 greedy decoding이다. (논문 Figure 3 왼쪽 패널)출처: Wang et al., arXiv 2203.11171 (CC BY 4.0)
sample-and-rank는 같은 수만큼 샘플을 뽑은 다음 로그확률이 가장 높은 하나를 고르는 방법이다. 샘플이 40개일 때 self-consistency는 23.4%까지 오르고(Table 2), greedy는 14.6에 그대로 있다. sample-and-rank는 그림으로 읽으면 17% 근처에서 멈춘다. 개인적으로는 앞에서 본 calibration 문제와 이어진다고 본다. 경로별 확률이 거의 비슷하면 확률로 하나를 고르는 건 별 도움이 안 되고, 답이 몇 번 나왔는지 세는 쪽이 낫다. 다만 Table 1은 PaLM-540B, 이 실험은 code-davinci-001 결과라 모델은 다르다.
beam search와 비교한 Table 6(UL2-20B)은 더 극적이다. AQuA에서 beam search의 top beam은 beam 크기를 1에서 40으로 늘리자 오히려 23.6에서 10.2로 떨어졌다. 반면 샘플링을 쓰는 self-consistency는 19.7에서 26.9로 올랐다. beam search로 경로를 뽑아 다수결하는 변형도 AQuA에서는 경로 5개부터, MultiArith에서는 10개부터 샘플링보다 낮았는데, 저자들은 beam search가 만드는 출력의 다양성이 낮아서라고 설명한다. 핵심은 투표 자체보다 풀이가 서로 다르게 나오는 데 있다는 뜻이다.
앙상블 비교(Table 7, LaMDA-137B)에서는 프롬프트 예시 순서를 40번 섞거나 프롬프트 세트를 3개 써서 greedy 결과를 다수결해도 GSM8K에서 +2.1%p, +1.5%p 오르는 데 그쳤다. self-consistency는 +10.6%p다. Appendix의 Table 11(PaLM-540B, GSM8K)에서도 프롬프트 세트 40개나 순열 40개로 맞춘 앙상블은 58.9, 59.6이었고 self-consistency는 74.4였다.
그 밖의 추가 실험도 몇 개 있다. 예시 풀이 속 숫자를 일부러 틀리게 바꾼 프롬프트에서 LaMDA-137B의 greedy 정확도는 17.1에서 14.9로 떨어지지만, 여기에 self-consistency를 적용하면 23.4로 원래 프롬프트의 greedy보다도 높아진다(Table 8). zero-shot CoT에 적용해도 PaLM-540B GSM8K에서 43.0이 69.2가 된다. CoT를 넣으면 오히려 standard prompting보다 떨어지는 ANLI R1, e-SNLI, RTE에서도 self-consistency를 쓰면 standard prompting을 넘는다(Table 5). 풀이를 자연어 대신 수식으로만 쓰게 하면 이득이 작아지는데, 저자들은 수식이 짧아서 다양성이 생길 여지가 적기 때문이라고 본다. 앞의 beam search 결과와 같은 맥락이다.
실패 사례도 하나 본문에서 직접 짚는다. Table 4의 StrategyQA 예시("Albany, Georgia가 미국에서 인구가 가장 많은 Albany인가?")에서 self-consistency는 정답 no에 도달한다. 그런데 샘플링된 풀이가 인용한 인구수(약 88,000, 약 95,000)는 정확하지 않다고 저자들이 §5에서 직접 적었다. 답이 맞아도 풀이 내용이 사실이라는 보장은 없다.
5. 읽으면서 든 의문
첫 번째는 대표 수치가 무엇과 무엇을 비교한 결과인지다. Table 2·3의 +17.9%p 같은 숫자는 greedy 호출 1번과 샘플링 40번을 비교한 결과다. 같은 샘플 수로 맞춘 비교는 §3.4와 Appendix에 따로 있는데, 이 비교들은 실험마다 모델이 다르다. sample-and-rank는 code-davinci-001, beam search는 UL2-20B, 앙상블은 LaMDA-137B와 PaLM-540B에서만 했다. 그래서 주 결과표의 모델·과제 조합 대부분에서는 같은 예산으로 맞췄을 때 차이가 얼마나 남는지 알 수 없다. 앞의 결과를 보면 결론이 뒤집힐 것 같지는 않지만, 주 결과표에 비용 축이 아예 없다는 건 아쉬웠다. 계산 비용이 더 든다는 점은 저자들도 §5에서 한계로 인정한다.
두 번째는 불확실성 추정에 관한 주장이다.
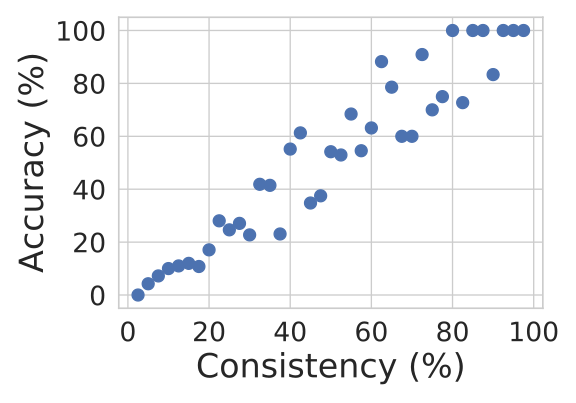
Fig. 3. GSM8K에서 consistency(최종 답에 동의한 샘플 비율)와 정확도의 관계. (논문 Figure 5)출처: Wang et al., arXiv 2203.11171 (CC BY 4.0)
그림을 보면 consistency가 20% 아래인 점들은 정확도도 20% 아래이고, 80% 이상 구간의 점들은 대부분 정확도가 100%다(70%대와 80%대인 점도 하나씩 있다). 중간 구간에서는 점들이 꽤 넓게 퍼져 있다. 저자들은 이 상관관계를 근거로 self-consistency가 모델에게 "자기가 모른다는 걸 아는" 능력을 어느 정도 준다고 쓴다(§3.5). 그런데 근거는 이 산점도 하나다. consistency가 높은데 틀린 경우가 얼마나 되는지나 calibration 곡선은 따로 보여주지 않고, 본문에서는 점 하나가 무엇을 묶은 값인지도 설명하지 않는다. 내 해석으로는 이 부분이 나중의 semantic entropy 연구와 바로 이어진다. 다수결로 고른 답의 비율이 곧 discrete semantic entropy와 같은 종류의 신호다. 그리고 Farquhar et al.(Nature 2024)이 밝힌 것처럼 이런 신호는 모델이 같은 오답을 일관되게 내는 경우를 잡지 못한다. 이 논문의 다수결도 마찬가지일 것이다.
세 번째는 답 파싱이다. "The answer is " 뒤를 잘라 쓰는 휴리스틱은 과제마다 다르다. 저자들은 대부분의 출력이 이 형식을 따른다고만 쓰고, 파싱에 실패하거나 잘못 파싱된 비율은 보고하지 않는다. 상식 과제는 문자열 전체를 답으로 보는데, HotpotQA처럼 짧은 서술형 답이 나오는 과제(Table 5)에서 표현만 다른 같은 답을 어떻게 셌는지도 설명이 없다. 다수결은 답을 정확히 세는 것에 전부 기대는 방법이라 이 부분이 조금 더 투명했으면 좋았겠다.
네 번째는 풀이의 사실성이다. 다수결은 최종 답만 보고 풀이는 전혀 보지 않는다. 그래서 Table 4의 인구수 예시처럼 틀린 근거로 맞는 답에 도달한 풀이도 한 표로 똑같이 센다. 저자들도 이를 한계로 적었다. 다만 §5에서 self-consistency가 풀이를 모으는 데도 쓸모 있다고 말하는데, 근거의 정확성을 확인하는 장치가 없으니 이 주장은 조심해서 받아들여야 한다고 생각한다.
그래도 실험 설계는 꼼꼼하다. 10회 실행 평균을 내고 표준편차가 0.5 이하라고 밝혔다. 내가 읽은 self-correction 논문 중에는 한 번만 돌린 결과를 보고한 경우가 많았는데, 그와 비교하면 눈에 띈다. 공개 모델(UL2)과 공개 API(code-davinci)를 포함해 재현 가능성도 챙겼고, Appendix A.1.2에서는 프롬프트 세트를 바꿔도 이득이 유지되는 걸 보였다(GSM8K에서 +16.4~+17.9).
6. 정리
4개 모델과 10개가 넘는 과제 대부분에서 성능이 올랐고(기호 추론 일부는 작은 모델에서 변화가 없었다), 10회 실행으로 결과가 안정적이라는 것도 보였다. Table 1, Table 6, Table 7과 Appendix Table 11의 결과는 왜 작동하는지까지 설명한다. 확률 가중은 calibration이 나빠서 도움이 안 되고, 다양성이 낮은 beam search는 UL2-20B의 AQuA에서 beam을 키울수록 오히려 성능이 떨어지고, 프롬프트 순서를 40번 바꾸거나 프롬프트 세트 40개로 횟수를 맞춘 앙상블도 이득이 훨씬 작다. 그래서 효과의 원천이 샘플링으로 만든 다양한 풀이라는 결론까지 꽤 깔끔하게 이어진다. 같은 예산 비교가 일부 모델에서만 이뤄졌고, 불확실성 추정에 관한 주장이 상관관계 그림 하나에 기대는 건 약점이다. 다만 이건 부가적인 주장의 근거가 얇은 정도이고, 핵심 주장은 충분히 받쳐진다고 본다.
이 논문에서 하나 가져간다면, 정답이 하나로 정해진 문제라도 디코딩 단계에서 다양성을 일부러 만드는 게 도움이 된다는 점이다. 개인적으로는 이 논문이 여러 응답을 쓰는 이후 방법들, 특히 self-correction이나 multi-agent debate가 넘어야 할 기준선 역할을 한다고 생각한다. 같은 호출 수를 쓰면서 다수결보다 나은지를 보여주지 못하면 그 방법만의 이득이라고 말하기 어렵다.
7. 같이 읽어볼 논문
- Wei et al. (NeurIPS 2022), Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. 이 논문이 바꾸는 greedy decoding과 프롬프트의 출처라 먼저 읽어두면 좋다.
- Cobbe et al. (2021), Training Verifiers to Solve Math Word Problems. GSM8K를 만든 논문이고, Table 2에 나오는 파인튜닝과 verifier 조합의 이전 SoTA다.
- Kojima et al. (NeurIPS 2022), Large Language Models are Zero-Shot Reasoners. Table 8에서 self-consistency를 얹은 zero-shot CoT의 출처다.
- Kuhn, Gal, Farquhar (ICLR 2023), Semantic Uncertainty. 답이 일치하는지를 문자열 대신 의미 함의로 판단해, 다수결을 열린 생성으로 넓힌 연구로 읽을 수 있다. 후속 논문인 Farquhar et al.(Nature 2024), Detecting Hallucinations in Large Language Models Using Semantic Entropy도 같이 보면 좋다.
- Huang et al. (ICLR 2024), Large Language Models Cannot Self-Correct Reasoning Yet. multi-agent debate를 같은 응답 수의 self-consistency와 비교하면서 이 논문의 다수결을 기준선으로 다시 쓴다.