LLM은 스스로 답을 고칠 수 있을까? Self-Correction 연구 흐름 정리
LLM은 스스로 답을 고칠 수 있을까. Saunders(2022)에서 시작해 2023년 낙관기, Huang의 반박, Tyen의 탐지 병목 진단, 이후 학습과 측정 두 갈래까지 흐름을 정리했다.
요즘 가장 많이 붙잡고 있는 주제는 LLM의 self-correction이다. 모델에게 "다시 한번 확인해 봐"라고 하면 정말 답이 좋아지는지, 좋아진다면 왜 그런지에 대한 질문이다. 관련 논문을 하나씩 읽다 보니 이 주제는 개별 논문보다 논문들 사이의 흐름을 알아야 이해가 된다는 걸 느꼈다. 어떤 가정이 나왔고, 그 가정 위에 어떤 방법들이 쌓였고, 그게 어떻게 반박됐는지를 알고 나서야 각 논문이 왜 그런 실험을 했는지가 보였다.
그래서 앞으로 올릴 논문 리뷰들의 지도 삼아, 지금까지 읽은 흐름을 먼저 한 번 정리해 두려고 한다. 각 논문의 자세한 내용은 개별 리뷰에서 다루고, 여기서는 논문들이 서로 어떻게 이어지는지에만 집중했다.
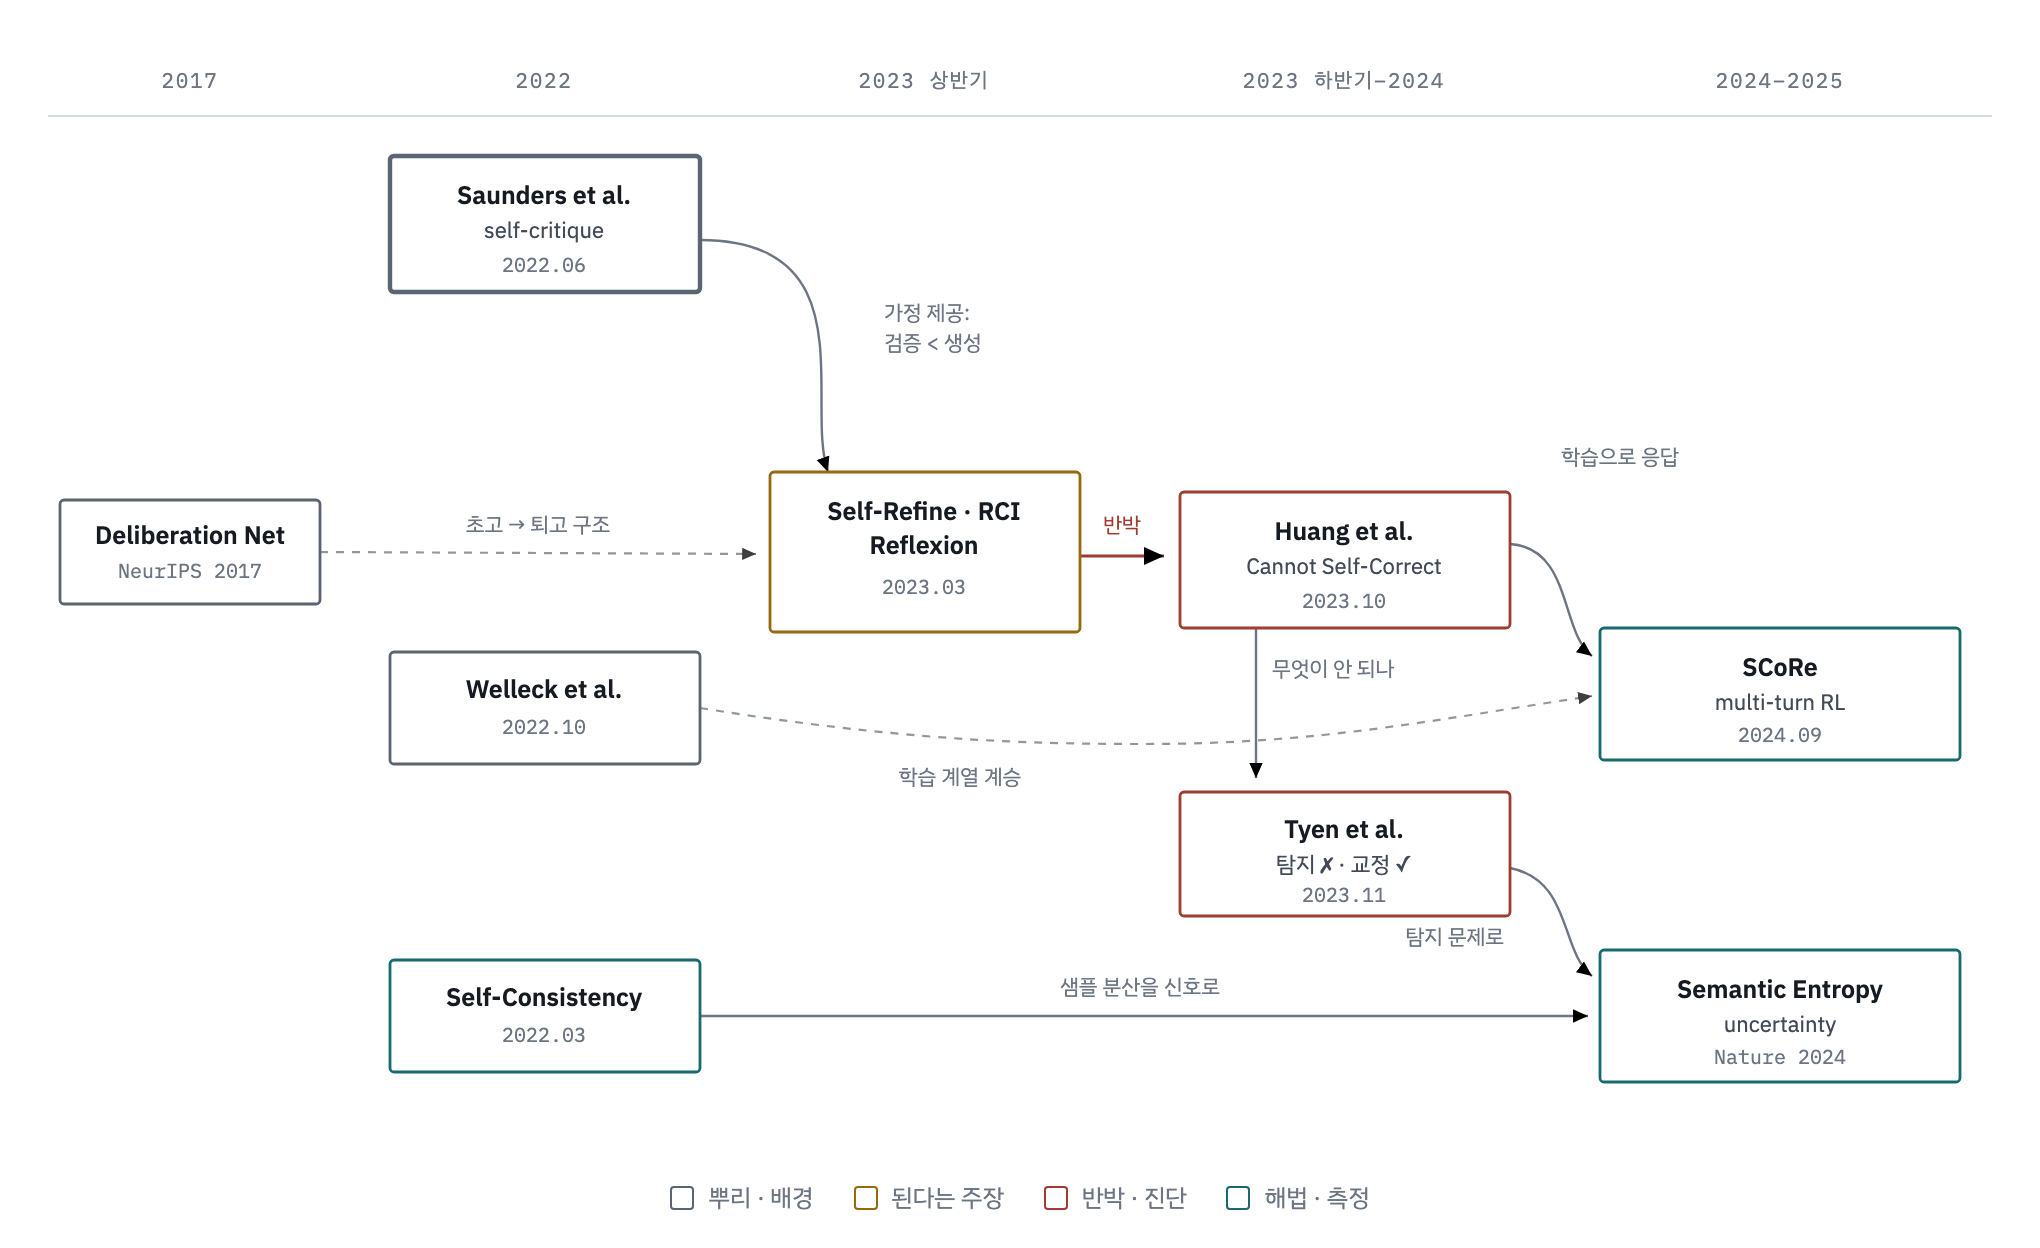
Fig. 1. self-correction 관련 논문들의 관계. 점선은 아이디어를 이어받은 관계.
0. 이 글에서 다루는 질문
LLM은 외부 도움 없이 스스로 자기 답의 오류를 찾고 고칠 수 있는가?
이 질문이 까다로운 건 "self-correction이 된다"는 말이 논문마다 조금씩 다른 뜻으로 쓰인다는 점이다. 어떤 논문은 정답 여부를 알려주는 신호를 주고, 어떤 논문은 코드 실행 결과 같은 환경 피드백을 주고, 어떤 논문은 아무것도 주지 않는다. 그래서 흐름을 따라가면서 계속 확인한 게 "이 논문은 모델에게 밖에서 무엇을 주었는가"였다. 이 기준으로 보면 서로 모순되어 보이던 결과들이 꽤 정리된다.
1. 출발점: 검증이 생성보다 쉽다는 믿음
흐름의 출발점은 2022년 OpenAI의 Saunders et al., "Self-critiquing models for assisting human evaluators"다. 모델을 학습시켜 자기 출력에 대한 비평을 쓰게 했더니, 그 비평이 사람이 놓친 결함을 실제로 찾아냈다. 이 논문은 답을 만드는 능력(generation), 답이 틀렸는지 판별하는 능력(discrimination), 그 이유를 말로 설명하는 능력(critique)을 나눠서 비교했는데, 요약 과제에서는 판별 능력이 설명 능력보다 앞선다는 관찰도 함께 나왔다(일부 합성 과제에서는 반대였다).
여기서 이후 연구들이 공유하게 되는 가정이 생긴다. 답을 맞게 만드는 것보다 답이 틀렸는지 알아보는 게 더 쉽다는 것이다. 이 가정이 맞다면, 모델에게 자기 답을 검토하게 하는 것만으로도 성능이 오를 수 있다. 흥미로운 건 Saunders et al. 스스로 Limitations에 "평가가 항상 생성보다 쉬운 것은 아니다"라고 적어 두었다는 점이다. 단서는 처음부터 있었지만, 이후 연구들은 주로 가정 쪽을 이어받았다.
같은 해 Welleck et al.의 "Generating Sequences by Learning to [Self-]Correct"는 제목에서부터 self-correct라는 이름을 전면에 내건 논문이다. 다만 여기서는 답을 고치는 별도의 corrector 모델을 학습시키는 방식이라, 지금 흔히 말하는 프롬프트 기반 self-correction과는 결이 다르다. 이 학습 계열은 나중에 다시 등장한다.
2. 낙관기: 2023년 3월의 3개의 논문
2023년 3월에는 열흘 남짓한 사이에 세 편이 연달아 나왔다. Reflexion은 환경이 준 성공·실패 신호를 모델이 말로 반성문처럼 바꿔 메모리에 쌓고 다음 시도에 활용한다. RCI는 비판하고 고치는 루프를 컴퓨터 작업 자동화에 적용했다. Self-Refine은 같은 모델이 피드백을 쓰고 그 피드백으로 답을 고치는 과정을 반복해서, 추가 학습 없이 7개 태스크에서 성능이 오른다고 보고했다.
세 논문 모두 "모델이 스스로 답을 다듬을 수 있다"는 방향을 가리켰고, 이 시기에 self-correction은 거의 기본 기법처럼 받아들여졌다. 지금 돌아보면 눈여겨볼 지점이 있다. Reflexion과 RCI는 추론 문제에서 정답 여부라는 외부 정보를 썼고, Self-Refine의 태스크들은 글 다듬기처럼 정답이 하나로 정해지지 않는 것들이 많았다. 오히려 Self-Refine에서 유일한 수학 추론 과제(GSM8K)는 개선 폭이 0~0.2%p에 그쳤다(Self-Refine Table 1). 정답이 분명한 추론 문제에서 외부 신호 없이도 되는지는 아직 제대로 검증되지 않은 상태였고, 단서는 이미 나와 있었던 셈이다.
3. 반박: 추론에서는 안 된다
분위기를 바꾼 논문이 2023년 10월에 나온 Huang et al.의 "Large Language Models Cannot Self-Correct Reasoning Yet"이다. 이 논문은 앞선 연구들의 개선이 어디서 왔는지를 하나씩 따진다.
먼저 일부 연구는 정답을 맞혔을 때 수정을 멈추는 조건을 썼는데, 이건 사실상 정답을 알려주는 것과 같다. 이 조건을 빼고 추론 벤치마크에서 다시 실험하면 self-correction은 오히려 성능을 떨어뜨렸다. 맞는 답을 틀리게 바꾸는 경우가 생기기 때문이다. 여러 모델이 토론하는 multi-agent debate도 같은 횟수만큼 샘플링해서 다수결을 내는 Self-Consistency보다 낫지 않았다. Self-Refine의 생성 과제(CommonGen-Hard)에서는 처음부터 요구사항을 프롬프트에 명시하면, 여러 번 고친 결과보다 오히려 점수가 높았다는 결과도 있었다.
Huang et al.이 Saunders et al.을 직접 언급하지는 않지만, 내 해석으로는 이 논문이 깬 건 self-correction 자체라기보다 그 밑에 깔려 있던 "검증이 생성보다 쉽다"는 가정이다. 적어도 추론 문제에서는 모델이 자기 답이 틀렸는지를 잘 알아보지 못한다는 것이다.
4. 진단: 문제는 고치는 게 아니라 찾는 것
한 달여 뒤 나온 Tyen et al.의 "LLMs cannot find reasoning errors, but can correct them given the error location"은 이 반박을 한 단계 더 쪼갠다. 오류가 어디 있는지 위치를 알려주면 모델은 꽤 잘 고친다. 그런데 오류가 어디 있는지를 스스로 찾는 건 잘 못한다. 당시 가장 강했던 GPT-4도 오류 위치를 맞힌 비율이 절반 남짓이었다.
이 흐름에서 가장 중요한 전환점은 이 논문이라고 생각한다. "self-correction은 안 된다"였던 결론이 "탐지(detection)가 안 된다"로 좁혀지기 때문이다. 문제가 이렇게 좁혀지면 해법을 찾는 방향도 달라진다.
2024년에 나온 Kamoi et al.의 서베이 "When Can LLMs Actually Correct Their Own Mistakes?"는 이 흐름을 정리해 준다. 기존 연구들을 "어떤 피드백을 썼는가" 기준으로 다시 분류해 보면, self-correction이 성공했다고 보고된 사례는 대부분 믿을 만한 외부 피드백이 있거나 대규모 파인튜닝을 한 경우였다. 프롬프트만으로 일반적인 태스크에서 성공했다는 증거는 찾기 어려웠다.
5. 이후의 두 갈래
탐지가 병목이라면 접근은 크게 두 가지로 나뉜다.
첫 번째는 학습으로 탐지와 수정 능력을 직접 심는 쪽이다. Google DeepMind의 SCoRe("Training Language Models to Self-Correct via Reinforcement Learning")가 대표적이다. 지도 학습으로 수정을 가르치면 모델이 처음 답을 거의 그대로 다시 내는 쪽으로 무너지는데, SCoRe는 multi-turn 강화학습과 보상 설계로 이 문제를 피한다. Welleck et al.에서 시작된 학습 계열이 이렇게 다시 이어진다.
두 번째는 모델에게 "확신하냐"고 묻는 대신 밖에서 불확실성을 재는 쪽이다. Self-Consistency가 여러 샘플의 다수결로 성능을 올렸다면, 같은 샘플들이 얼마나 흩어져 있는지는 그 자체로 신호가 된다. Nature에 실린 semantic entropy 논문은 샘플들을 의미 단위로 묶어 엔트로피를 재는 방식으로, 모델이 그때그때 말을 지어내는 경우를 라벨 없이 찾아낸다.
6. 앞으로 올릴 논문 리뷰
이 흐름을 따라 읽은 논문들을 하나씩 리뷰로 올릴 생각이다. 순서는 대략 이렇다.
- 출발점: Saunders et al. (2022), Welleck et al. (ICLR 2023)
- 낙관기: Reflexion, RCI, Self-Refine (모두 NeurIPS 2023)
- 반박과 진단: Huang et al. (ICLR 2024), Tyen et al. (Findings of ACL 2024), Kamoi et al. (TACL 2024)
- 비교 기준: Self-Consistency (ICLR 2023)
- 이후의 갈래: SCoRe (ICLR 2025), Semantic Entropy (Nature 2024)
hallucination detection(RAGTruth 등)과 추론 과정의 오류 탐지(ProcessBench 등) 쪽 논문들도 같이 읽고 있어서 중간중간 섞어 올릴 예정이다.