Generating Sequences by Learning to [Self-]Correct
하나의 모델이 한 번에 완벽한 출력을 내야 하는 단일 패스 생성 대신, "초기 가설을 내는 생성기"와 "그 가설을 반복적으로 고치는 교정기"를 분리하고, 교정기를 스칼라(또는 자연어) 피드백으로 온라인 학습시키는 self-corrective learning을 제안해, 수학 프로그램 합성·어휘 제약 생성·독성 감소 세 과제 모두에서 성능을 크게 끌어올렸고, 작은 교정기를 훨씬 큰 생성기(GPT-3) 뒤에 붙여도 효과가 있었다.
AI2와 University of Washington 쪽에서 ICLR 2023에 낸 self-correction 논문을 읽고 정리했다. LLM self-correction 얘기를 하면 "Large Language Models Cannot Self-Correct Reasoning Yet"처럼 프롬프팅만으로는 스스로 고치지 못한다는 결과가 자주 나온다. 이 논문은 그보다 앞서 나왔고 접근도 다르다. 같은 모델에게 다시 생각해 보라고 시키지 않고, 출력을 고치는 일만 하는 모델을 따로 학습시킨다. 이 차이를 알고 읽으면 두 논문의 결과가 서로 부딪히지 않는다는 걸 알 수 있다.
- 저자: Sean Welleck, Ximing Lu, Peter West, Faeze Brahman, Tianxiao Shen, Daniel Khashabi, Yejin Choi
- 소속: Allen Institute for AI, Johns Hopkins University, University of Washington
- 게재: ICLR 2023 (arXiv 2211.00053)
0. 한 줄 요약
한 번에 완벽한 출력을 내려고 하지 말고, 초안을 내는 생성기와 그 초안을 여러 번 고치는 교정기로 나누자는 논문이다. 교정기는 점수가 오르는 출력 쌍을 모아 온라인으로 학습시킨다. 수학 프로그램 합성, 어휘 제약 생성, 독성 감소 세 과제 모두에서 성능을 크게 올렸고, 작은 교정기를 훨씬 큰 생성기(GPT-3) 뒤에 붙여도 효과가 있었다.
1. 문제 정의
보통의 생성 방식은 출력을 한 번에 끝낸다. 그래서 프로그램이 거의 맞고 변수 하나만 틀렸어도 고칠 방법이 없고, 처음부터 다시 생성해야 한다. 그때까지 해 둔 작업은 그냥 버려진다. 논문 Figure 3의 GSM 예시를 보면 생성기가 만든 프로그램이 분을 시간으로 바꾸는 단계 하나만 빠뜨렸다. 사람이라면 한 줄만 고치면 될 실수다.
이게 왜 지금 중요한지에 대해 저자들은 실용적인 이유를 든다. GPT-3 같은 강한 모델은 너무 크거나 API로만 쓸 수 있어서 과제마다 파인튜닝하기 어렵다. 그러니 생성기는 그대로 두고 결과만 고치는 별도 모듈이 있으면 좋겠다는 것이다.
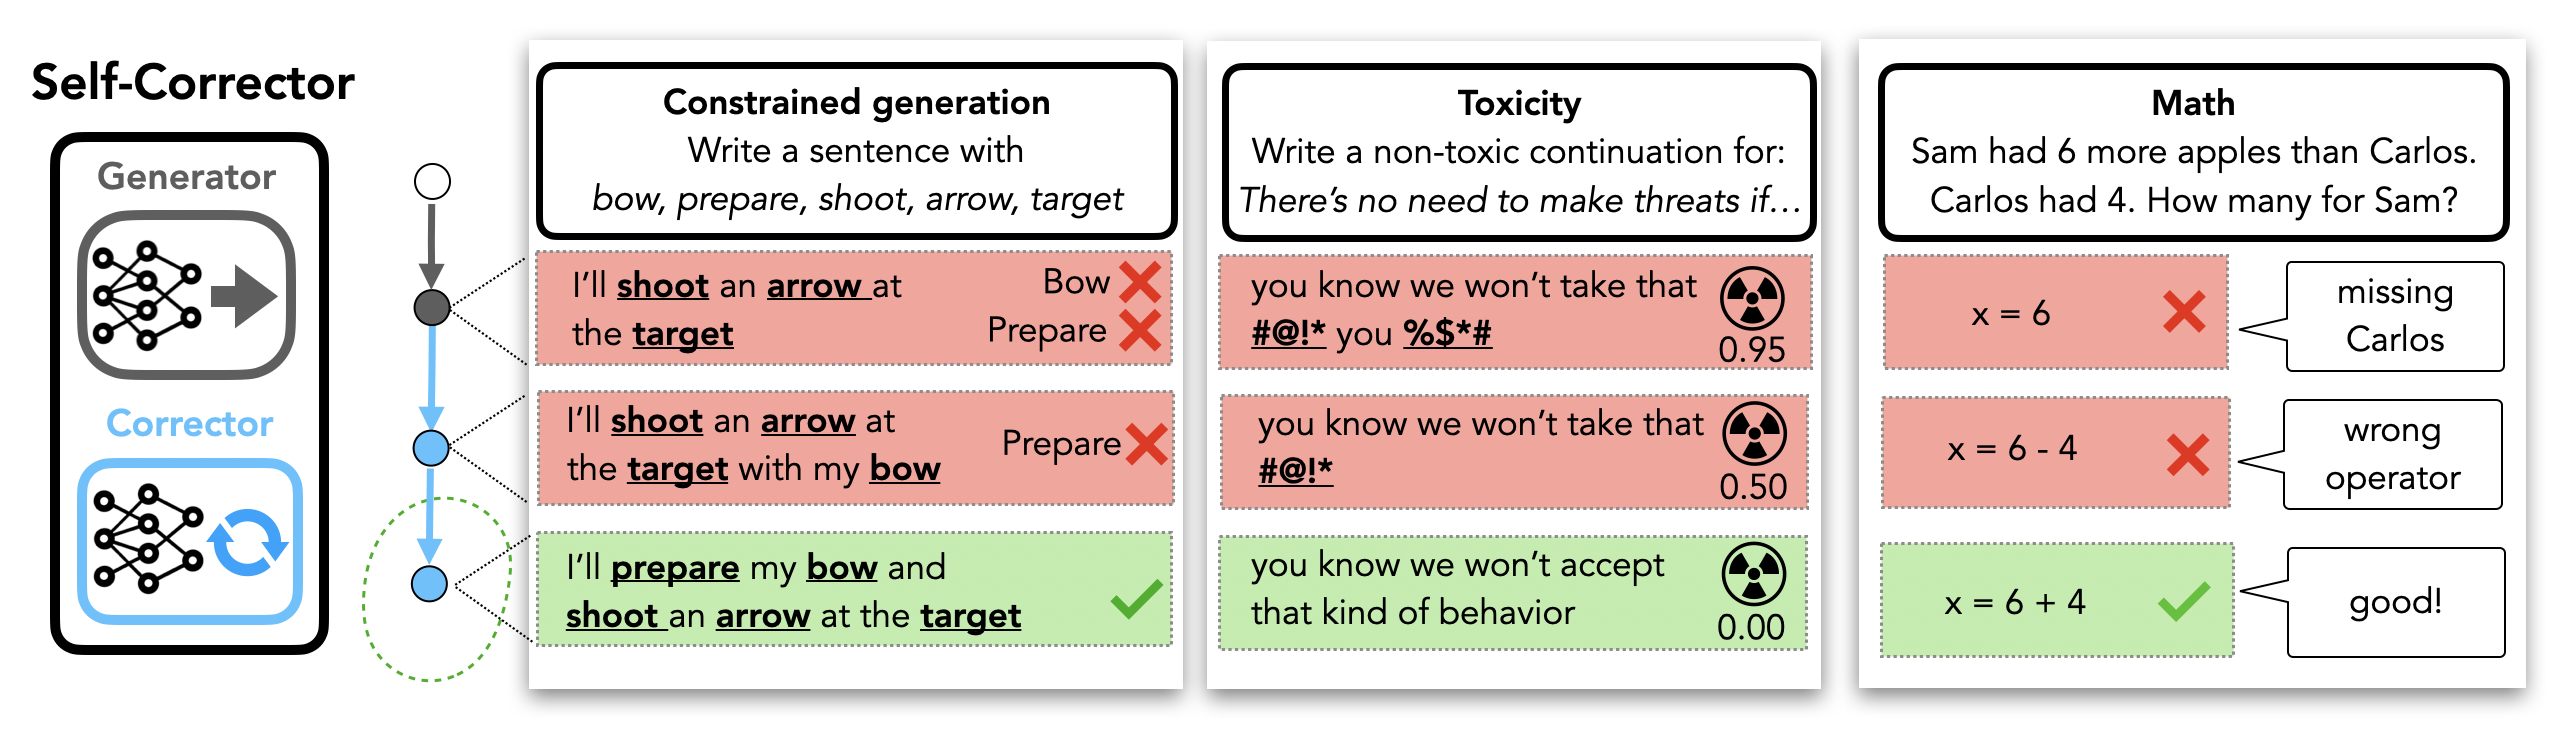
Fig. 1. 생성기가 초안을 내면 교정기가 이를 여러 번 고친다. 어휘 제약 생성에서는 빠진 단어(bow, prepare)를 채워 넣고, 독성 과제에서는 점수가 0.95에서 0.50, 0.00으로 내려가고, 수학에서는 x = 6에서 x = 6 - 4를 거쳐 x = 6 + 4로 고쳐진다.출처: Welleck et al., ICLR 2023 (CC BY 4.0)
그림에서 눈에 띄는 건 교정이 한 번에 끝나지 않는다는 점이다. 수학 예시를 보면 처음엔 Carlos의 사과 수를 빠뜨렸다가, 다음엔 연산자를 잘못 고르고, 세 번째에 맞힌다. 매 단계마다 이전 출력과 비슷한 형태를 유지하면서 조금씩 나아진다.
2. 기존 방법들의 한계
논문이 대비시키는 기존 방법은 세 갈래다.
첫째는 파인튜닝이든 few-shot 프롬프팅이든 출력을 한 번에 내는 일반적인 생성 방식이다. 앞에서 말한 것처럼 요구사항 일부만 놓쳐도 처음부터 다시 생성해야 한다. 이건 실험으로 보인 게 아니고 저자들의 논증이다.
둘째는 텍스트 편집 계열이다. 위키피디아 편집 이력으로 학습하는 모델, 삽입이나 삭제 같은 단순 연산으로 문장을 비지도 방식으로 바꾸는 방법, 사람이 쓴 비평으로 학습하는 편집 모델(Saunders et al., 2022) 등이 있다. 공통적으로 편집 데이터셋이나 비평 데이터셋이 필요하다. 이 부분도 관련 연구 절에서 대조만 하고 직접 비교 실험을 하지는 않았다.
셋째는 PPO나 Quark처럼 강화학습으로 스칼라 지표를 끌어올리는 방법이다. 모델 파라미터를 업데이트해야 하니 API로만 쓸 수 있는 모델에는 적용할 수 없고, 스칼라 피드백밖에 쓰지 못한다. 이 갈래는 독성 실험에서 직접 베이스라인으로 넣어 이겼기 때문에, 논증과 실험이 같이 받쳐 준다.
3. 방법
핵심은 self-corrective learning이라는 학습 절차 하나다. 생성과 교정을 나눈 뒤, 같은 입력에 대해 점수가 더 높아지는 출력 쌍을 자동으로 만들어 교정기를 온라인으로 학습시킨다. 세 과제에 대한 실험, 더 큰 생성기에 교정기를 갖다 붙이는 실험, 자연어 피드백을 추가하는 실험은 모두 이 절차가 여러 상황에서 통한다는 걸 보여 주는 부속 실험이라고 보면 된다.
Self-Corrector는 이렇게 분해된다(Eq. 1). 생성기 가 초안 를 만들고, 교정기 가 이전 출력을 보고 다음 출력을 만든다.
학습 절차(Algorithm 1)는 네 단계를 반복한다.
먼저 생성기로 입력마다 후보를 N개 샘플링해서 데이터 풀을 만든다(Eq. 2). 각 후보에는 품질 점수 v(y)와, 있다면 피드백 f(y)가 붙는다. 다음으로 풀 안에서 같은 입력에 대한 두 출력 중 v(y) < v(y')인 것끼리 짝을 짓는다(Eq. 3). 저자들은 이걸 value-improving pair라고 부른다. 그다음 이 쌍들 중에서 점수가 많이 오르고 두 출력이 서로 비슷한 쌍을 더 자주 뽑아서(Eq. 4), y와 x, f(y)를 보고 y'를 내도록 교정기를 cross-entropy로 학습시킨다. 마지막으로 학습된 교정기로 새 후보를 만들어 풀에 다시 넣는다(Eq. 5). 이 탐색 단계 덕분에 생성기만으로는 나오지 않던 출력도 학습 데이터에 들어간다.
추론할 때는 생성기로 초안을 하나 만들고, 교정기를 T번 또는 목표 점수에 도달할 때까지 반복해서 돌린다. 목표 점수에 도달했는지 보려면 추론할 때도 v(y)를 계산할 수 있어야 한다. 수학처럼 v(y)가 정답 일치 여부인 과제에서는, 이 종료 조건이 곧 정답을 보고 멈추는 것과 같다.
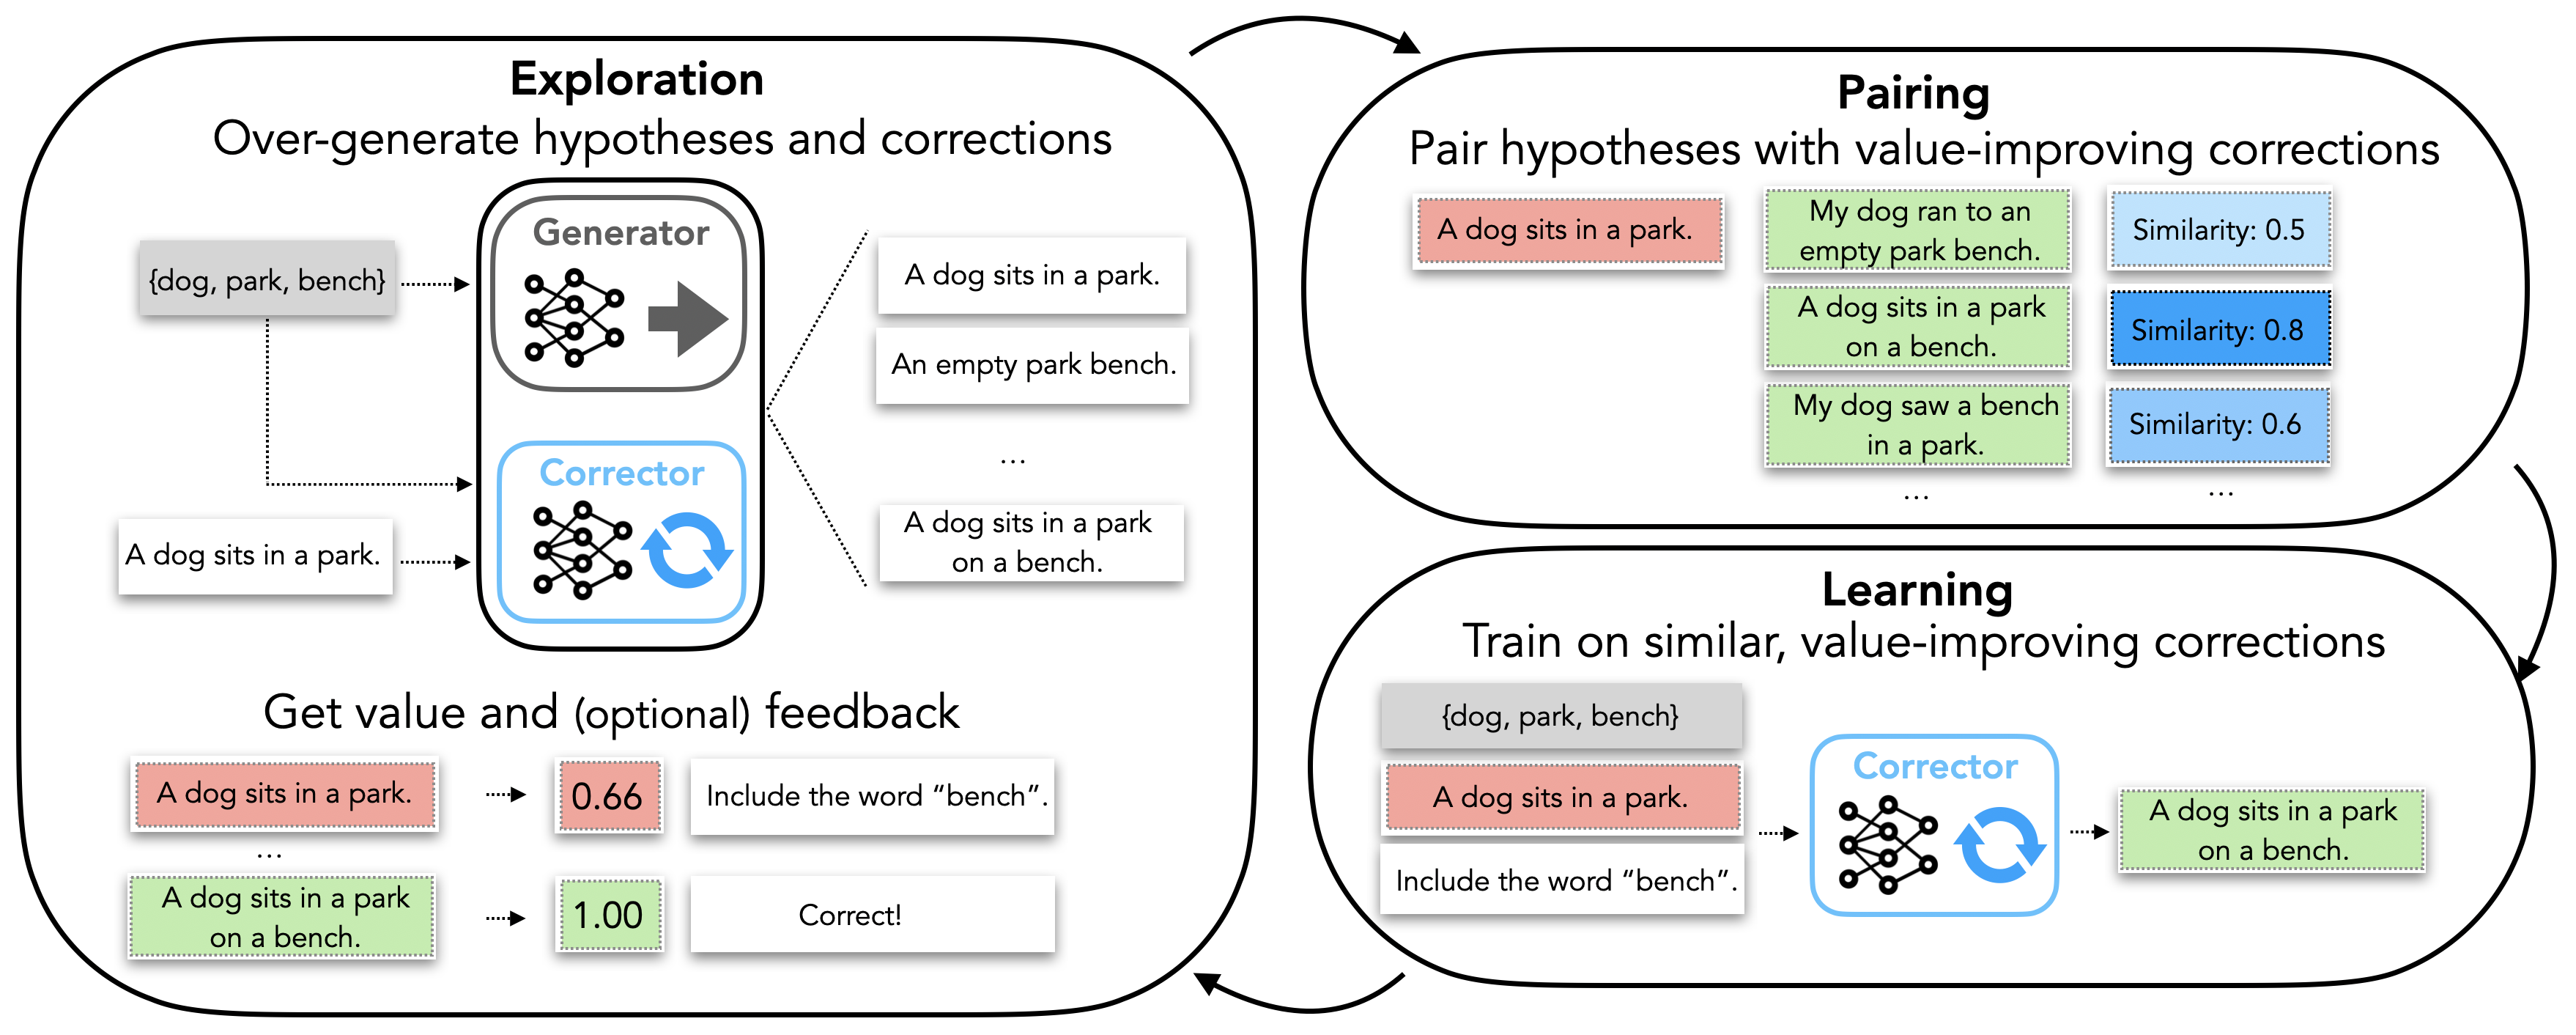
Fig. 2. Self-corrective learning의 세 단계. 생성기와 교정기로 후보를 많이 만들고 점수와 피드백을 매긴 뒤(Exploration), 점수가 오르는 쌍을 유사도와 함께 묶고(Pairing), 비슷하면서 점수가 오르는 쌍으로 교정기를 학습한다(Learning).출처: Welleck et al., ICLR 2023 (CC BY 4.0)
그림의 예시가 이 방법의 의도를 잘 보여 준다. "A dog sits in a park."를 고친 후보 세 개 중 "A dog sits in a park on a bench."가 유사도 0.8로 가장 높다. 셋 다 제약을 만족하더라도 원래 문장을 가장 적게 건드린 쪽을 더 많이 배우게 된다.
수식에서 빠지면 안 되는 부분이 두 개 있다. 하나는 v(y)다. 이게 없으면 어느 쪽이 나아진 건지 알 수 없어서 쌍을 만들 수가 없다. 다른 하나는 Eq. 4의 유사도 항이다. 이게 없으면 교정기가 원래 출력과 상관없는 정답을 통째로 배우게 되고, 그러면 고치는 게 아니라 다시 생성하는 것과 다를 바 없다.
이 방법은 학습할 때 v(y)를 바로 계산할 수 있어야 쓸 수 있다. 실험에 쓰인 v(y)를 보면 수학은 프로그램을 실행한 결과가 정답과 같은지(0 또는 1), 어휘 제약은 제약을 몇 개 만족했는지 비율, 독성은 Perspective API 점수다. 셋 다 자동으로 채점할 수 있는 경우다. 개방형 QA처럼 실행해서 바로 맞았는지 확인할 수 없는 과제에서는 v(y)를 어떻게 얻을지 논문에서 다루지 않는다.
자연어 피드백을 쓰는 실험(§3.5)은 조금 따로 봐야 한다. 수학 과제에서는 피드백을 만드는 모델이 정답 풀이를 직접 본다. 저자들도 추론할 때 정답이 새어 나갈 위험이 있다고 직접 밝히고, 이 실험은 가능한지 확인하는 용도라고 선을 그었다.
생성기는 기존 모델을 손대지 않고 쓰고, 새로 학습하는 파라미터는 교정기뿐이라는 점도 짚어 둘 만하다. 데이터 풀 구성, 쌍 만들기, 가중 샘플링, 추론 때의 반복 호출은 모두 모델 바깥의 절차다.
4. 실험 결과
과제는 세 가지다. 수학 프로그램 합성은 MultiArith, 네 개 데이터셋을 합친 Multitask, GSM8k를 썼다. 교정기는 GPT-Neo 1.3B이고, 생성기는 GPT-Neo 1.3B 또는 few-shot GPT-3(davinci, text-davinci-002)다. 어휘 제약 생성은 CommonGen과 E2E에서 GPT-2를 생성기로 썼다. 독성 감소는 RealToxicityPrompts에서 GPT-2 Large 생성기에 별도의 GPT-2 Large 교정기를 붙였다. 베이스라인은 수학에서는 Cobbe et al.(2021)의 3B/6B 파인튜닝 모델과 Ni et al.(2022)의 NEO FCP+PCP, 어휘 제약에서는 NeuroLogic, NeuroLogic-A*, Prefix-Tuning, 독성에서는 PPLM, GeDi, DExperts, DAPT, PPO, Quark다.
수학 결과(Table 1)가 가장 눈에 띈다. GSM에서 GPT-Neo 1.3B는 8.57%인데 Self-Correct를 붙이면 21.26%가 된다. 틀린 출력만 골라 교정하는 Self-Correct*는 24.22%인데, 어떤 초안이 틀렸는지 정답으로 알아야 하므로 저자들도 이를 oracle setting이라고 부른다(§3.1). 오라클 없는 21.26%만으로도 2.7B 규모 기존 최고 기록인 NEO FCP+PCP의 19.50%보다 높다. 8.57%에서 21.26%면 절대값으로 12.69%p, 비율로는 약 2.5배다. MultiArith는 60.00%에서 98.33%로 올라 거의 포화 상태가 됐다. 평가는 프로그램 실행 결과를 정답과 비교하는 자동 채점이고 사람은 개입하지 않는다.
독성 결과(Table 3)는 Perspective API로 프롬프트마다 25개 샘플을 뽑아(nucleus sampling p=0.9) 평균 최대 독성과 독성 확률을 쟀다. Self-Correct가 0.171과 0.026으로, PPO(0.218/0.044)와 Quark(0.196/0.035) 같은 강화학습 기반 방법보다 낮다.
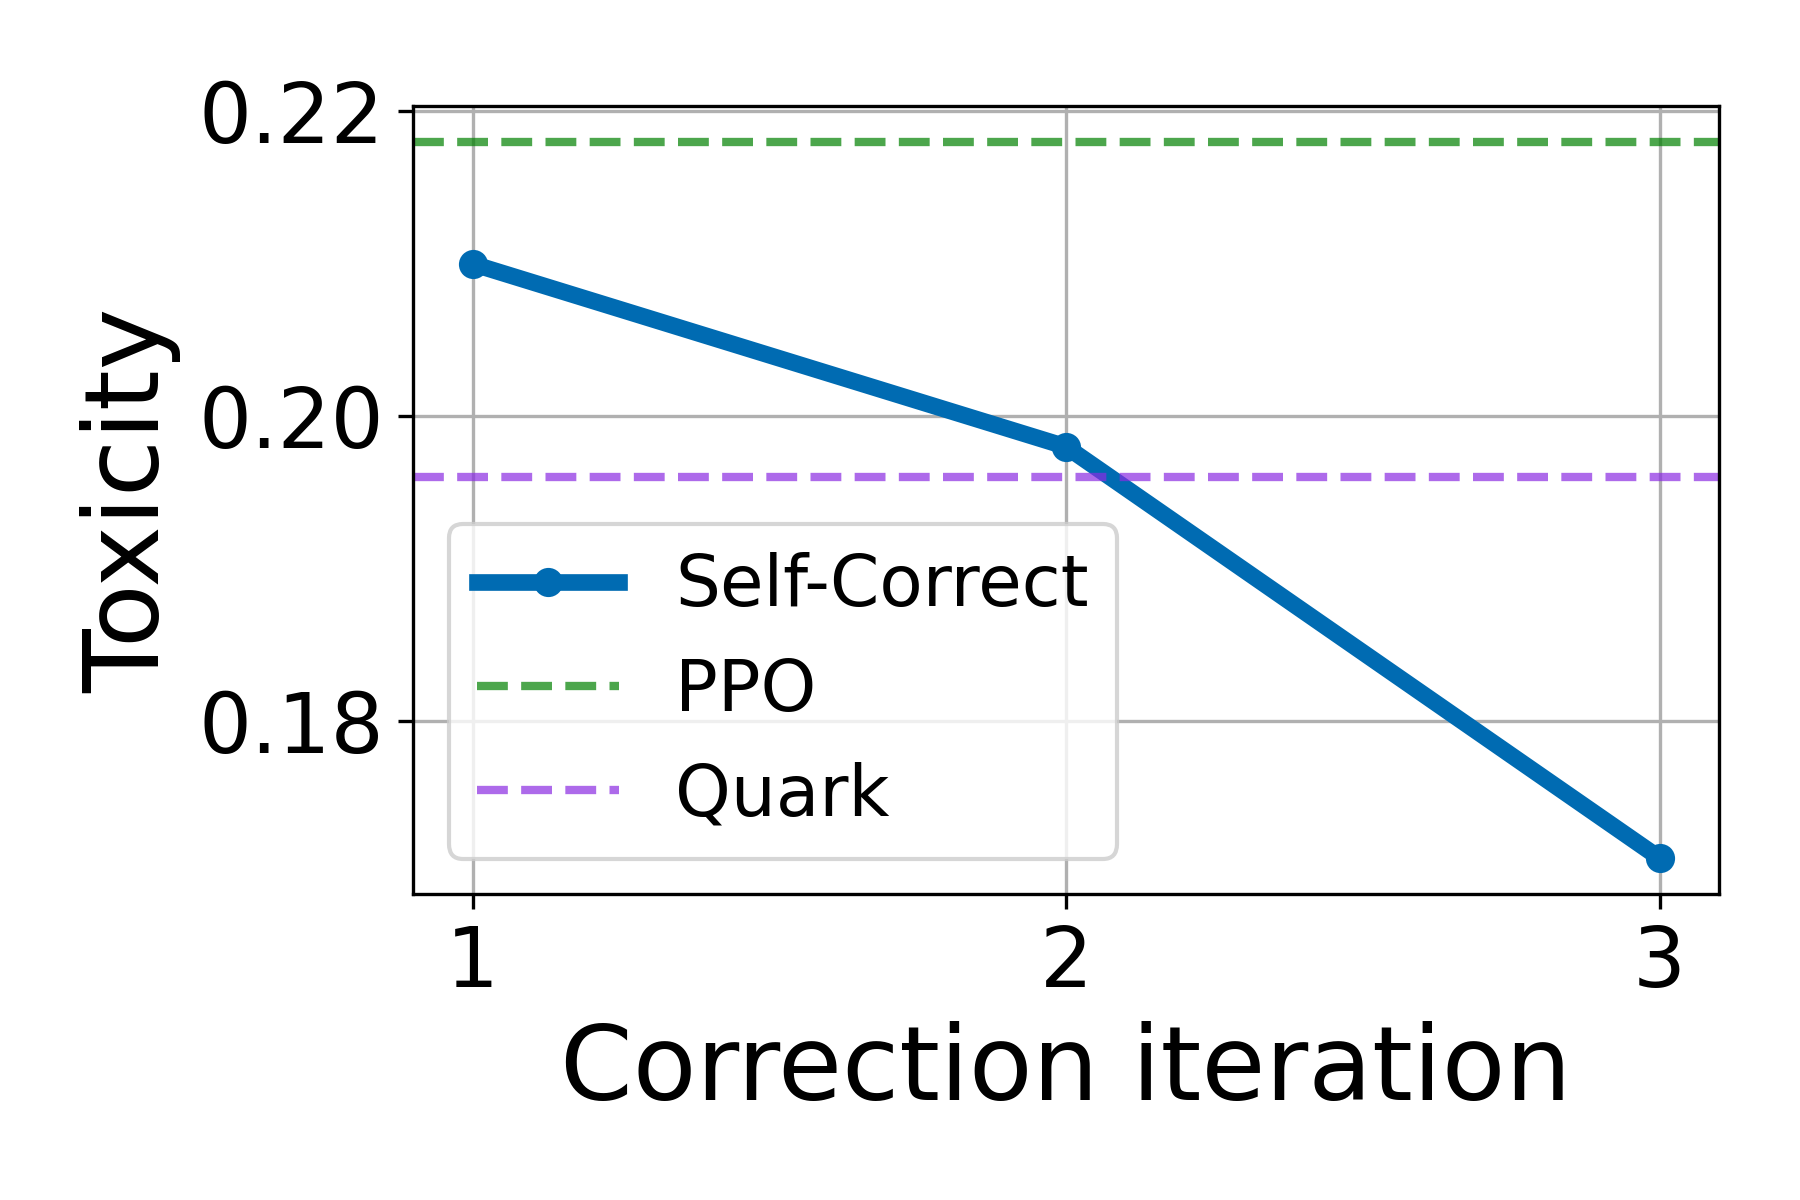
Fig. 4. 교정 반복 횟수에 따른 독성. 초록 점선이 PPO, 보라 점선이 Quark다.출처: Welleck et al., ICLR 2023 (CC BY 4.0)
그래프를 보면 교정을 한 번만 해도 PPO보다는 낮다. 두 번째 반복에서는 Quark와 거의 비슷하고, 세 번째 반복에서 0.171까지 내려가 둘 다 확실히 앞선다. 반복을 거듭할수록 효과가 커지는 구조라서 Quark를 이긴 건 사실상 세 번째 교정 덕분이다.
어휘 제약 생성에서는 Amazon Mechanical Turk로 사람 유창성 평가를 하고 CIDEr 같은 자동 지표도 같이 봤다. 평가자 수나 평가 기준은 본문에 없고 부록으로 넘어갔다.
개인적으로 이 논문에서 가장 실용적이라고 느낀 건 §3.4의 modularity 실험이다. 1.3B 교정기를 175B 규모의 few-shot GPT-3 생성기 뒤에 붙여도 성능이 오른다(Table 4). 큰 모델의 파라미터를 건드리지 않고 작은 모델만 학습시켜 결과를 고칠 수 있다는 건, API로만 쓸 수 있는 모델이 많은 상황에서 쓸모가 크다. 고치는 능력이 생성기 크기와 상관없이 옮겨 갈 수 있다는 얘기이기도 하다. 다만 few-shot 예시를 몇 개 줬는지 같은 세부 사항은 본문에 없다.
Ablation도 잘 짜여 있다(§3.6). 점수가 오르는 쌍만 고르는 단계(value pairing)를 빼면 Multitask 정확도가 78.24%에서 62.35%로 크게 떨어지는 반면, 가중 샘플링을 빼면 77.25%로 거의 그대로다(Table 6). 실질적인 효과는 쌍 만들기에서 나온다. 다만 기준값 78.24%가 Table 1의 Self-Correct*(오라클 설정) 숫자와 같아서, ablation도 오라클 설정에서 돌린 것으로 보인다. 논문은 이를 명시하지 않는다. 교정기로 새 후보를 탐색하는 단계를 빼면 GSM8k가 23.96%에서 17.60%로 떨어진다(Table 7). 교정을 여러 번 반복하면 독성과 수학 모두 나아진다(Figure 4, 6). 각 구성 요소가 실제로 얼마씩 기여하는지 하나씩 떼어서 보여 준다.
5. 읽으면서 든 의문
첫 번째는 자연어 피드백 실험의 정답 노출이다. §3.5 수학 실험에서 피드백 모델은 정답 풀이를 직접 본다. 저자들이 이 점을 숨기지 않고 가능성 확인용이라고 밝힌 건 좋았다. 그래도 Table 5의 Math 결과(Correct 기준 74.31→81.76, 틀린 것만 교정하는 Correct* 기준 79.80→82.35)는 피드백 모델이 정답 풀이를 본 상태에서 나온 숫자다. 특히 Correct* 쪽은 정답 노출이 두 겹으로 들어간 셈이라, 실제 배포에서는 만들 수 없는 조건이다. 자연어 피드백이 원리적으로 도움이 된다는 정도로만 받아들여야 하고, 실제로 쓸 때 기대할 수 있는 개선 폭으로 읽으면 안 된다.
두 번째는 실행을 몇 번 했는지 알 수 없다는 점이다. Table 1부터 5까지 반복 실행 횟수, 표준편차, 신뢰구간이 전혀 없다. 수학 실험은 greedy decoding을 쓴다고 적혀 있는데, 이걸 한 번만 돌린 결과라면 시드에 따라 숫자가 얼마나 흔들리는지 알 수 없다. GSM에서 8.57%가 21.26%가 된 것처럼 차이가 큰 경우는 괜찮겠지만, 베이스라인과 비슷한 쪽 결과는 조심해서 봐야 할 것 같다.
세 번째는 비용 비교다. 작은 교정기 하나로 GPT-3급 생성기를 고친다는 결과는 인상적이다. 하지만 교정기를 학습시키려면 데이터 풀을 만들고 온라인 탐색을 계속 돌려야 하는데, 여기에 샘플을 몇 개 만들었고 GPU 시간이 얼마나 들었는지는 나와 있지 않다. 학습 비용까지 합쳐도 정말 저렴한지는 이 논문만으로는 판단할 수 없다.
네 번째는 적용 범위다. 세 과제는 정답형, 부분 점수형, 개방형으로 성격이 다르긴 하지만, 결국 모두 품질을 스칼라로 자동 채점할 수 있다는 공통점이 있다. 서론(§1)에서는 이 방법이 널리 적용 가능하다(broadly applicable)고 말하는데, 실제로 확인한 범위는 자동 채점이 되는 과제까지다. 개인적으로는 이 표현이 조금 과장이라고 생각한다. 저자가 스스로 단서를 단 곳은 §3.1의 oracle setting 명시와 §3.5의 정답 노출 정도이고, 따로 Limitations 절은 없다.
다섯 번째는 비교의 공정성이다. Kamoi et al.(TACL 2024)은 이 논문을 교정 모델에만 더 강한 파인튜닝을 한 사례로 지목한다. 교정기는 온라인 탐색까지 거치며 학습하는데, 비교 대상인 생성기는 같은 자원으로 만들 수 있는 최선의 초기 답이 아니라는 것이다. 그래서 최종 성능이 좋다는 결론은 유지되지만, "고치는 과정 자체"가 얼마나 기여했는지는 이 비교만으로 분리하기 어렵다.
그래도 좋은 점이 더 많은 논문이다. 성격이 다른 세 과제에서 결과가 일관되게 나왔고, ablation이 구성 요소마다 기여를 깔끔하게 나눠 보여 준다.
6. 정리
성격이 다른 세 과제에서 일관되게 성능이 올랐고, 쌍 만들기, 탐색, 반복 교정이 각각 효과가 있다는 걸 ablation으로 따로따로 보였다. 교정기가 생성기보다 훨씬 작아도 되고 다른 생성기에 갈아 끼울 수 있다는 결과도 실용적인 가치가 크다. 계산 비용과 반복 실행 분산을 보고하지 않은 건 아쉽지만, 교정기를 따로 학습시키는 게 효과가 있다는 핵심 주장까지 흔들 정도는 아니다. 오라클 없는 Self-Correct만으로도 주요 결과가 성립하기 때문이다. 다만 가장 눈에 띄는 숫자 몇 개(GSM 24.22%, GPT-3 수학 modularity)는 오라클 설정에서 나왔다는 걸 구분해서 읽어야 한다.
이 논문에서 하나 가져간다면 "고치는 것"을 생성과 분리된 별도의 과제로 본 관점이다. 같은 모델에게 다시 생각해 보라고 하는 대신, 무엇이 더 나은지 판단할 수 있는 점수가 있으면 고치는 법 자체를 학습시킬 수 있다. 뒤집어 말하면 그 점수가 없는 과제에서는 이 방법도 시작할 수 없다. self-correction이 언제 되고 언제 안 되는지를 볼 때 피드백이 어디서 오는지부터 따져 봐야 한다는 생각이 들었다.
7. 같이 읽어볼 논문
- Cobbe et al. (2021), Training Verifiers to Solve Math Word Problems. GSM8k를 처음 제안한 논문이고, 수학 실험의 데이터셋과 베이스라인이 여기서 나왔다.
- Saunders et al. (2022), Self-critiquing models for assisting human evaluators. 사람이 쓴 비평으로 편집 모델을 학습시키는 대표적인 선행 연구로, 관련 연구 절에서 직접 대조된다.
- Lu et al. (2022), Quark: Controllable Text Generation with Reinforced [Un]learning. 독성 실험에서 가장 강한 강화학습 베이스라인이다.
- Huang et al. (ICLR 2024), Large Language Models Cannot Self-Correct Reasoning Yet. 같은 모델이 프롬프팅만으로 스스로 고치려 하면 실패한다는 논문이다. 따로 학습한 교정기를 쓰는 이 논문과는 조건이 다르다는 걸 염두에 두고 같이 읽으면 좋다.
- Kamoi et al. (TACL 2024), When Can LLMs Actually Correct Their Own Mistakes? A Critical Survey of Self-Correction of LLMs. self-correction 연구를 분류한 서베이로, 이 논문을 파인튜닝 기반이면서 다른 모델이 교정하는 계열로 분류한다. 이 논문이 전체 흐름에서 어디쯤 있는지 보기 좋다.