Self-critiquing models for assisting human evaluators
답변의 결함을 짚어주는 "비평" 모델을 지도학습으로 훈련했더니, 사람이 놓쳤던 결함(특히 의도적으로 숨긴 오류)을 훨씬 더 잘 찾아냈고 모델이 클수록 비평 능력도 함께 좋아졌지만, 요약 과제에서는 "답이 나쁘다는 걸 판별하는 능력(D)"이 "그 결함을 말로 설명하는 능력(C)"보다 모든 모델 크기에서 앞서 있어 모델이 알고도 말하지 않는 지식이 존재함을 시사한다.
OpenAI가 2022년에 공개한 self-critique 논문을 읽고 정리했다. 앞서 self-correction 서베이(Kamoi et al., TACL 2024)를 읽다가, 이 논문의 "검증이 생성보다 쉽다"는 가정을 다시 따져보는 대목이 나와서 원문을 직접 확인하고 싶었다. 이 논문은 scalable oversight를 실제 언어 모델로 실험해 본 초기 연구 중 하나다. scalable oversight는 사람이 직접 평가하기 어려운 과제를 AI의 도움을 받아 평가하자는 문제의식이다.
- 저자: William Saunders, Catherine Yeh, Jeff Wu, Steven Bills, Long Ouyang, Jonathan Ward, Jan Leike
- 게재: arXiv 2206.05802 (2022.06), OpenAI 블로그
- 데이터: 학습에 쓴 데이터셋(base, critique, helpfulness의 train/test)과 보조 실험 데이터셋을 공개했다(§2.2.1, §3.4 각주).
0. 한 줄 요약
답변의 결함을 짚어주는 비평 모델을 지도학습으로 훈련해 사람에게 보여줬더니, 사람이 놓치던 결함을 훨씬 많이 찾았다. 특히 일부러 숨겨 둔 오류를 잘 찾았다. 그런데 요약 과제에서는 모델이 답이 나쁘다는 걸 판별하는 능력이 그 이유를 말로 설명하는 능력보다 모든 모델 크기에서 앞서 있었다. 알면서도 말하지 않는 지식이 있다는 뜻이다.
1. 문제 정의
코드의 버그나 긴 글의 사실 오류를 사람이 하나하나 확인하기는 어렵다. 모델이 사람도 평가하기 힘든 과제를 맡게 될수록 사람의 평가 능력을 어떻게 키울지가 alignment의 핵심 문제가 된다는 게 저자들의 출발점이다(§1).
실험 과제는 주제 기반 요약이다. 위키, 뉴스, 단편소설에서 뽑은 지문 2,000여 개에 질문 6,000여 개를 붙여, 지문에서 특정 주제에 해당하는 내용을 요약하게 한다(§2.2). 요약문의 결함을 찾으라고 하면 사람 라벨러도 놓치는 게 꽤 있다. 일부러 오류를 숨겨 놓은 요약에서는 도움 없이 27%만 찾아냈다(§3.3.1). 이 숫자를 보면 "사람이 보면 알겠지"라는 가정을 그대로 믿기 어렵다.
2. 기존 방법들의 한계
논문은 관련 연구를 세 갈래로 정리한다. 다만 셋 다 정량적으로 비교한 게 아니라 저자들이 서술한 내용이다.
첫째는 iterated amplification, debate, recursive reward modeling 같은 이론적 제안이다. 문제의식은 이 논문과 같지만, 장난감 과제나 알고리즘 과제에서만 검증됐고 실제 언어 모델과 현실적인 과제로 실험한 사례는 부족했다(§6).
둘째는 debate를 실제로 실험한 연구들이다. 영화 리뷰나 물리 문제처럼 현실적인 과제에서 사람을 토론자로 세워 실험했지만 결과는 엇갈렸다(§6).
셋째는 모델로 사람을 도와 데이터를 모으는 연구들이다. 적대적 예시를 찾거나 QA를 보조하는 비슷한 아이디어는 있었지만, 비평으로 평가를 돕는 방식을 체계적으로 정리하고 모델 크기에 따른 변화까지 본 건 이 논문이 처음이라고 저자들은 주장한다(§1, §6).
3. 방법
핵심은 질문, 답, 비평을 한 모델에 함께 behavioral cloning으로 학습시키고, 그 비평이 사람의 결함 발견을 실제로 돕는지 실험으로 확인한 것이다. 스케일링 분석, refinement 실험, GDC gap 분석은 이 결과를 여러 각도에서 뜯어보는 부속 실험이라고 보면 된다.
과제는 다섯 가지로 나뉜다(Table 1). 기본 과제에서는 질문을 받고 요약을 쓴다. critiqueability 과제에서는 질문과 답을 보고 결함이 있는지 Yes/No로 판별한다. critique 과제에서는 그 결함을 자연어로 짚는다. helpfulness 과제에서는 비평이 타당하고 쓸모 있는지 Yes/No로 판별한다. 마지막으로 refinement 과제에서는 비평을 반영해서, 또는 비평 없이 바로 답을 고친다. 크기가 다른 GPT-3 계열 사전학습 모델 5개를 이 과제들로 라운드마다 순서대로 학습시켰고, 라운드마다 사람 라벨러가 시연 데이터를 새로 썼다(§2.2.1).
수식이라고 할 만한 건 점수 하나다.
Yes/No를 샘플링하는 대신 logit에서 확률을 다시 계산한 값이다(§2.2.2). 단순해 보여도 이 점수가 있어야 비평을 쓸지 말지 정하고, 여러 비평 중 어느 게 나은지 연속값으로 줄 세울 수 있다. 뒤에 나오는 best-of-N이 전부 이 점수를 쓴다.
사람을 보조하는 방식은 이렇다(§3.2). 모델이 temperature를 바꿔 가며 비평을 최대 8개 만들고, 중복을 걸러 helpfulness score 순으로 정렬해 보여준다. 라벨러는 그 비평을 그대로 쓰거나, 고쳐 쓰거나, 무시한다. 비평을 만드는 건 모델이지만, 중복 제거와 정렬은 후처리 로직이고 최종 판단은 사람이 한다. 결과를 읽을 때 이 셋을 구분해 둘 필요가 있다.
전제도 몇 가지 짚어 둔다. 보조 실험의 정답은 결국 다른 라벨러의 판단이라 확실한 ground truth가 없다. 저자들도 한계로 직접 적었다(§7.2). refinement 실험은 모델 자신의 critiqueability·helpfulness score로 best-of-N을 고르는데, 이 점수는 같은 라벨러 판단으로 학습한 프록시다. 배포할 때도 쓸 수는 있지만, 라벨러의 판단 습관과 편향을 그대로 물려받는다. GDC gap 분석에서는 합성 과제에 hand-coded oracle을, 요약 과제에는 사람 판단을 정답으로 썼다(§2.3, §5.2.1). decoding 설정은 꽤 자세히 나와 있다. refinement는 temperature 0.5(§4.3), 합성 과제의 GDC gap 측정은 답 temperature 1, 비평 temperature 0이다(§5.3).
4. 실험 결과
실험은 주제 기반 요약과 합성 과제 4개(Addition, 3-SAT, Alphabetize, RACE)로 했다(§2.3, Table 3). 모델 5개가 서로 다른 사전학습 세트를 써서 파라미터 수로 바로 비교할 수가 없다. 그래서 모델 규모 대신 파인튜닝 loss를 스케일 축으로 썼다(§2.2.2). 베이스라인은 InstructGPT 스타일 모델의 zero-shot, few-shot 비평이다(§4.1).
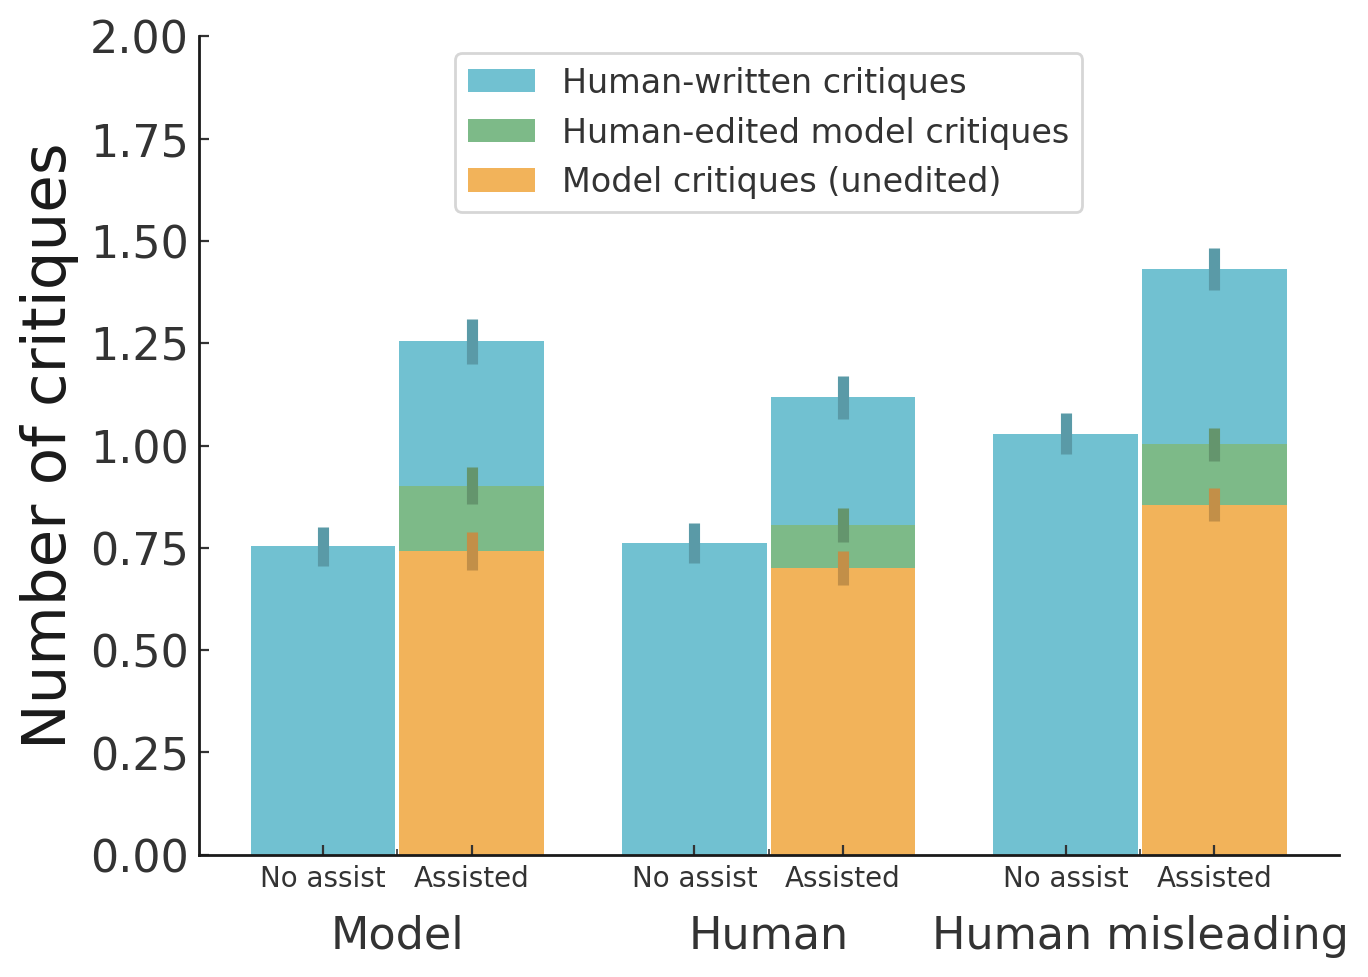
Fig. 1. 답변 출처(모델이 쓴 답, 사람이 쓴 답, 사람이 일부러 오류를 숨긴 답)별로 라벨러가 찾은 비평 수. 보조 조건에서는 사람이 직접 쓴 비평(파랑), 모델 비평을 고친 것(초록), 모델 비평을 그대로 쓴 것(주황)으로 나눠 쌓았다.출처: Saunders et al., arXiv 2022 (CC BY 4.0)
세 출처 모두 보조를 받으면 찾은 결함이 늘어났다. 보조 조건에서 찾은 비평은 대부분 모델 비평을 그대로 가져다 쓴 것이고, 그 양만 해도 보조 없이 찾은 비평 수와 비슷하다. 전체적으로 보조를 받으면 결함을 약 50% 더 찾았다(초록, §1.2). 모델이 쓴 답만 놓고 보면, 보조 없는 라벨러는 54%의 답에서 결함을 찾고 평균 7점 척도 평점을 5.6으로 줬다. 보조를 받은 라벨러는 78%에서 결함을 찾았고 평점은 4.9였다(§3.3).
가장 눈에 띄는 숫자는 일부러 숨긴 오류의 탐지율이다. 보조 없이 27±5%였던 탐지율이 보조를 받자 45±5%로 올랐다(§3.3.1). 숨긴 오류가 100개라면 보조 없이 27개, 보조를 받으면 45개를 찾는 셈이니 18개를 더 찾은 것이다. 비율로는 약 67% 늘었다. 동시에 라벨러가 쓴 비평 중 유효한 비평의 비율은 71%와 73%로 거의 같았다(§3.3.1). 모델 비평에 휩쓸려 엉뚱한 비평을 받아들이는 부작용은 크지 않았다는 근거로 볼 수 있다.
에러바도 명확하게 정의했다. 문단 단위 부트스트래핑이나 평균의 표준오차를 z=1로 표시했다고 Figure 1 아래에 적어 뒀다. 정답 판정은 LLM-as-judge가 아니라 사람 라벨러가 했다.
ablation에 가까운 실험은 §4.3의 refinement 비교다. 비평을 보고 고치는 방식과 비평 없이 바로 고치는 방식을 비교했다. 큰 모델에서는 둘 다 원래 답보다 나아졌고, 작은 모델에서는 둘 다 효과가 거의 없었다. 비평을 거치는 쪽이 바로 고치는 쪽보다 나은 건 helpfulness score로 좋은 비평을 골라 썼을 때뿐이었다(§4.3.1).
이 논문에서 개인적으로 가장 흥미로웠던 건 §5의 GDC gap이다. 생성(G), 판별(D), 비평(C) 세 능력을 같은 win rate 축에 올려놓고 비교한다. 방식은 이렇다. 같은 모델이 한 질문에 답 두 개를 만들고, 어떤 기준으로 하나를 고른 뒤, 그 답이 아무렇게나 뽑은 답 하나를 이기는 비율을 사람이 판정한다.
아래 Fig. 2(논문 Fig. 8 상단, 요약 과제)에서 G는 고르지 않고 하나만 뽑는 기준선이라 0.5에 고정된다. D는 모델이 "흠이 있다"고 볼 확률(critiqueability score)이 낮은 쪽을 고른 경우다. C는 모델이 두 답 각각에 비평을 쓰고, 사람이 그 비평의 타당성과 심각도를 판정해 지적이 덜 심각한 쪽을 고른 경우다. 회색 점선은 사람이 직접 둘 중 하나를 고른 경우로, 참고용 상한에 가깝다. 이론상 최대는 0.75지만 라벨러가 동점을 표시해 0.6 언저리에 머문다. x축은 SFT loss라 오른쪽으로 갈수록 큰 모델이다.
핵심은 D(초록)가 C(주황)보다 모든 규모에서 위에 있다는 점이다. 모델은 어느 답이 나쁜지 알아채기는 하지만, 그 결함을 사람이 납득할 비평으로 다 말해 주지는 못한다. 그리고 이 간격(CD gap)은 모델이 커져도 줄지 않는다. 비평으로 사람의 평가를 보조하려는 입장에서는, 모델이 알면서 말하지 않는 결함이 남는다는 뜻이라 불편한 결과다. 다만 합성 태스크(Fig. 9)에서는 Addition·RACE처럼 CD gap이 음수인 경우도 있어서, 저자들도 이 간격이 태스크마다 다르다고 선을 긋는다.
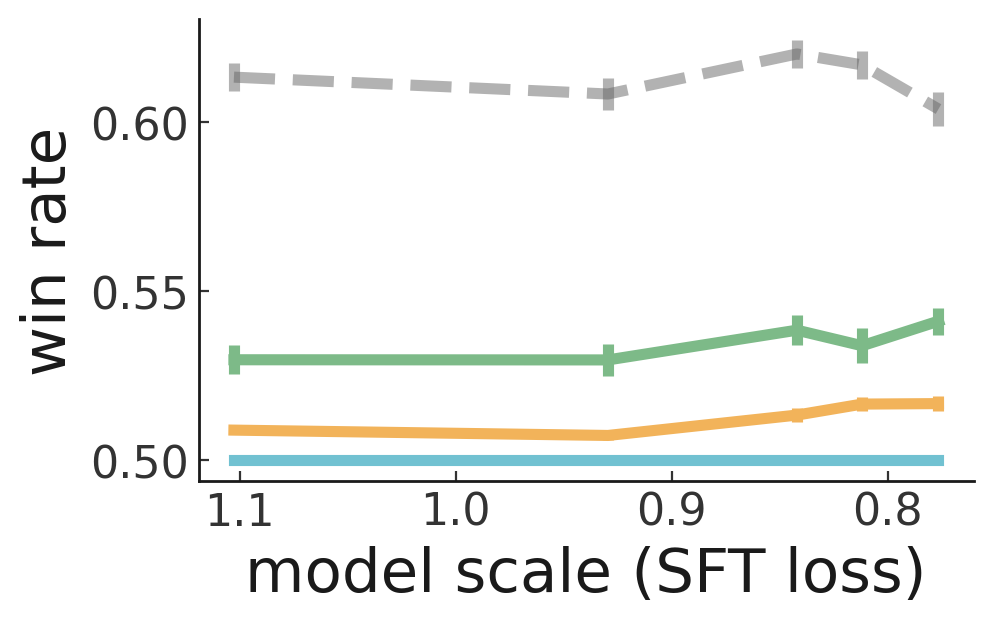
Fig. 2. 주제 기반 요약에서 사람 판단을 정답으로 잰 GDC gap. x축은 SFT loss로, 오른쪽으로 갈수록 큰 모델이다. 파랑은 G, 초록은 D, 주황은 C, 회색 점선은 사람이 고른 best-of-2.출처: Saunders et al., arXiv 2022 (CC BY 4.0)
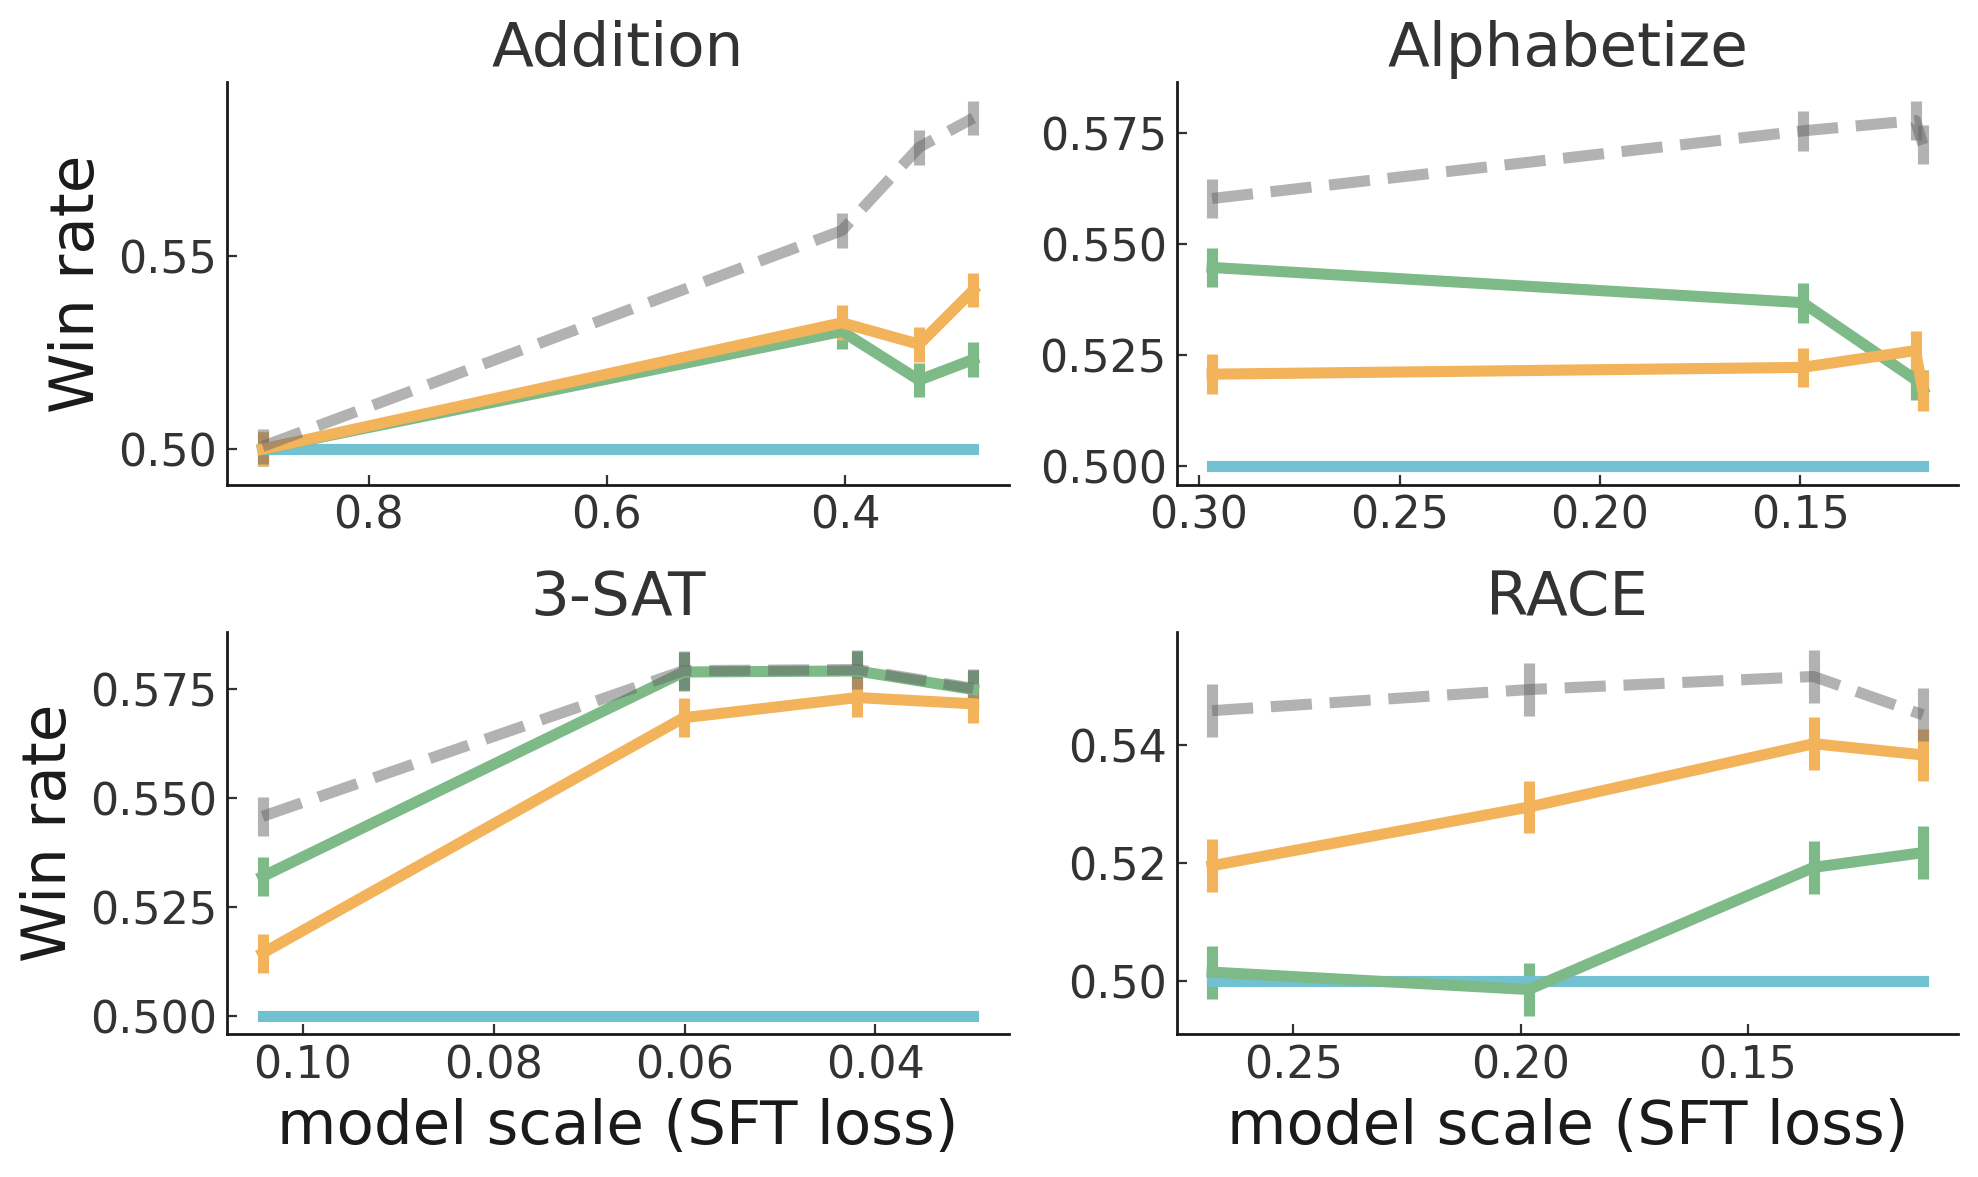
Fig. 3. 합성 과제 4개에서 hand-coded oracle을 정답으로 잰 GDC gap. 색은 Fig. 2와 같고, 회색 점선만 사람 대신 oracle이 고른 best-of-2다.출처: Saunders et al., arXiv 2022 (CC BY 4.0)
합성 과제에서는 패턴이 과제마다 다르다. 3-SAT은 요약처럼 D가 C보다 위에 있다. 반면 RACE는 모든 크기에서 C가 D보다 위에 있고, Addition도 큰 모델 쪽에서는 C가 위로 올라선다. Alphabetize는 D가 위에 있다가 가장 큰 모델에서 둘이 교차한다. 저자들도 CD gap에는 일관된 경향이 없다고 적었다(§5.3). 실패 사례를 숨기지 않고 보여준 점은 좋았다.
5. 읽으면서 든 의문
첫 번째는 GDC gap에서 쓴 두 종류의 정답이다. 합성 과제는 코드로 정답을 판정하는 oracle을 쓰고, 요약 과제는 사람 판단을 정답으로 쓴다. 두 정답의 신뢰도가 꽤 다를 텐데도 같은 지표로 나란히 제시했다. 저자들도 이 측정 방법들에 모두 결함이 있을 수 있다고 인정하지만(§5.2.1), 두 도메인 사이의 신뢰도 차이를 수치로 보여주지는 않았다. 그래서 요약에서 보인 CD gap이 합성 과제와 같은 성격의 현상인지 확신하기 어렵다.
두 번째는 계산량을 맞췄을 때의 비교다. §4.3.1에서 저자들은 계산량을 대략 맞추면 비평을 best-of-N으로 고른 refinement가 답을 새로 8개 뽑는 방식과 비슷한 수준이지만, 비평 없이 바로 고친 답을 best-of-N으로 고르는 방식이 더 강한 기준선으로 보인다고 스스로 밝힌다(Fig. 7b). 같은 계산량이면 비평을 거치는 쪽이 항상 이기지는 않는다는 얘기다. 저자들도 이 결과가 다소 noisy하다고 단서를 달았다. 비평이 유용하다는 핵심 주장에 꽤 중요한 단서인데 초록에서는 이 뉘앙스가 잘 드러나지 않는다. 이 논문에서 가장 아쉬운 부분이었다.
세 번째는 라벨 잡음이다. 라벨러 간 합의율은 비평 비교(helpfulness 순위)와 답 비교 모두 약 75%에 그쳤다(§7.2). 비교 4건 중 1건꼴로 라벨러끼리 의견이 갈린다는 뜻이고, 이 잡음은 사람 판단을 정답으로 쓰는 요약 과제의 스케일링 결과와 GDC gap에 섞여 들어간다. 그런데 이 잡음이 gap 크기의 신뢰구간에 얼마나 영향을 주는지는 계산하지 않았다.
네 번째는 과제 난이도다. 저자들도 주제 기반 요약이 사람에게 그렇게 어려운 과제는 아니라고 인정한다(§7.2). 기후 정책처럼 평가 자체가 어려운 열린 문제에서는 비평이 판별보다 쉽다는 핵심 가정부터 성립하지 않을 수 있다. 저자들도 언급은 하지만, 개인적으로는 이 한계가 생각보다 크다고 생각한다. 사람이 평가하기 어려운 과제를 돕자는 게 연구 동기인데 실험은 사람이 충분히 평가할 수 있는 과제로 했으니, 결과가 진짜 어려운 과제에서도 나올지는 아직 모른다.
마지막으로, 비평 모델의 학습 데이터와 보조 실험의 라벨러가 같은 풀에서 나왔다. 저자들도 이를 언급하지만(§3.3) 한계로 다루지는 않고, 모델로 라벨러를 더 꼼꼼하게 만드는 효과로 해석한다. 그 라벨러들 특유의 습관이 결과에 얼마나 섞였는지는 알 수 없다.
그래도 좋았던 점이 많다. Limitations 섹션(§7.2)에 한계를 7개나 구체적으로 적었다. 견고한 정답이 없다는 점, 주관적 선호가 갈리는 과제에는 안 맞을 수 있다는 점, RL 없이 SFT만 써서 InstructGPT만큼 최적화되지 않았을 수 있다는 점, 대형 모델과 대량의 사람 데이터가 필요해 재현이 어렵다는 점까지 솔직하게 썼다. 에러바 정의와 temperature 설정을 꼼꼼하게 밝힌 것도 2022년 논문치고는 드문 일이다.
6. 정리
비평이 사람의 결함 발견을 실제로 돕는다는 주장을 일부러 숨긴 오류라는 통제된 조건에서까지 보였고, 탐지율이 27%에서 45%로 오른 건 충분히 의미 있는 차이다. GDC gap이라는 측정 틀은 이후 scalable oversight 연구에서 두고두고 쓸 수 있는 도구라고 생각한다. 계산량을 맞추면 비평의 이점이 줄어든다는 점과 과제가 쉽다는 점은 분명한 약점이지만, 저자들이 그 약점을 직접 드러냈다는 점은 좋게 봤다.
이 논문에서 하나 가져간다면, 모델이 아는 것과 모델이 말해 주는 것은 다르다는 점이다. 요약 과제에서 판별 승률이 비평 승률보다 늘 높았고, 모델이 커져도 그 차이가 줄지 않았다. 앞으로는 모델이 무엇을 아는지 못지않게, 아는 것을 어떻게 말로 꺼내게 할지가 중요한 문제가 되겠다는 생각이 들었다.
7. 같이 읽어볼 논문
- Christiano et al. (2018), Supervising strong learners by amplifying weak experts. iterated amplification을 제안한 논문으로, scalable oversight 문제의식의 원류다.
- Irving et al. (2018), AI safety via debate. 이 논문이 관련 연구로 비교하는 또 다른 scalable oversight 제안이다.
- Leike et al. (2018), Scalable agent alignment via reward modeling. 서론에서 함께 인용되는 recursive reward modeling 제안이다.
- Kamoi et al. (TACL 2024), When Can LLMs Actually Correct Their Own Mistakes? A Critical Survey of Self-Correction of LLMs. 이 논문이 깔고 있는 "검증이 생성보다 쉽다"는 가정을 self-correction 연구 전반에 걸쳐 다시 따져본다.
- Bowman et al. (2022), Measuring Progress on Scalable Oversight for Large Language Models. scalable oversight를 실험으로 이어간 후속 연구다.