SELF-REFINE: Iterative Refinement with Self-Feedback
같은 LLM이 자기피드백→개선을 최대 4회 반복하는 프롬프팅만으로 7개 과제에서 평균 절대 ~20% 개선
LLM self-correction 쪽 논문을 읽다 보면 거의 빠지지 않고 인용되는 논문이 Self-Refine이다. 나중에 "Large Language Models Cannot Self-Correct Reasoning Yet"(Huang et al., ICLR 2024)이 이 논문을 직접 다시 검증하면서 비판하는데, 그 비판이 어디를 겨냥하는지 알려면 원래 논문을 먼저 봐야 할 것 같아서 읽고 정리했다. 별도 학습이나 보상 모델 없이 프롬프트만으로 모델이 자기 답을 고치게 만든다는, 아이디어만 보면 아주 단순한 논문이다.
- 저자: Aman Madaan, Niket Tandon, Prakhar Gupta 외 (CMU, Allen Institute for AI, University of Washington, NVIDIA, UC San Diego, Google Research)
- 게재: NeurIPS 2023 (arXiv:2303.17651)
- 코드·데이터·데모: selfrefine.info
0. 한 줄 요약
같은 LLM이 자기 출력에 피드백을 주고 그 피드백을 반영해 다시 고치는 과정을 최대 4번 반복하는 프롬프팅만으로, 7개 과제에서 평균 약 20%p 개선을 얻었다는 논문이다.
1. 문제 정의
LLM이 처음 내놓은 출력은 최선이 아닌 경우가 많다. 특히 대화 응답처럼 흥미롭고, 정보가 있고, 안전해야 한다는 목표를 한꺼번에 맞춰야 하는 과제나, 코드 가독성처럼 목표를 딱 잘라 정의하기 어려운 과제에서 그렇다. 사람은 초안을 쓰고 스스로 읽어 보며 고치는데, LLM도 그렇게 할 수 있지 않느냐는 것이 출발점이다.
기존에도 출력을 반복해서 고치는 연구는 있었다. 다만 대부분 도메인별 데이터로 고치는 모델을 따로 학습하거나, RLHF처럼 큰 학습셋과 비싼 사람 주석으로 만든 보상 모델을 썼다. 새 과제가 나올 때마다 이걸 다시 만들기는 어렵다. 저자들은 학습 없이 어떤 과제에나 바로 붙일 수 있는 방법을 원했다.
2. 기존 방법들의 한계
논문은 관련 연구를 Table 3에 네 가지 속성으로 정리한다. 고치는 모델에 지도 학습이 필요 없는지, 피드백에 지도 학습이 필요 없는지, 피드백이 여러 측면을 다루는지, 반복하는지다. 이 표는 이후 self-correction 논문들이 서로를 비교할 때 자주 쓰는 기준이 됐다.
첫째는 고치는 모델을 학습시키는 계열이다. PEER, Self-critique, CodeRL, Self-Correct(Welleck et al.)가 여기에 들어가고, 고치는 모델은 모두 지도 학습이 필요하고, 피드백까지 지도 학습이 필요한지는 방법마다 다르다.
둘째는 프롬프트로 고치는 계열이다. Augmenter, Re3, Reflexion 같은 방법은 학습은 피하지만, Table 3에서는 세 방법 모두 여러 측면의 피드백과 반복 칸이 비어 있다.
셋째는 고치는 과정 없이 RL로 최적화하는 계열이다. RLHF, Quark, CodeRL처럼 스칼라 보상으로 학습하는 방법인데, 모델이 중간 생성물에 대한 피드백을 직접 보지 못하고 파라미터 업데이트도 필요하다는 점에서 Self-Refine과 다르다고 저자들은 대조한다.
다만 첫째와 둘째 계열에 대한 비교는 분류표로 정리한 것이지, 직접 실험으로 비교한 건 아니다. 이 점은 감안하고 읽어야 한다.
3. 방법
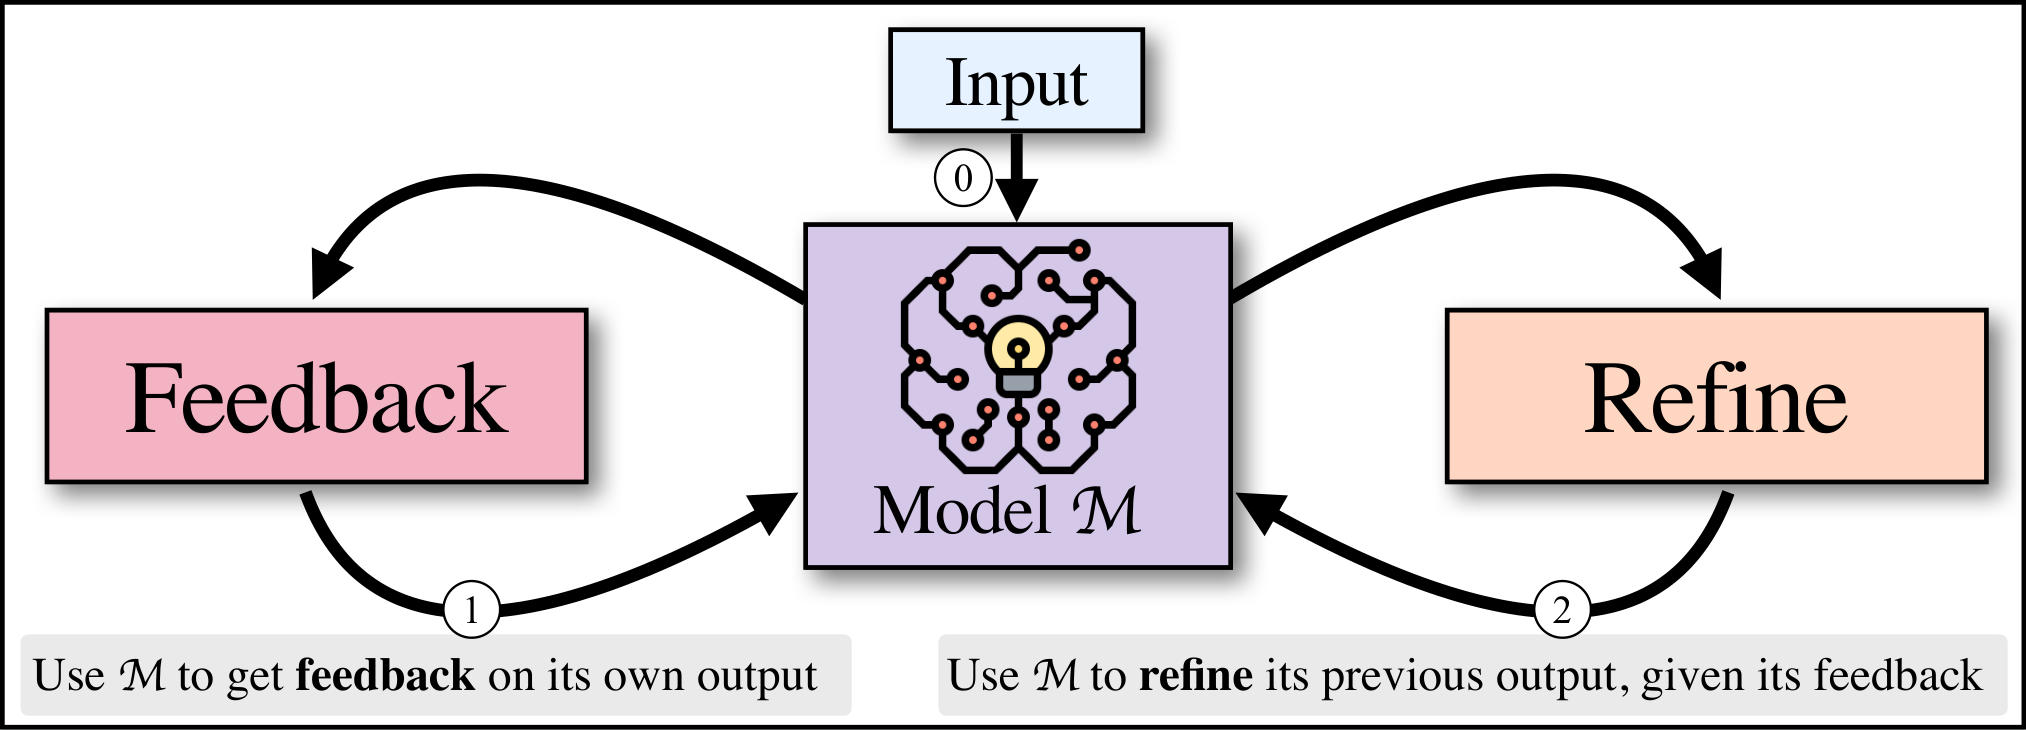
Fig. 1. Self-Refine의 전체 흐름. 입력이 들어오면 모델 M이 출력을 만들고, 같은 M이 그 출력에 피드백을 준 다음, 다시 같은 M이 피드백을 반영해 출력을 고친다. 피드백과 수정을 정지 조건이 될 때까지 반복한다.출처: Madaan et al., arXiv 2023 (CC BY 4.0)
새로운 건 하나뿐이다. 같은 LLM이 자기 출력을 스스로 비평하고, 그 비평을 근거로 스스로 고치는 2단계 루프다. 나머지는 이걸 돌리기 위한 장치다. 프롬프트는 초기 생성용 p_gen, 피드백용 p_fb, 수정용 p_refine 세 개가 있고, 모두 few-shot 예시로만 구성된다(§3.1).
절차는 이렇다(Algorithm 1). 먼저 p_gen으로 초기 출력 y0를 만든다. 그다음 같은 모델이 p_fb로 자기 출력에 피드백을 만든다. 이때 피드백은 구체적인 행동을 제안하고 고칠 표현을 콕 집어 말하도록 프롬프트에서 유도한다. 논문은 이걸 actionable하고 specific한 피드백이라고 부르고, Self-Refine이 생각하는 좋은 피드백의 기준으로 삼는다. 이후 정지 조건을 확인하고, 아니면 p_refine으로 출력을 고친다. 정지 조건은 정해진 반복 횟수(최대 4회)이거나 피드백에서 뽑아낸 정지 신호다.
수정 단계의 식(Eq. 4)이 이 방법의 특징을 잘 보여준다.
직전 출력과 피드백만 넣는 게 아니라, 지금까지의 모든 출력과 피드백을 프롬프트에 쌓아서 넣는다. 저자들은 이렇게 하면 모델이 과거 실수를 반복하지 않는다고 설명한다("allows the model to learn from past mistakes"). 그런데 이력을 넣을 때와 뺄 때를 직접 비교한 ablation은 논문에 없다. 직관적으로는 그럴듯하지만 실험으로 확인된 내용은 아니다.
이 방법이 돌아가려면 전제가 몇 가지 있다.
우선 모델이 few-shot 예시만 보고 피드백을 만들고 반영하는 두 역할을 해낼 만큼 instruction-following 능력이 있어야 한다. 저자들도 Limitations에서 이를 인정한다. 실제로 Vicuna-13B는 피드백을 정해진 형식으로 만들지 못했고, 같은 출력을 반복하거나 있지도 않은 대화를 지어냈다고 한다(§4).
다음은 정지 조건이다. 대부분 과제는 고정 횟수로 멈추지만, Math Reasoning만은 Welleck et al.(2022)을 따라 출력이 정답 라벨과 일치하면 멈춘다(Appendix O, "we use the correct label to decide when to go from one point in the loop to the next"). 정답을 보고 멈추는 건 명백한 오라클이고, 실제로 배포할 때는 쓸 수 없는 신호다. 이건 뒤에서 다시 얘기하겠다.
마지막은 평가다. Math Reasoning, Code Optimization, Constrained Generation 세 과제는 정답률이나 coverage 같은 지표로 자동 채점된다. 하지만 Dialogue, Code Readability, Sentiment Reversal, Acronym Generation 네 과제는 정답이 없어서, 사람이나 GPT-4가 두 출력 중 어느 쪽이 나은지 고르는 선호 판정에 의존한다(§3.2).
4. 실험 결과
과제는 7개다. Sentiment Reversal 리뷰 1000개, Dialogue Response Generation 대화 372개(FED), Code Optimization 프로그램 1000개(PIE), Code Readability 프로그램 300개(CodeNet), Math Reasoning 1319문항(GSM8K), Acronym Generation 250개, Constrained Generation 200개다. Constrained Generation은 CommonGen을 변형해 키워드를 35개가 아니라 2030개로 늘려 어렵게 만들었다. 모델은 GPT-3.5(text-davinci-003), ChatGPT(gpt-3.5-turbo), GPT-4를 썼고 코드 과제에는 Codex도 추가했다. 베이스라인은 같은 모델로 한 번 생성한 결과다. temperature는 0.7인데, 원문이 "greedy decoding with a temperature of 0.7"이라고 써 놓아서 무엇을 뜻하는지 조금 헷갈린다. 표기 실수로 보이지만 정확한 설정은 알 수 없다.
주 결과는 Table 1이다. 가장 크게 오른 건 GPT-4의 Dialogue Response로 25.4에서 74.6까지 49.2%p가 올랐다. Code Optimization은 27.3에서 36.0으로 8.7%p, Math Reasoning은 92.9에서 93.1로 0.2%p라 사실상 변화가 없다. 초록의 "~20% absolute"는 7개 과제와 3개 모델, 21개 셀을 평균한 값으로 보이는데, 정확히 어떻게 계산했는지는 논문에 나와 있지 않다.
숫자를 읽을 때 조심할 점이 있다. Dialogue의 +49.2%p는 정확도가 아니라 GPT-4가 Self-Refine 쪽 출력을 고른 비율이다. 사람 평가는 따로 100문항을 뽑아서 했기 때문에(Appendix M.2, Table 15) Table 1 숫자와 바로 합쳐서 볼 수 없다. Code Optimization도 본문에 test set 크기가 정확히 나와 있지 않아서 몇 문항이 더 맞았는지로 환산하기 어렵다.
평가 쪽도 짚어둘 만하다. 사람 평가는 저자들이 직접 blind A/B 판정을 했다(Appendix C). GPT-4 판정과 사람 판정의 일치율은 Sentiment Reversal 82%, Acronym Generation 68%, Dialogue 71%로, 자동 판정이 사람과 꽤 다를 수 있다는 걸 저자들이 직접 보고했다. 메인 결과는 한 번 실행한 것으로 보이고, Appendix J(Table 13)에서 Wilson 신뢰구간을 나중에 따로 계산해 붙였다. 과제별 프롬프트 전문은 Appendix S에 다 공개되어 있다.
개인적으로 이 논문에서 가장 설득력 있었던 건 Table 2의 피드백 ablation이다. Self-Refine 피드백, 일반적인 피드백, 피드백 없음 세 조건을 비교했는데, Code Optimization은 27.5, 26.0, 24.8 순이고 Acronym Generation은 56.4, 54.0, 48.0이다. Sentiment Reversal은 43.2, 31.2에 이어 피드백이 없으면 0으로 떨어진다. 구체적이고 실행 가능한 피드백이 성능을 만든다는 주장을 직접 숫자로 보여주는 결과다.
반복 횟수에 따른 변화(Figure 4)를 보면 Code Optimization은 y0 22.0에서 y3 28.8로, Sentiment Reversal은 33.9에서 36.8로, Constrained Generation은 29.0에서 49.7로 올랐다. 반복할수록 좋아지지만 한 번 더 돌릴 때마다 얻는 이득은 줄어든다.
더 많이 생성해서 이긴 게 아니냐는 반론에 대비한 실험도 있다(Appendix H). ChatGPT로 그냥 4개를 샘플링한 결과와 비교해도 Self-Refine 출력이 더 선호됐다. 샘플 수가 아니라 피드백을 반영해서 고친 것이 효과를 냈다는 걸 보이려는 실험이다.
오라클 피드백 실험(Table 9, Appendix H.1)도 흥미롭다. Math Reasoning에서 정답 여부를 피드백으로 주면 GPT-3.5는 64.06에서 68.9로 4.8%p, GPT-4는 92.9에서 93.8로 0.7%p 오른다. 오라클이 없는 본문 결과보다 뚜렷이 크다. 검증해 주는 신호가 있으면 자기 수정이 실제로 작동한다는 뜻이다. 개인적으로는 이 결과가 나중에 Huang et al.(2024)과 Tyen et al.(2024)로 이어지는 self-correction 논쟁의 초기 근거처럼 보인다.
실패 분석도 있다. Code Optimization과 Math Reasoning에서 성공 35개, 실패 35개 총 70개를 직접 분석했더니, 실패의 33%는 피드백이 오류 위치를 잘못 짚은 경우, 61%는 피드백이 엉뚱한 수정을 제안한 경우였다. 좋은 피드백을 받고도 반영을 잘못한 경우는 6%뿐이었다. 결국 병목은 고치는 쪽이 아니라 피드백 쪽이다. Math Reasoning에서 이득이 거의 없었던 이유도 같다. ChatGPT 피드백의 94%가 "everything looks good"이라고 해서 오류를 아예 찾지 못했다(§3.3).
5. 읽으면서 든 의문
첫 번째는 Math Reasoning의 오라클 정지 조건이다. Appendix O는 정답 라벨과 일치하면 루프를 멈춘다고 쓰고 있다. Table 9는 이런 설정을 "Oracle"이라고 정직하게 표시하는데, Appendix O에 실린 Figure 17(71.34%에서 76.19%로 꾸준히 오르는 그래프)에는 오라클이라는 표시가 없다. Appendix O 본문대로라면 이 그래프도 오라클 조건의 결과로 읽힌다. 그러면 본문 Table 1에서 오라클 없이 얻은 +0%p와 서로 모순되는 것처럼 보일 위험이 있다. 같은 논문 안에서 한 번은 표시하고 한 번은 안 한 셈이라, 독자가 놓치기 쉬운 부분이다.
두 번째는 평가자 독립성이다. 사람 평가를 저자들이 직접 했다는 사실은 Appendix C에만 나오고, 본문에는 그냥 "human A/B evaluation"이라고만 적혀 있다. blind 판정이었다고는 하지만 방법을 설계한 사람과 평가한 사람이 같다.
세 번째는 GPT-4가 자기 출력을 심사하는 구조다. GPT-4 베이스와 GPT-4+Self-Refine을 GPT-4로 비교하면, GPT-4가 자기가 낸 두 출력 중 하나를 고르는 꼴이 된다. LLM 심사자는 제시 순서나 출력 길이에 따라 편향이 생길 수 있는데, 순서를 무작위로 섞었는지 출력 길이를 비교했는지는 논문에 나와 있지 않다. 앞에서 본 것처럼 사람 판정과의 일치율도 68~82%에 그친다.
네 번째는 지표를 섞은 헤드라인 숫자다. Table 1의 7개 과제 중 Dialogue, Sentiment Reversal, Acronym 셋은 선호 비율이고 나머지는 정확도나 coverage 같은 절대 지표다. 그런데 초록은 이걸 구분하지 않고 "~20% absolute" 하나로 뭉뚱그린다. 가장 화려한 수치인 Dialogue의 25.4에서 74.6도 정확도가 아니라 선호 비율이다. 이 논문에서 가장 아쉬운 부분이었다.
다섯 번째는 빠진 대조군이다. 평가 기준을 처음부터 초기 생성 프롬프트에 적어 주는 가장 값싼 비교가 없다. 그래서 개선이 피드백과 수정을 반복하는 루프 덕분인지, 단지 나중에라도 평가 기준을 모델에게 알려준 덕분인지 구분할 수 없다. 또 Table 8을 보면 PIE의 few-shot 베이스라인(BEST@32)이 38.3으로 Self-Refine GPT-4의 36.0보다 높은데, 본문에서 이 역전을 다루지 않는다.
그래도 좋은 점도 분명하다. Acronym Generation이나 어렵게 바꾼 Constrained Generation처럼 데이터셋을 새로 만들었는데, 개인적으로는 이것이 벤치마크 오염 위험을 줄이는 효과도 있었다고 본다. 과제별 프롬프트 전문과 코드, 데이터도 모두 공개했다. 실패 원인을 직접 세서 보고한 것도 좋았다.
6. 정리
이 논문의 핵심 근거는 Table 2의 세 조건 비교다. 구체적인 피드백, 일반적인 피드백, 피드백 없음을 나란히 놓아서 피드백이 구체적일수록 성능이 오른다는 걸 직접 보였고, Sentiment Reversal에서 피드백이 없으면 0으로 떨어지는 결과는 특히 강했다. 성격이 다른 7개 과제와 3개 모델에서 실험한 것도 탄탄하다.
반면 Math Reasoning의 오라클 정지 조건이 표와 그림에서 다르게 표시되어 있고, 사람 평가는 저자가, 자동 평가는 GPT-4가 자기 출력을 심사하는 구조라는 문제가 함께 있다. 그래서 초록의 "20% 개선"이라는 숫자는 그대로 받아들이기 어렵다고 생각한다.
이 논문에서 하나 가져간다면, 자기 수정이 잘 되는지는 결국 피드백이 오류를 제대로 찾느냐에 달려 있다는 점이다. 실패의 94%가 피드백 단계에서 생겼고, 정답 여부라는 외부 신호를 주자 Math Reasoning 성능이 비로소 올랐다. 나중에 Huang et al.이 "오라클을 빼면 이득이 사라진다"고 비판한 것도 바로 이 지점이다.
7. 같이 읽어볼 논문
- Ouyang et al. (NeurIPS 2022), Training language models to follow instructions with human feedback. Self-Refine이 피하려는 비싼 대안으로 서론과 관련 연구에서 직접 대조하는 RLHF 논문이다.
- Welleck et al. (ICLR 2023), Generating Sequences by Learning to Self-Correct. Table 3의 학습된 고치는 모델 계열을 대표하는 논문이고, Math Reasoning의 오라클 정지 조건도 여기서 가져왔다.
- Cobbe et al. (2021), Training Verifiers to Solve Math Word Problems. Math Reasoning 실험에 쓴 GSM8K의 원 논문이다.
- Shinn et al. (NeurIPS 2023), Reflexion. Table 3에서 프롬프트 기반 계열로 비교되는, 비슷한 시기의 자기 반성 방법이다.
- Kim et al. (NeurIPS 2023), Language Models can Solve Computer Tasks. RCI라는 비슷한 자기 비평 루프를 컴퓨터 작업에 적용한 논문이다.
- Huang et al. (ICLR 2024), Large Language Models Cannot Self-Correct Reasoning Yet. GSM8K 같은 추론 과제에서 오라클을 빼면 Self-Refine류의 이득이 사라지고, CommonGen-Hard에서는 처음부터 프롬프트를 잘 쓰면 여러 번 고친 결과보다 낫다는 점을 보이며 비판한다.