Detecting hallucinations in large language models using semantic entropy
여러 답을 양방향 함의로 의미 클러스터에 묶어 엔트로피를 재면, 모델이 그때그때 다른 말을 지어내는(작화) 질문을 라벨 없이 찾을 수 있다.
Oxford OATML 그룹이 2024년 Nature에 낸 semantic entropy 논문을 읽고 정리했다. LLM hallucination detection 쪽을 공부하다 보면 계속 인용되는 논문이라 한 번 제대로 보고 싶었다. ICLR 2023에 나온 "Semantic Uncertainty"(Kuhn, Gal, Farquhar)가 전신이고, Nature 버전에서는 문장·문단 길이 답변까지 실험을 넓히고 함의 판정에 GPT-3.5 같은 LLM을 쓰는 등 범위가 꽤 커졌다. 다만 Nature 논문의 참고문헌에는 이 ICLR 논문이 들어 있지 않다.
- 저자: Sebastian Farquhar, Jannik Kossen, Lorenz Kuhn (공동 1저자), Yarin Gal
- 게재: Nature 630, 625–630 (2024)
- 코드: jlko/semantic_uncertainty, jlko/long_hallucinations
0. 한 줄 요약
같은 질문에 여러 번 답하게 하고, 답들을 의미가 같은 것끼리 묶은 다음 엔트로피를 재면 모델이 그때그때 말을 지어내는 질문을 라벨 없이 찾아낼 수 있다는 논문이다.
1. 문제 정의
논문 서론에 나오는 예시가 직관적이다. "Sotorasib의 표적은?"이라고 물으면 LLM은 같은 프롬프트에도 어떤 때는 KRAS G12C(정답), 어떤 때는 G12D(오답)라고 둘 다 그럴듯하게 답한다. 사용자는 답 하나만 보니까 이게 동전 던지기 결과인지 알 방법이 없다. LLM을 써 봤다면 같은 질문을 다시 했을 때 답이 바뀌는 걸 한 번쯤 겪어 봤을 텐데, 딱 그 상황이다.
저자들은 이렇게 틀렸으면서 샘플링할 때마다 바뀌는 답을 confabulation이라고 부르고, hallucination 중에서도 이 유형만 겨냥한다. 같은 오답을 일관되게 내는 경우는 처음부터 범위 밖이다. 이 점을 알고 읽어야 뒤의 결과를 제대로 해석할 수 있다.
그럼 출력 분포의 엔트로피를 재면 되지 않나 싶은데, 토큰 수준 엔트로피는 "Paris", "It's Paris", "France's capital Paris"를 전부 다른 답으로 센다. 그래서 정답을 확신하는 모델도 표현만 다양하면 엔트로피가 높게 나온다. 분류 문제에 쓰던 불확실성 추정 기법들은 정해진 선택지 중에 고르는 상황을 가정하는데, LLM은 대부분 자유롭게 문장으로 답한다는 것도 문제다.
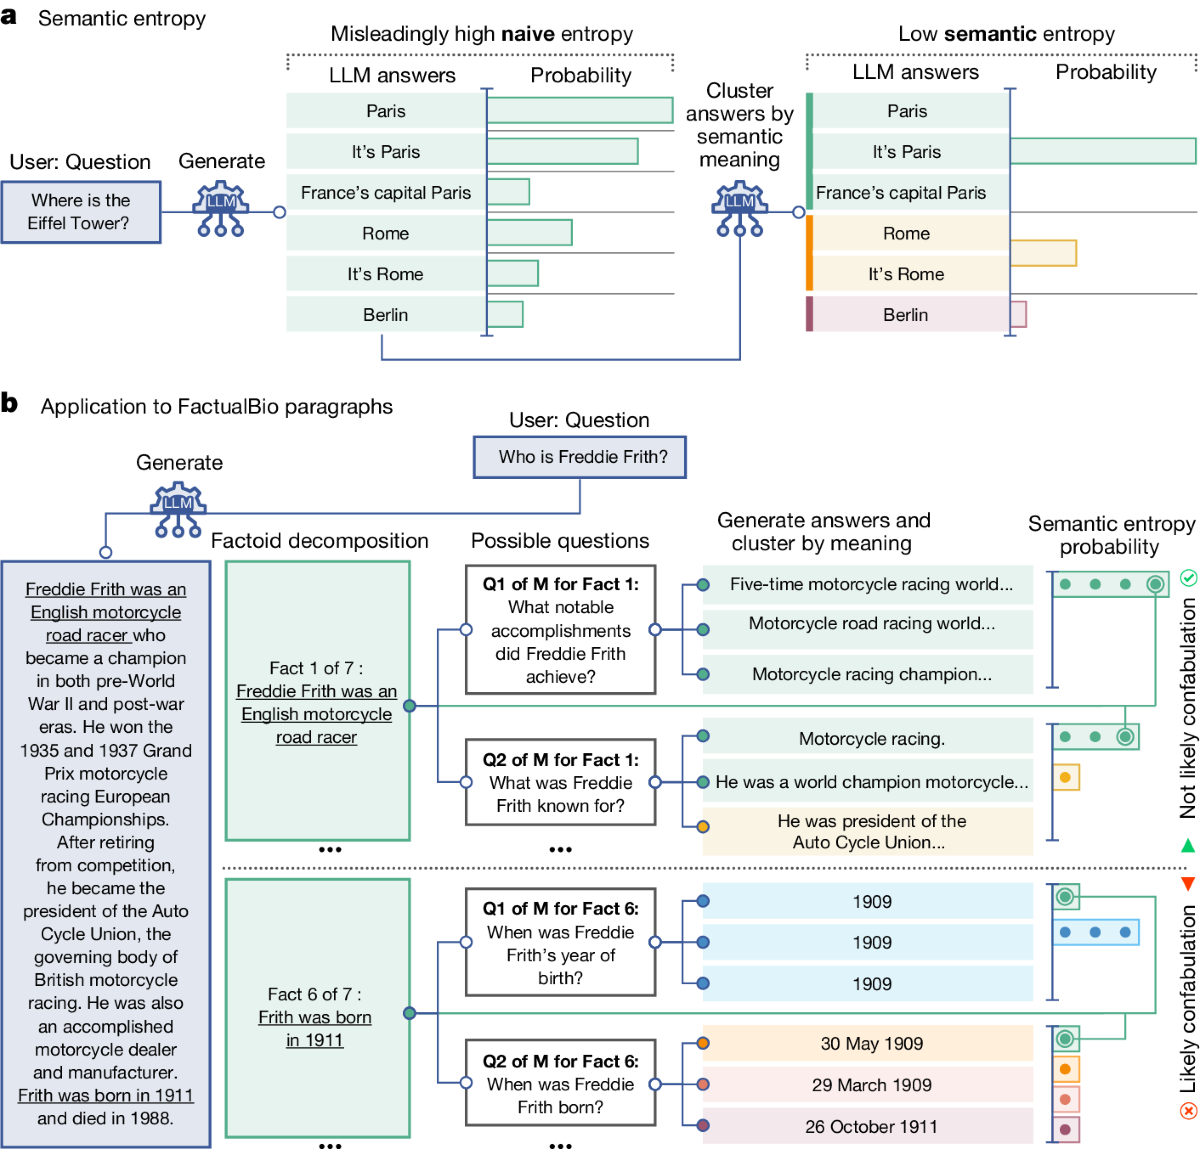
Fig. 1. (a) "Where is the Eiffel Tower?"에 대한 답들을 토큰 단위로 보면 naive entropy가 높게 나오지만, 의미로 묶으면 Paris 클러스터에 확률이 몰려 semantic entropy는 낮다.
(b) 문단 길이 답변은 사실 단위로 쪼개서 같은 방식을 적용한다.출처: Farquhar et al., Nature 2024 (CC BY 4.0)
2. 기존 방법들의 한계
논문이 비교하는 기존 접근은 크게 세 갈래다.
첫째는 토큰 단위로 계산하는 naive entropy다. 앞에서 말한 것처럼 표현의 다양성과 의미의 불확실성을 섞어서 잰다. 논문 실험에서도 AUROC가 0.691로, semantic entropy의 0.790과 차이가 난다.
둘째는 embedding regression처럼 정답 라벨로 탐지기를 학습시키는 방식이다. 라벨이 필요하고, 학습 때와 분포가 달라지면 성능이 떨어진다.
셋째는 P(True)처럼 모델에게 직접 맞았는지 묻는 방식이다. 샘플한 답들을 같이 보여 주고 대표 답이 True인지 묻는데, 프롬프트에 정답 여부가 표시된 학습셋 예시를 최대 20개까지 넣는다. 그래서 저자들은 이를 in-context로 지도 학습한 방법으로 분류한다. 결국 모델의 자기 평가 능력에 기대게 되고, 저자들도 인정하듯 P(True)는 모델이 클수록 좋아진다.
조금 아쉬웠던 건 접근 방식이 가장 비슷한 SelfCheckGPT를 인용만 하고 본문 비교 실험에는 넣지 않았다는 점이다. 그나마 인용된 곳도 GPT-4가 출력 확률을 주지 않는다는 대목이다. 이건 뒤에서 다시 얘기하겠다.
3. 방법
아이디어 자체는 단순하다. 엔트로피를 토큰 시퀀스가 아니라 의미 클러스터 위에서 계산하는 것이다. 샘플링, 길이 정규화, 이산 근사, 문단 분해 같은 나머지 장치는 이걸 실제로 돌리기 위한 부품이라고 보면 된다.
절차는 이렇다. 먼저 질문 하나에 답을 10개 샘플링한다(temperature 1, top-p 0.9, top-k 50). 정답 여부를 평가할 대표 답은 따로 temperature 0.1로 하나 뽑는다. 그다음 두 답이 서로를 함의하면, 즉 A가 B를 함의하고 B도 A를 함의하면 같은 의미로 보고 같은 클러스터에 넣는다. 함의 판정에는 GPT-3.5와 DeBERTa-large-MNLI를 모두 검토했고, 문장 길이 실험에서는 사람 판정과 잘 맞는 GPT-3.5를 최종으로 골랐다. 문단 길이 실험에서는 DeBERTa를 쓴다. 마지막으로 클러스터별 확률을 합쳐 엔트로피를 계산하고, 이 값이 높으면 confabulation일 가능성이 높다고 판단한다.
수식으로 보면 핵심은 Eq. 2다.
같은 뜻인 답들의 확률을 하나로 합치는 식이다. 이렇게 합치지 않으면 "Paris"와 "It's Paris"가 따로 세어져 엔트로피가 괜히 커지는데, naive entropy가 틀리는 이유가 바로 이거다. 실제 추정은 관측된 클러스터만 가지고 하고(Eq. 5), 클러스터 확률은 합이 1이 되도록 다시 정규화한다. 길이로 정규화한 확률은 다 더하면 1을 넘을 수 있어서, 이 과정을 빼면 값이 제대로 나오지 않는다.
개인적으로 흥미로웠던 건 discrete semantic entropy다. 토큰 확률 대신 각 클러스터에 들어간 샘플 수의 비율을 쓰는 버전이라, 출력 확률을 주지 않는 GPT-4 같은 블랙박스 모델에도 쓸 수 있다. 읽다 보니 Self-Consistency의 다수결과 구조가 거의 같다는 생각이 들었다. "답이 같다"를 판단하는 기준을 문자열 일치에서 의미 함의로 바꾼 셈이다.
클러스터링은 새 샘플을 각 클러스터의 첫 번째 원소하고만 비교한다(Extended Data Fig. 1). A와 B가 같은 뜻이고 B와 C가 같은 뜻이면 A와 C도 같은 뜻이라고 가정한 것이다.
문단 길이 답변(FactualBio)에는 분해를 쓴다. Fig. 1b처럼 문단을 사실 주장 단위로 쪼개고, 주장마다 질문을 6개 만들고, 질문마다 답을 3개 생성한 다음 원래 주장까지 넣어서 discrete semantic entropy를 구하고, 질문별 값을 평균한다. GPT-4의 답 중 절반 넘게 'not available', 'unknown' 같은 거부 문구가 들어 있으면 불확실성을 최대로 처리하는 수작업 규칙도 들어가 있다.
실제로 쓰려면 짚어볼 전제도 몇 가지 있다. 우선 비용이다. 답 하나 대신 10개를 생성하니 생성 비용만 대략 10배이고, 여기에 답 쌍마다 함의 판정 호출이 더 붙는다. 계산 비용은 보충자료(Supplementary Note 3)에서 따로 다룬다. 그리고 앞에서 말했듯 임의적인 오류만 잡히고, 모델이 같은 오답을 일관되게 내면 semantic entropy는 낮게 나온다. 거부 임계값 문제도 있다. AURAC는 임계값 전체를 적분한 값이라 실제로 어느 값에서 답변을 거부할지는 정해주지 않는다. 현실에서는 결국 라벨 있는 보정 데이터가 필요할 것 같다.
4. 실험 결과
데이터셋은 TriviaQA, SQuAD 1.1, BioASQ, NQ-Open, SVAMP이고 각각 400문항을 뽑아 테스트했다. 모델은 LLaMA 2 Chat(7B/13B/70B), Falcon Instruct(7B/40B), Mistral Instruct 7B를 썼다. 정답 판정은 GPT-4가 참조 답과 비교하는 LLM-as-judge 방식이다. GPT-4 판정을 사람 판정과 비교한 결과는 보충자료(Supplementary Note 6)에 있다.
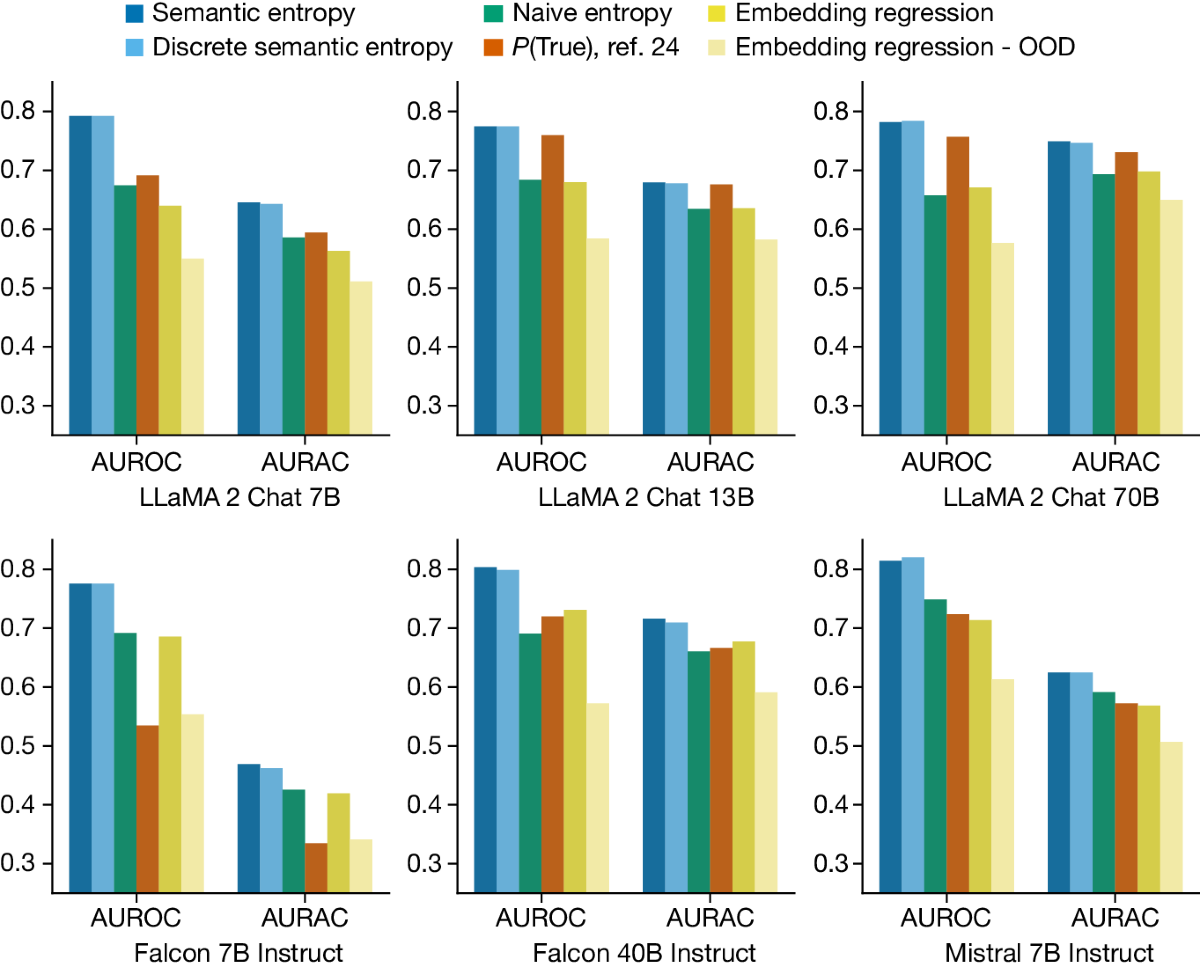
Fig. 2. 모델별 AUROC와 AURAC. 파란색 두 막대가 semantic entropy와 discrete semantic entropy다.출처: Farquhar et al., Nature 2024 (CC BY 4.0)
30개 조합(데이터셋 × 모델)의 평균 AUROC는 semantic entropy가 0.790으로 가장 높았고, P(True) 0.698, naive entropy 0.691, embedding regression 0.687 순이었다. 모델별로 봐도 0.78–0.81 사이라 꽤 안정적이다. 그래프에서 연한 노란 막대가 OOD 데이터, 즉 학습 때와 다른 데이터셋에서 잰 embedding regression인데, 지도 학습 탐지기는 데이터가 바뀌면 확실히 성능이 떨어진다.
숫자만으로는 감이 잘 안 와서 풀어서 생각해 봤다. AUROC는 정답 하나와 오답 하나를 무작위로 골랐을 때 정답 쪽 점수가 더 높게 나올 확률이다. 그러니 순서를 잘못 매기는 비율이 31%(naive entropy)에서 21%(semantic entropy)로, 대략 3분의 1 줄어든 것이다.
naive entropy와 semantic entropy의 비교는 사실상 "의미 클러스터링을 뺀" ablation이고 차이는 약 0.10이다. 또 discrete 버전이 원래 버전과 성능이 거의 같다는 건, 성능이 토큰 확률이 아니라 클러스터링에서 나온다는 뜻으로 읽었다.
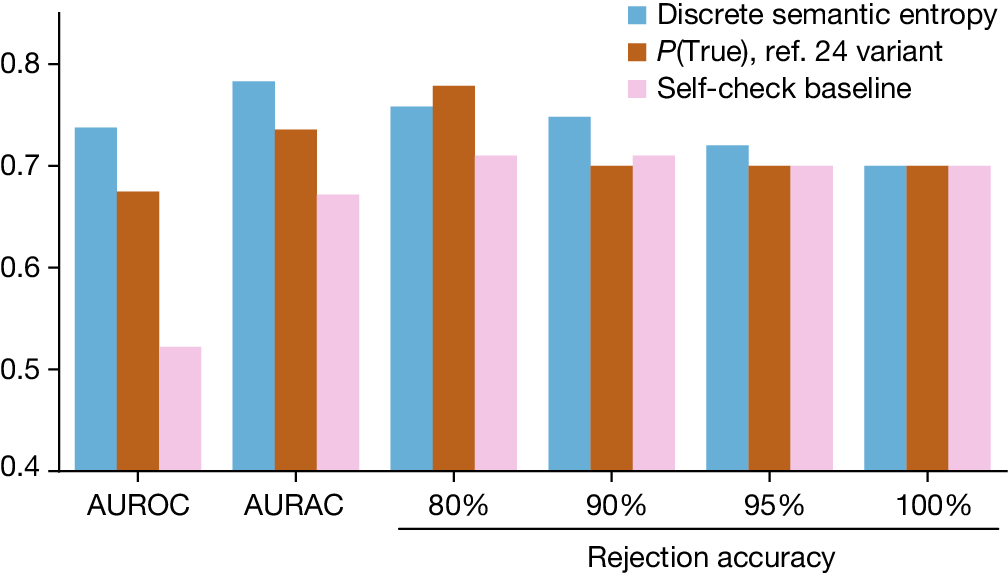
Fig. 3. GPT-4가 생성한 인물 전기(FactualBio)에서의 결과.출처: Farquhar et al., Nature 2024 (CC BY 4.0)
FactualBio에서는 21명의 전기에서 뽑은 주장 150개(그중 오답 45개)를 대상으로, discrete semantic entropy가 AUROC와 AURAC 모두 베이스라인보다 높았다. 그림에서 읽으면 AUROC는 discrete semantic entropy가 0.74 안팎, P(True) 변형이 0.68 안팎, self-check가 0.52 안팎이다. 다만 정확한 값은 막대그래프로만 나와 있고, 상위 80%만 답하는(20%를 거부하는) 지점에서는 P(True)가 근소하게 앞선다.
실패 사례를 본문 표에 넣은 점은 좋았다(Table 1, 4행). BSkyB 출시일을 묻는 질문에서 "1998년"과 "1998년 10월 1일"을 다른 클러스터로 나눠 버려서, 모델이 사실은 맞게 알고 있는데도 불확실하다고 판정한 경우다. 클러스터를 너무 잘게 나누면 이런 일이 생긴다.
5. 읽으면서 든 의문
첫 번째는 평가 범위다. 제목만 보면 hallucination 전체를 다루는 것 같지만, 초록과 본문은 confabulation이라는 일부로 범위를 분명히 밝힌다. 그리고 실제 평가는 지문 없이 한 문장(평균 96자)으로 답하는 QA와 수학 문장제, 그리고 GPT-4 전기 문단에서의 confabulation 탐지다. 저자들은 지문을 주면 정확도가 너무 높아져서 confabulation을 연구하기 어렵다는 이유로 지문을 뺐는데, 그 결과 SQuAD마저 지문 없는 상식 퀴즈가 됐다. 내 생각에 RAG에서 흔한 오류는 잘못 검색된 문서를 일관되게 따라가는 형태인데, 이건 semantic entropy가 원리상 놓치는 유형이다. 그래서 RAG 환경에서도 같은 성능이 나올지는 이 논문만으로는 알 수 없다.
두 번째는 비교 대상이다. semantic entropy는 질문당 샘플 10개를 쓴다. 그런데 본문에서는 같은 10개로 계산할 수 있는 SelfCheckGPT, 단순 다수결 비율, 문자열이나 임베딩 기반 군집 엔트로피와 비교하지 않았다. naive entropy도 같은 샘플을 쓰지만 답끼리 일치하는지는 보지 않는다. 그래서 naive entropy보다 0.10 높게 나온 게 의미 함의 판정 덕분인지, 그냥 샘플 여러 개가 서로 일치하는지 봤기 때문인지 구분할 수가 없다. 이 논문에서 가장 아쉬운 부분이었다.
세 번째는 결과 보고 방식이다. 본문에는 30개 조합의 평균만 있고, 데이터셋별 수치나 가장 나빴던 조합은 보충자료로 넘어갔다. 저자들은 신뢰구간 대신 데이터셋 간 상대 순위가 일관된지가 더 나은 지표라고 주장하는데(Fig. 2를 설명하는 부분), 그렇다면 그 일관성을 본문에서 보여줬어야 하지 않나 싶다.
네 번째는 FactualBio의 표본 크기다. 문단 길이 실험은 21명, 주장 150개(오답 45개)가 전부이고, 같은 인물에 대한 주장끼리는 서로 독립도 아니다. AUROC가 0.7대라고 두고 Hanley–McNeil 근사로 대충 계산해 보면 95% 신뢰구간이 ±0.09 정도 나온다. self-check 베이스라인과의 차이는 꽤 커 보이긴 하지만, 그림에서 읽은 P(True)와의 차이(0.06 안팎)는 이 범위 안에 들어간다. 문단 길이에서도 작동한다고 말하기엔 데이터가 적다.
마지막으로 "비지도"라는 표현이 조금 과장이라고 느꼈다. 방법 자체에 라벨이 필요 없는 건 맞다. 하지만 문단 실험에서 DeBERTa를 고른 이유가 학습셋 AUROC가 더 높아서였고, 샘플 수도 실험을 보고 정했다. 어떤 판정기를 쓸지, 샘플을 몇 개 뽑을지 정하는 데는 라벨을 쓴 셈이다. 그렇다고 결론이 흔들릴 정도는 아니다.
그래도 좋았던 점이 많다. 지도 학습 베이스라인이 분포 이동에서 무너지는 걸 직접 실험으로 보였고, 실패 사례를 숨기지 않았고, 코드와 데이터, 프롬프트를 전부 공개했다. 재현해 보기 좋은 논문이다.
6. 정리
라벨을 전혀 쓰지 않는 지표 하나가 같은 분포에서도, 분포가 바뀐 조건에서도 라벨로 학습한 탐지기를 이겼고, 모델 계열 세 개와 7B~70B 크기 모두에서 0.78–0.81을 유지했다. 평가 범위가 좁고 같은 샘플을 쓰는 비교 방법이 빠진 건 분명한 약점이다. 다만 그건 이 논문이 주장할 수 있는 범위가 줄어드는 정도고, 불확실성을 의미 단위로 재자는 아이디어 자체가 틀렸다는 뜻은 아니다.
이 논문에서 하나 가져간다면, 불확실성을 잴 때는 무엇에 대한 불확실성인지부터 정해야 한다는 점이다. 표현의 불확실성과 의미의 불확실성을 분리한 것만으로 AUROC가 0.10 올랐다. hallucination도 원인별로 나눠서 봐야 제대로 측정할 수 있겠다는 생각이 들었다.
7. 같이 읽어볼 논문
- Kuhn, Gal, Farquhar (ICLR 2023), Semantic Uncertainty: Linguistic Invariances for Uncertainty Estimation in Natural Language Generation. 이 논문의 원형이라 Nature 버전에서 뭐가 확장됐는지 비교하기 좋다.
- Kadavath et al. (2022), Language Models (Mostly) Know What They Know. 베이스라인으로 쓰인 P(True)의 출처다.
- Manakul et al. (EMNLP 2023), SelfCheckGPT. 샘플 일관성 기반 블랙박스 hallucination detection으로, 이 논문이 비교하지 않은 가장 가까운 경쟁자다.
- Kossen et al. (2024), Semantic Entropy Probes. semantic entropy가 생성 한 번의 hidden state에 이미 담겨 있어서 linear probe로 뽑아낼 수 있다는 후속 연구다. 샘플링 비용 문제를 바로 겨냥한 논문이다.
- Nikitin et al. (NeurIPS 2024), Kernel Language Entropy. 답을 클러스터로 딱 자르지 않고, 의미가 얼마나 비슷한지를 연속적인 값으로 다룬다.