The Illusion of Progress: Re-evaluating Hallucination Detection in LLMs
QA 환각 탐지기는 ROUGE 라벨 위에서 실제보다 좋아 보였고, 사람에 가까운 LLM 판정으로 바꾸면 크게 떨어지며 응답 길이만으로도 상당 부분 따라잡힌다
비지도 hallucination detection 논문들이 보고해 온 AUROC가 실제로 믿을 만한지 따져 보는 논문이다. 새로운 탐지기를 내세우는 논문은 아니다. 저자들이 가져온 eRank와 길이 기준선도 있지만, 중심은 기존 방법들의 라벨만 ROUGE에서 LLM 판정으로 바꿔 다시 채점하는 것이다. 이 분야에서 써 온 "ROUGE-L 0.3 미만이면 hallucination" 관행을 정면으로 다루는데, 저자들은 이 기준의 근거로 Semantic entropy 논문(Farquhar et al., Nature 2024)을 든다. 그 논문을 읽은 사람이라면 이어서 보기 좋다.
- 저자: Denis Janiak, Jakub Binkowski, Albert Sawczyn, Bogdan Gabrys, Ravid Shwartz-Ziv, Tomasz Kajdanowicz (Wroclaw University of Science and Technology, University of Technology Sydney, NYU)
- 게재: EMNLP 2025 main (pp. 34728–34745), arXiv 2508.08285
- 코드: 논문에 공개 링크가 없다
0. 한 줄 요약
QA hallucination 탐지기들은 ROUGE 라벨로 채점했을 때 실제보다 좋아 보였다. 사람 판단에 더 가까운 LLM 판정으로 바꾸면 성능이 크게 떨어지고, 응답 길이 하나만 써도 상당 부분 따라잡힌다는 논문이다.
1. 문제 정의
hallucination 탐지기는 답마다 점수를 매기고, 그 점수가 정답과 오답을 얼마나 잘 가르는지 AUROC로 평가한다. 그러려면 답마다 맞았는지 틀렸는지 라벨이 있어야 하는데, 이 분야에서는 참조 답과의 ROUGE-L F1이 0.3 미만이면 hallucination으로 보는 방식을 많이 써 왔다. 저자들은 ROUGE가 QA의 사실 정확성을 판정하는 데 적합한지는 제대로 검증된 적 없이 그냥 가정되어 왔다고 지적한다.
부록 G의 예시를 보면 문제가 바로 보인다. "Pride and Prejudice는 언제 쓰였나?"에 "Pride and Prejudice was written by Jane Austen and published in 1813."이라고 답하면, 정답 "1813"과 겹치는 부분이 전체 답에 비해 짧아서 ROUGE는 이 답을 hallucination으로 처리한다. 저자들에 따르면 ROUGE가 가장 자주 저지르는 오류가 바로 이렇게 맞는 답을 길다는 이유로 틀렸다고 보는 경우다. "지형도가 보여주는 요소 하나는?"에 정답 "Relief" 대신 "Elevation"이라고 답한 것처럼, 뜻은 같은데 단어가 다른 경우도 틀린 답이 된다. 반대 방향 오류도 있다. "Grey's Anatomy 시즌 14는 몇 화인가?"에 "23 episodes."라고 답하면 정답 "24 episodes."와 단어가 거의 겹쳐서 맞은 답으로 처리된다.
규모로 보면 더 심각하다. Mistral zero-shot NQ-Open에서 정답률이 ROUGE 기준으로는 7.8%인데 LLM 판정 기준으로는 39.0%다(부록 Table 13). 이 설정에서는 탐지기 AUROC가 이 정도로 어긋난 라벨 위에서 계산된다는 뜻이다.
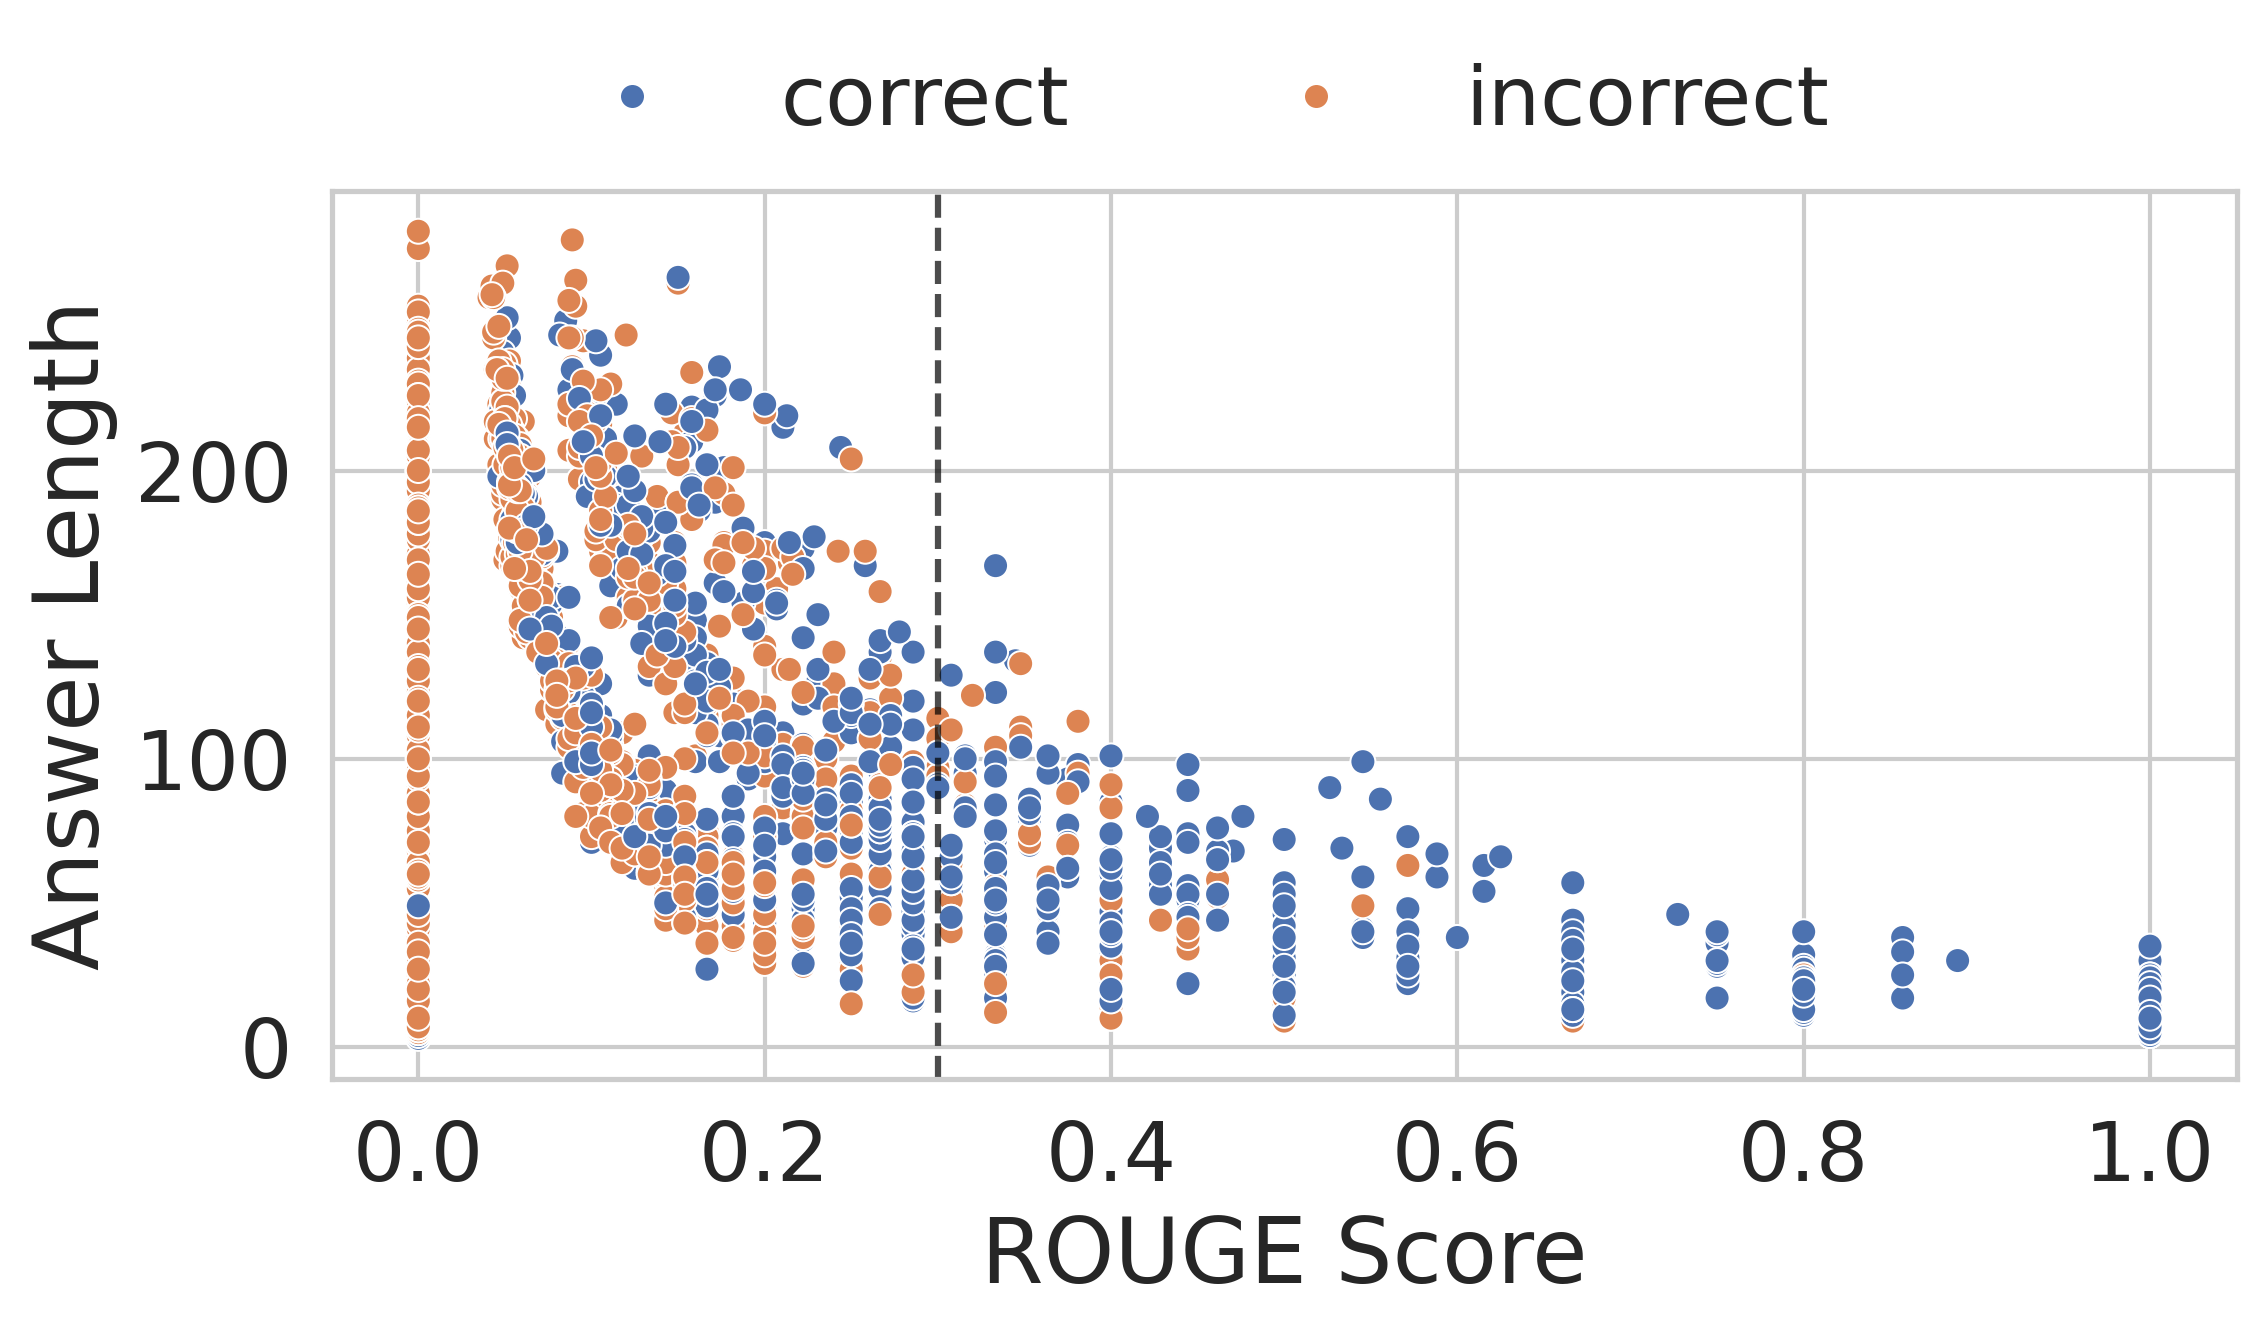
Fig. 1. Mistral few-shot 설정에서 답 길이와 ROUGE 점수의 분포. 답이 길어질수록 ROUGE가 낮아지고, 100 토큰을 넘는 답은 사실 여부와 상관없이 0.3 임계값 아래로 떨어진다. (논문 Figure 5)출처: Janiak et al., EMNLP 2025 (CC BY 4.0)
2. 기존 방법들의 한계
논문이 다시 채점하는 탐지기는 두 부류다. 하나는 불확실성 기반 방법으로 Perplexity, LN-Entropy, Semantic Entropy가 여기에 들어간다. 다른 하나는 hidden state를 분석하는 방법으로 EigenScore, LogDet, 그리고 저자들이 새로 가져온 eRank가 있다. 저자들의 주장은 두 부류 모두 ROUGE 라벨 위에서 과대평가되는 경우가 많다는 것이고(다만 Llama에서는 Perplexity와 Semantic Entropy가 거의 그대로이고, LN-Entropy는 오히려 오른다), 그중 EigenScore와 eRank는 응답 길이와 상관이 특히 강하다는 것이다.
평가 지표 쪽에서는 ROUGE만 문제가 아니라고 말한다. BLEU, BERTScore, SummaC, UniEval도 LLM 판정과 비교해 보면 잘 맞지 않는다(Table 4). 표를 자세히 보면 zero-shot에서 LLM 판정 라벨과의 AUROC가 가장 높은 지표는 오히려 ROUGE다(Llama 0.878, Mistral 0.825). 대안 지표들도 나을 게 없다는 정도로 읽는 게 맞을 것 같다.
§5.2에서 저자들은 Mistral 모델의 방법·데이터셋별 AUROC를 그린 Figure 3에서 ROUGE 기준과 LLM 기준 AUROC의 상관이 r = 0.55에 그친다는 결과를 근거로, 탐지기들이 의도치 않게 ROUGE의 어휘 겹침 기준에 맞춰 최적화되었을 수 있다고 쓴다. 개인적으로는 상관계수 하나로 끌어내기에는 근거가 약한 추측이라고 생각한다.
3. 방법
핵심은 평가 라벨을 사람 판단으로 검증한 LLM 판정으로 바꿔서 기존 탐지기를 다시 채점하는 것이다. 저자들은 응답 길이가 의외로 강한 hallucination 신호라는 점을 세 번째 기여로 따로 내세우지만, 개인적으로는 길이 기준선과 §6.4의 실험들이 재채점에서 드러난 차이를 길이로 설명해 보려는 보조 장치에 가깝다고 읽었다.
질문 하나마다 temperature 0.1로 "최선 답"을 하나 만들고, 이 답이 평가 대상이 된다. 따로 temperature 1.0으로 샘플 10개를 만들어 Semantic Entropy처럼 여러 샘플이 필요한 점수를 계산한다. 프롬프트는 "가능한 한 짧게 답하라"는 지시를 쓰고, 예시 없는 zero-shot과 예시 5개를 넣은 few-shot 두 가지로 돌린다.
라벨은 두 가지다. 하나는 기존 관행대로 ROUGE-L F1 0.3을 기준으로 나누는 것이고, 다른 하나는 GPT-4o-mini가 질문, 참조 답, 모델 답을 보고 correct, incorrect, refuse 중 하나로 분류하는 것이다. refuse, 즉 모델이 답을 거부한 경우는 hallucination으로 친다(§3.4). 같은 탐지기 점수를 두 라벨로 각각 채점해서 AUROC와 PR-AUC를 비교한다.
탐지기 중 eRank는 hidden state 공분산 행렬의 고유값이 얼마나 고르게 퍼져 있는지를 재는 유효 차원이다(부록 F.1).
저자들은 eRank가 ROUGE 기준에서는 좋아 보였지만 LLM 판정 기준으로는 일관되게 작동하지 않았다고 부록에 직접 적었다. 자기들이 가져온 방법의 실패를 ROUGE가 연구 방향을 잘못 이끄는 사례로 소개한 셈인데, 이 부분은 솔직해서 좋았다.
여기에 길이 기준선 세 개를 더한다. 생성 하나의 길이(Len), 여러 샘플의 평균 길이(Mean-Len), 샘플 길이의 표준편차(Std-Len)다(§6.3).
데이터는 NQ-Open 3,610개, TriviaQA 3,842개, SQuAD 4,150개(지문 없는 rc.nocontext)이고, 모델은 Llama-3.1-8B-Instruct와 Mistral-7B-Instruct-v0.3이다. 실행은 한 번만 했다(§3.6).
Δ%를 읽을 때는 주의가 필요하다. 논문은 "상대 차이"라고만 적었는데, Table 2 숫자를 거꾸로 계산해 보면 분모가 LLM 기준 점수다. Mistral NQ-Open Perplexity의 −45.9%는 (0.584 − 0.852) / 0.584에서 나온 값이고, 원래 값인 ROUGE 기준 점수로 나누면 −31.5%다.
LLM 판정을 정답 기준으로 쓰려면 그 판정이 사람과 맞아야 한다. 저자들은 Mistral의 NQ-Open 답 200개를 골라 세 명이 따로 판정하게 했고, 판정자끼리의 Cohen's kappa는 0.799였다(§4). 사람 판정을 기준으로 hallucination을 잡아내는 성능을 보면, 정밀도가 LLM 판정은 0.736, ROUGE는 0.401이었고 재현율은 둘 다 0.957이었다(Table 1). 둘이 엇갈린 사례 위주로 고른 이 표본에서는, ROUGE가 hallucination이라고 한 답 10개 중 6개가 사람이 보기에 맞은 답이었다. 출판본 부록에는 판정 모델을 GPT-4.1로 바꿔도 GPT-4o-mini와 판정이 잘 맞는다는 결과(NQ-Open Cohen's kappa 0.883, Table 17)도 있다.
4. 실험 결과
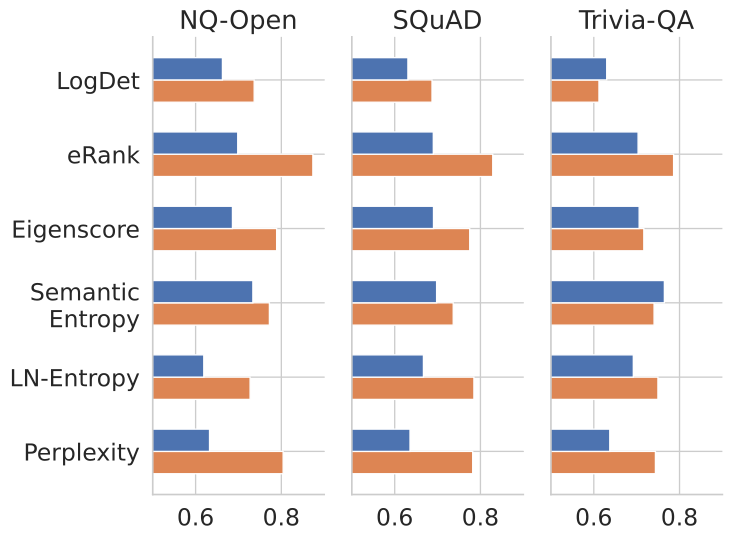
Fig. 2. Mistral few-shot 설정(파란 막대 값이 부록 Table 11의 few-shot 결과와 같다)에서 세 데이터셋의 탐지 방법별 AUROC를 ROUGE-L 라벨(주황)과 LLM 판정 라벨(파랑)로 각각 계산해 비교한 그림. 상당수 방법에서 두 값이 크게 다르다. (논문 Figure 1)출처: Janiak et al., EMNLP 2025 (CC BY 4.0)
주 결과는 zero-shot AUROC를 정리한 Table 2다. 가장 극적인 건 Mistral NQ-Open 행이다. Perplexity는 0.852에서 0.584로, eRank는 0.925에서 0.678로, EigenScore는 0.873에서 0.669로 떨어진다. Semantic Entropy는 0.836에서 0.729로 비교적 덜 떨어진다. 그래서 순위가 바뀐다. ROUGE 기준으로는 Semantic Entropy가 4위, Perplexity가 3위였는데, LLM 기준으로는 Semantic Entropy가 1위, Perplexity가 5위다.
나는 이 숫자를 무작위 분류기(0.5)보다 얼마나 나은지로 다시 봤다. Perplexity의 여유는 0.352에서 0.084로 줄었다. 내 계산으로는 ROUGE 라벨에서 보이던 판별력의 약 76%가 라벨 때문에 생긴 착시였던 셈이다. 논문이 내세운 "최대 45.9%"보다 오히려 더 심각한 그림이다.
모델 간 차이도 크다. Llama에서는 Perplexity와 Semantic Entropy가 거의 그대로지만(세 데이터셋 평균 0.715→0.725, 0.751→0.760), eRank와 EigenScore는 Llama에서도 평균 20.2%, 11.4% 떨어진다. 불확실성 기반 방법까지 크게 떨어지는 건 Mistral이다. 내 해석으로는 ROUGE가 Mistral의 맞은 답을 훨씬 많이 틀린 답으로 바꾸는 것과 관련이 있어 보인다. NQ-Open zero-shot 정답률이 Mistral은 ROUGE 7.8%, LLM 판정 39.0%이고 Llama는 24.2%, 43.2%다(부록 Table 13). 왜 Mistral에서 더 심한지는 설명이 없다. §5.3에 아키텍처와 사전학습이 few-shot 보정 효과에 영향을 줄 수 있다는 문장이 있을 뿐이다.
few-shot 예시를 넣으면 대체로 차이가 줄어든다. 다만 Mistral LN-Entropy처럼 오히려 커진 경우도 있다(zero-shot −6.8%, few-shot −12.5%). Llama eRank의 Δ는 zero-shot −16.7%에서 few-shot −4.2%로 줄어든다(Table 3). 저자들은 짧은 답 예시가 답 형식을 참조 답에 가깝게 맞춰 준 효과로 해석하고, few-shot에서 좋아진 성능 일부는 사실 판단이 아니라 형식이 맞아서 생긴 것일 수 있다고 덧붙인다.
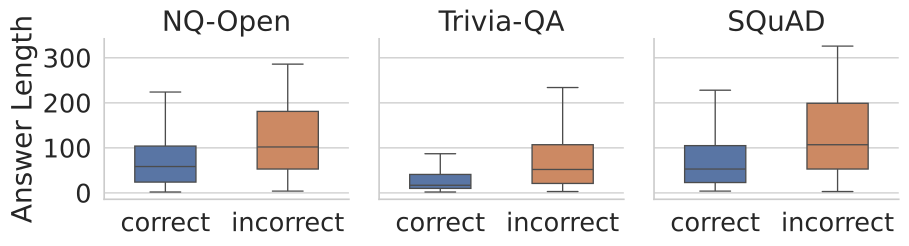
Fig. 3. Mistral few-shot 설정에서 LLM 판정 라벨로 나눈 답 길이 분포. 틀린 답이 더 길고 길이의 퍼짐도 크다. (논문 Figure 4)출처: Janiak et al., EMNLP 2025 (CC BY 4.0)
두 번째 축은 길이다. 라벨을 LLM 판정으로 고친 뒤에도 틀린 답은 실제로 더 길다(Fig. 3). ROUGE의 길이 편향과는 다른 이야기다. ROUGE 쪽은 라벨이 틀려서 생기는 문제였고, 이건 라벨을 고쳐도 남는 실제 신호다. 탐지기 점수와 길이의 피어슨 상관을 보면 EigenScore가 0.826(Llama)과 0.894(Mistral), eRank가 0.763과 0.803이다(Table 5). Perplexity는 Llama에서 +0.841, Mistral에서 −0.423으로 부호가 반대다.
길이 기준선의 성능은 LLM 판정 라벨로 잰 Table 6에 있다. 캡션에는 설정이 적혀 있지 않지만 숫자가 부록 Table 11의 few-shot 결과와 같다. Llama에서는 Perplexity 0.784, Semantic Entropy 0.773, Std-Len 0.751, Mean-Len 0.721이고, Mistral에서는 Semantic Entropy 0.732, Mean-Len 0.713이다. Mistral에서는 Mean-Len이 EigenScore(0.694), LN-Entropy(0.659), Perplexity(0.635)를 넘는다. 가장 좋은 방법과 가장 좋은 길이 기준선의 차이는 0.02~0.03 정도다.
부록 Table 10에서 내가 따로 눈여겨본 건 Mistral zero-shot의 Len 행이다. ROUGE 라벨로 채점하면 답 하나의 길이만으로 NQ-Open AUROC가 0.934, 세 데이터셋 평균이 0.908이 나온다. 어떤 탐지기보다도 높은 값이다. ROUGE 라벨 자체가 길이로 상당 부분 정해진다는 뜻으로 읽었다.
마지막으로 §6.4에 길이 실험이 세 가지 있다. 하나는 반복 실험(Table 7)이다. Mistral 답의 문장을 내용은 그대로 둔 채 1, 2, 4번 반복해 붙였더니 AUROC가 NQ-Open에서 0.852, 0.935, 0.955, 0.964로 계속 올랐다. 내용은 똑같은데 길이만으로 평가 결과가 바뀌니, ROUGE 기반 평가는 조작할 수 있다는 결론이다. 둘째는 길이를 조절하는 개입 실험(Table 8)이다. few-shot에서 같은 질문을 Concise, Short, Regular, Verbose 지시로 답하게 했더니 정확도가 0.697, 0.698, 0.634, 0.604로 길게 쓰게 할수록 떨어졌다. 저자들은 이를 근거로 길이가 hallucination에 기여하는 인과 요인으로 보인다고 쓴다. 셋째는 입력 교란 실험(Table 9)이다. TriviaQA 질문을 모호하게 바꾸면 답이 길어지고 정확도가 0.664에서 0.564로 떨어졌지만, 정답과 함께 그럴듯한 오답 정보를 담은 문맥(본문 기준)을 앞에 붙였을 때는 0.671로 거의 그대로였다. 저자들은 모호한 질문이 오도하는 문맥보다 hallucination을 더 강하게 일으킨다고 해석한다.
5. 읽으면서 든 의문
첫 번째는 사람 검증 표본을 고른 방식이다. §4 본문에는 "무작위로 골랐다"고 되어 있지만, 같은 문장에서 ROUGE와 LLM 판정이 엇갈린 사례가 고르게 들어가도록 했다고 하고, 부록 E에서는 아예 둘이 엇갈린 사례를 의도적으로 모았다고 밝힌다. 이렇게 고른 표본으로는 둘이 엇갈릴 때 누가 맞는지는 알 수 있어도, 전체 데이터에서 ROUGE의 정밀도가 얼마인지는 알 수 없다. 체계적인 사람 평가도 Mistral 한 모델, NQ-Open 한 데이터셋뿐이다(부록 M에서 TriviaQA 일부를 직접 검토해 판정 오류가 가끔 있었다고 적은 정도가 더 있다). 게다가 §4의 Implications 문단은 "ROUGE는 정밀도가 높지만 중요한 오류를 많이 놓친다"고 써서, 같은 절의 Key Findings와 Table 1, 초록 내용(ROUGE는 재현율이 높고 정밀도가 낮다)과 반대로 말한다. Table 1의 Agreement 열이 무엇을 잰 값인지도 정의되어 있지 않고, 두 판정 방식의 재현율이 0.957로 똑같이 나온 것도 논문 설명만으로는 어떻게 나왔는지 알 수 없었다.
두 번째는 Δ%의 분모다. 앞에서 말했듯 Table 2는 LLM 기준 점수로 나눈 값이라 헤드라인 숫자가 커 보인다. 그런데 Table 3을 계산해 보면 여기서는 ROUGE 기준 점수로 나눈 것 같다(Mistral zero-shot Perplexity 0.747 → 0.579, −22.4%). 표마다 기준이 다르면 숫자를 서로 비교하기가 어렵다. 0.5 기준 여유로 보면 결론이 더 강해지는데, 정작 그 해석은 하지 않았다.
세 번째는 길이 기준선 주장이 조금 과장되었다는 점이다. §6.3은 Mean-Len이 EigenScore와 LN-Entropy에 맞먹거나 넘는다고 쓴다. Table 6에서 Mistral 평균은 그렇지만(0.713 vs 0.694/0.659), Llama 평균은 그렇지 않다(0.721 vs 0.747/0.759). Llama는 데이터셋별로 보면 NQ-Open과 SQuAD에서 LN-Entropy와 0.002 이내로 비슷하지만, 넘는 경우는 없다. "길이 기준선이 충분히 강하니 반드시 비교 대상에 넣어야 한다"는 결론은 맞지만, few-shot 결과로 보면 "능가한다"는 표현은 Mistral에만 해당한다.
네 번째는 길이와 hallucination의 관계를 어떻게 해석하느냐다. §6.4의 개입 실험은 길게 쓰라고 지시하면 정확도가 떨어진다는 걸 보여 주지만, 이때 바뀌는 건 길이만이 아니라 프롬프트 지시 자체다. 길게 쓰라는 지시를 받은 모델이 확신 없는 내용을 더 덧붙였을 수도 있으니, 길이 그 자체의 효과와 지시의 효과가 섞여 있다. 저자들도 이 실험들이 인과 메커니즘을 확정하려는 것은 아니라고 §6.4에 적었고, 부록 N에서는 오히려 길이 자체는 직접적인 원인이 아니라 밑에 있는 추론 과정의 결과라고 쓴다. 같은 논문 안에서 "기여하는 인과 요인으로 보인다"(§6.4)와 "직접적인 원인이 아니다"(부록 N)가 함께 있는 셈이라, 길이를 원인으로 읽어야 할지는 이 논문만으로는 분명하지 않다. 반복 실험 쪽은 어떤 탐지기의 AUROC인지 적혀 있지 않다. NQ-Open(0.852)과 Trivia-QA(0.843)는 Mistral zero-shot Perplexity의 ROUGE 기준 값과 같지만, SQuAD(0.842)는 Perplexity 값(0.516)과 다르다. LLM 판정 기준으로는 어떻게 되는지도 보고하지 않았다. 개인적으로는 질문당 평가하는 답이 하나뿐이라는 점이 더 마음에 걸렸다. 이 경우 AUROC는 질문 사이의 순위만 재게 되니, 탐지기와 길이가 사실은 질문이 얼마나 어려운지를 읽고 있을 수도 있다. 어려운 질문이면 모델이 답을 길게 돌려 말하기도 하고 틀리기도 쉽다. 내 해석으로는 길이는 감기가 아니라 열 같은 증상이다. 원인은 아니어도 신호로는 쓸모가 있다. 그래서 "탐지기는 길이 기준선을 넘어야 한다"는 결론은 그대로 유효하지만, 길이를 원인으로까지 읽는 데는 조심해야 한다고 생각한다.
다섯 번째는 거부 응답 처리다. refuse를 hallucination으로 쳤는데, 그 영향을 따로 분석하지 않았다. Llama few-shot은 NQ-Open에서 692개, SQuAD에서 924개를 거부했다(부록 Table 13). SQuAD 4,150개 중 4분의 1 가까운 양이다. 이 설정은 LLM 판정 정답률(18.3%)이 ROUGE 정답률(22.0%)보다 낮게 나오는 드문 경우이기도 하다.
여섯 번째는 반복 실행과 신뢰구간이 없다는 점이다. 실행이 한 번뿐이라 Llama 행처럼 Δ가 몇 퍼센트 수준인 결과는 의미를 두기 어렵다. 다만 Mistral NQ-Open의 큰 차이는 문항 수천 개 규모에서 우연으로 설명하기 어렵다고 본다.
마지막은 선행 연구다. 응답 길이와 정답 판정 함수의 편향이 불확실성 평가를 왜곡한다는 비슷한 문제를 다룬 Santilli et al.(ACL 2025)이 참고문헌에 없다. 또 기여가 세 가지로 나뉘어 있지만, 실제로는 라벨을 바꿔 다시 채점한 실험 하나에서 나머지가 따라 나온다고 느꼈다.
6. 정리
이 논문에서 가장 설득력 있는 건 Table 2의 Mistral 행이다. NQ-Open에서 Perplexity가 0.852에서 0.584로, eRank가 0.925에서 0.678로 떨어지는 정도의 차이는 문항 수천 개 규모에서 잡음으로 설명하기 어렵고, 탐지기 순위도 실제로 뒤집힌다. 그러니 "ROUGE 라벨이 탐지기 성능을 부풀려 왔다"는 핵심 주장은 충분히 성립한다. Mistral zero-shot에서는 ROUGE 라벨로 채점하면 답 길이 하나만으로 평균 AUROC가 0.908까지 나온다는 사실도 이 주장을 뒷받침한다.
반면 부차 주장은 근거보다 앞서 나간다. few-shot 결과(Table 6)에서 Mean-Len이 EigenScore와 LN-Entropy를 넘는 건 Mistral에서만 맞고, 그때도 Semantic Entropy는 넘지 못한다. 길이가 hallucination의 원인이라는 해석도 §6.4의 개입 실험은 지시와 길이가 섞여 있고, 부록 N은 길이를 결과로 본다. LLM 판정을 검증한 사람 평가 표본은 골라서 뽑은 것이고, 가까운 선행 연구도 빠져 있다. 그래도 탐지 방법을 비교할 때 라벨부터 의심해 보라는 메시지와, 길이 기준선을 기본 비교 대상으로 넣으라는 제안은 이 분야 논문을 읽을 때 계속 떠올릴 만하다고 생각한다.
7. 같이 읽어볼 논문
- Farquhar et al. (Nature 2024), Detecting hallucinations in large language models using semantic entropy. 이 논문이 ROUGE-L 0.3 기준을 쓸 때 근거로 든 선행 연구다.
- Chen et al. (ICLR 2024), INSIDE: LLMs' Internal States Retain the Power of Hallucination Detection. 길이와의 상관이 Mistral에서 가장 높게(0.894), Llama에서도 0.826으로 높게 나온 EigenScore를 제안한 논문이다.
- Zheng et al. (NeurIPS 2023), Judging LLM-as-a-judge with MT-Bench and Chatbot Arena. 이 논문이 LLM 판정을 설계할 때 방법론으로 따른 논문이다.
- Santilli et al. (ACL 2025), Revisiting Uncertainty Quantification Evaluation in Language Models: Spurious Interactions with Response Length Bias Results. 정답 판정 함수와 불확실성 방법이 함께 가진 길이 편향이 AUROC 순위를 왜곡한다는 것을 보인 짧은 논문이다. 개인적으로는 이 논문보다 먼저 나온 가장 가까운 연구라고 본다.