When Can LLMs Actually Correct Their Own Mistakes? A Critical Survey of Self-Correction of LLMs
자기수정(self-correction) 연구들이 연구질문을 엄밀히 정의하지 않고 오라클 정보나 약한 초기응답 같은 불공정한 설정으로 효과를 과대평가해왔음을 지적하며, 연구질문을 RQ1(내재적 능력만)/RQ2(외부정보 지원)/RQ3(최종성능 비교)로 재정의하고 Fair/Unfair 프레임워크로 기존 문헌을 재분류한 결과, 프롬프팅만으로는 일반 태스크에서 성공적 자기수정 증거가 없으며 신뢰 가능한 외부 피드백이나 대규모 파인튜닝이 있을 때만 작동한다는 것을 밝힌다.
LLM이 자기 실수를 스스로 고칠 수 있느냐는 질문은 논문마다 답이 다르다. Self-Refine이나 RCI는 된다고 하고, Huang et al.(ICLR 2024)의 "Large Language Models Cannot Self-Correct Reasoning Yet"은 추론 과제에서 외부 피드백 없이 스스로 고치면 성능이 나아지지 않고 오히려 떨어지기도 한다고 보고한다. 둘 다 읽고 나면 그래서 뭘 믿어야 하는지 헷갈리는데, 이 논문은 바로 그 혼란을 정리하려고 쓴 서베이다. 새 방법을 내놓는 대신, 기존 연구들이 무엇을 검증하려는지 분명히 정하지 않았고 공정하지 않은 설정에서 실험한 경우가 많았다는 걸 보여 준다.
- 저자: Ryo Kamoi, Yusen Zhang, Nan Zhang, Jiawei Han, Rui Zhang (Penn State University, Jiawei Han은 UIUC)
- 게재: TACL Volume 12, pp.1417–1440 (2024), arXiv 2406.01297
- 코드: 서베이 논문이라 따로 공개한 코드나 데이터는 없다.
0. 한 줄 요약
self-correction 연구 중 상당수는 연구 질문을 정확히 정하지 않은 채 정답 라벨 같은 oracle 정보를 쓰거나 초기 응답에만 약한 프롬프트를 주는 식으로 효과를 실제보다 크게 평가해 왔다. 이 논문은 연구 질문을 셋으로 나누고 각 실험이 공정한 설정이었는지 기준을 세워 기존 문헌을 다시 분류했다. 그렇게 보면 프롬프팅만으로 일반 태스크에서 self-correction에 성공한 증거는 없다. 응답을 쪼개 검증할 수 있는 태스크처럼 self-correction에 특히 유리한 경우를 빼면, 믿을 만한 외부 피드백이 있거나 대규모로 fine-tuning했을 때 효과가 있었다.
1. 문제 정의
self-correction은 LLM이 추론 시점에 자기 응답을 다시 보고 다듬는 접근이다. 산술 추론, 코드 생성, QA 등 여러 과제에서 쓰이는데, 정작 효과가 있느냐는 질문에는 논문마다 정반대 결론을 낸다. 저자들은 이렇게 결론이 엇갈리는 이유를 연구 질문이 모호하고 검증에 쓴 실험 설정이 적절하지 않았기 때문이라고 본다(§1, §3.1).
논문이 드는 예시가 구체적이다. RCI는 정답을 보고 초기 응답이 맞으면 고치지 않고 멈춘다. 정답 여부를 아는 상태에서 고칠 대상을 고르는 셈이라 실제 배포에서는 쓸 수 없는 설정이다. Self-Refine은 초기 응답을 만들 때만 약하거나 틀린 지시와 few-shot 예시를 써서, 고친 뒤의 개선 폭이 실제보다 커 보인다(§4, Table 4). 저자들은 이런 설정이 self-correction의 효과를 과대평가한다고 본다. 개인적으로도 이런 숫자를 그대로 실무에 가져가면 기대한 효과가 안 나올 수 있다고 생각한다.
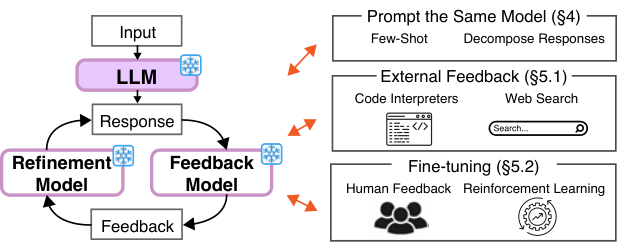
Fig. 1. 왼쪽은 self-correction의 세 단계로, LLM이 응답을 만들고, feedback 모델이 피드백을 주고, refinement 모델이 피드백을 반영해 응답을 고치는 순환이다. 오른쪽은 피드백을 어디서 얻느냐에 따른 세 갈래로, 같은 모델에 프롬프팅(§4), 코드 인터프리터나 웹 검색 같은 외부 피드백(§5.1), 사람 피드백이나 강화학습으로 하는 fine-tuning(§5.2)이다(논문 Figure 1).출처: Kamoi et al., TACL 2024 (CC BY 4.0)
2. 기존 방법들의 한계
이 논문은 서베이라서, 저자들이 기존 연구를 어떻게 묶고 각각 어디가 문제라고 봤는지를 따라가면 된다. Table 1의 구분을 따르면 크게 네 갈래다.
첫째는 프롬프팅만으로 하는 self-correction이다(Self-Refine, RCI 등). 저자들이 원논문을 다시 확인해 보니, 정답 라벨 같은 oracle 정보를 쓰거나(RCI, Reflexion) 초기 응답에만 약한 프롬프트를 써서 효과를 부풀린 경우가 많았다(§4, Table 4).
둘째는 외부 도구나 지식을 쓰는 방법이다(CRITIC, RARR, FLARE 등). 일부 방법은 외부 지식을 고치는 단계에서만 쓰고 초기 응답을 만들 때는 쓰지 않는다. 이러면 같은 정보를 처음부터 줬을 때보다 self-correction이 나은지 알 수 없어서 RQ2를 검증하는 데는 쓸 수 없다. 다만 최종 성능만 비교하는 RQ3에는 쓸 수 있다고 저자들은 본다(§5.1, Table 5). RARR이 이런 사례다.
셋째는 fine-tuning 기반 방법이다(Self-Critique, SelFee 등). 데이터가 많으면 효과가 있다고 보고되지만, 데이터가 적을 때도 되는지는 검증된 적이 없다(§5.2).
넷째는 self-correction이 안 된다는 결과를 낸 논문들이다(Huang et al. 2024a 등). 흥미로운 건 저자들이 이쪽도 그냥 넘어가지 않는다는 점이다. Table 2는 Huang et al.을 RQ1과 RQ3를 반박한다고 주장하는 연구로 분류하고, Table 8에는 부정적 결과를 보고할 때 쓰는 체크리스트를 따로 둔다. 어떤 연구 질문을 반박하는지 밝히고, self-correction에 강한 프롬프트를 쓰고, 실제로 쓸 수 있는 외부 도구나 지식을 쓰지 않았다면 약한 조건에서 평가했다고 밝히라는 내용이다. 안 된다는 결과도 어떤 조건에서 나왔는지부터 따져 봐야 한다는 것이다.
3. 방법
개인적으로는 이 논문의 핵심이 하나라고 본다. self-correction의 연구 질문을 셋으로 나누고, 실험 설정을 판단하는 기준 두 가지를 도입한 것이다. 문헌 재분류(Table 1, 4, 5, 6)와 체크리스트(Table 7, 8)는 이 틀을 실제 문헌에 적용하고 다른 연구자들이 쓰기 좋게 정리한 결과물로 읽었다.
먼저 연구 질문을 셋으로 나눈다. RQ1은 모델이 자기 능력만으로 최선의 초기 응답을 고칠 수 있는지, RQ2는 외부 정보의 도움을 받으면 최선의 초기 응답을 고칠 수 있는지, RQ3는 self-correction을 거친 최종 결과가 다른 방법보다 나은지를 묻는다. 저자들은 한 논문 안에서도 이 질문들이 구분 없이 섞인다고 지적한다. RCI는 산술 추론에서는 초기 응답과만 비교해 RQ1을, MiniWoB++에서는 다른 방법과 비교해 RQ3를 겨냥했고, CRITIC도 산술 추론에서는 RQ2를, detoxification에서는 RQ3를 겨냥했다(§3.1).
여기서 "최선의 초기 응답"이 중요하다. 고치는 단계에서 쓸 수 있는 정보를 초기 응답을 만들 때도 최대한 활용했을 때 나오는 응답을 말한다. 이게 공정성을 따지는 기준점이 된다.
다음으로 실험 설정을 두 단계로 나눈다. 먼저 정답 라벨처럼 실제 배포 환경에서는 없는 oracle 정보를 쓰면 unrealistic, 그렇지 않으면 realistic이다. realistic한 설정 안에서도 초기 응답을 만들 때 쓸 수 있는 정보를 최대한 활용했으면 fair, 초기 응답이 최선이 아니면 unfair로 본다(§3.2, 논문 Figure 2·3). 고치는 단계에만 외부 정보를 주거나, 초기 응답을 만들 때만 약한 프롬프트를 준 경우가 unfair에 해당한다. fair 설정은 다시 둘로 나뉜다. 같은 모델이 같은 정보만 가지고 스스로 피드백을 만들어 고치는 intrinsic self-correction은 RQ1을, 고치는 단계에 추가 정보를 쓰되 초기 응답에도 그 정보를 최대한 활용하는 fair-asymmetric self-correction은 RQ2를 검증하는 데 쓴다.
질문별로 필요한 조건도 정리돼 있다(Table 3). RQ1과 RQ2를 검증하려면 최선의 초기 응답과 비교해야 하고, RQ3를 검증하려면 강한 베이스라인과 비교해야 한다. 이 틀을 기존 문헌에 대 보고 무엇이 실제로 검증됐는지 다시 판정한 뒤(§4, §5, §7), 마지막에 질문별로 꼭 필요한 실험 조건과 권장 조건을 체크리스트로 정리한다(§8, Table 7·8).
이 틀이 잘 작동하려면 전제가 하나 있다. 고치는 단계에서 쓴 정보와 초기 응답을 만들 때 쓸 수 있었던 정보를 분명하게 나눌 수 있어야 한다. 개인적으로는 외부 지식을 초기 응답에 "최대한" 활용했는지를 결국 사람이 판단해야 한다는 점이 걸렸다. fair와 unfair의 정의는 §3.2에 있지만, 어떤 사례가 초기 응답에 정보를 "최대한" 활용했는지는 저자들이 사례마다 따져서 판정한다.
4. 실험 결과
서베이라서 직접 돌린 실험은 없다. 대신 2024년 5월까지 나온 self-correction 논문들을 모아 위의 틀로 다시 분류했다. Table 1은 대표 연구들을 fair, unfair, oracle 사용 여부 등으로 태깅한 표이고, Table 4는 프롬프팅 기반에서 불공정한 사례, Table 5는 외부 도구와 지식을 쓰는 방법 6편, Table 6은 fine-tuning 기반 방법을 다룬다.
가장 눈에 띄는 건 Table 4다. 프롬프팅 기반 연구에서 self-correction을 과대평가한 설정을 모은 표인데, RCI와 Reflexion은 논문 전체가 아니라 특정 실험만 올라가 있다. RCI 논문 §3.1의 computer tasks 실험은 정답을 종료 조건으로 썼고, Reflexion 논문 §4.2의 HotpotQA 실험은 정답과의 exact match를 피드백으로 썼다. CAI Revisions와 Self-Refine은 초기 응답 프롬프트가 약했다. 같은 Reflexion이라도 게임과 코딩 실험은 Table 1에서 fair-asymmetric, 즉 공정한 설정으로 분류됐다. 한편 Table 1 하단의 부정적 결과 3편(RCI 논문이 자기 Table 17에 보고한 결과, 도구 없는 CRITIC, Huang et al. 2024a)은 fair 설정 중 하나인 intrinsic 설정, 즉 같은 모델이 같은 정보만으로 고치는 설정에서 실패를 보고했다. 내가 보기에는 일반 태스크에서 Table 4와 Table 1 하단을 나란히 놓으면, 프롬프팅만으로 된다는 결과는 대부분 oracle을 쓰거나 초기 응답 프롬프트가 약한 설정에서 나왔고, 안 된다는 결과는 초기 응답 프롬프트를 약하게 두지 않은 intrinsic 설정에서 나왔다. CoVe 같은 예외는 아래에서 다룬다.
예외로 다루는 사례도 있다. 프롬프팅만으로 성공한 경우로 CoVe를 드는데, 응답을 작은 질문들로 쪼개서 검증할 수 있는 태스크라서 가능했다고 설명한다(§4).
초록은 결론을 세 가지로 요약한다. 프롬프팅만으로는 self-correction에 특히 유리한 태스크를 빼면 성공한 사례가 없고, 신뢰할 수 있는 외부 피드백이 있으면 효과가 있고, 대규모 fine-tuning을 하면 효과가 있다. 서론에서는 유리한 태스크가 있다는 점을 따로 한 항목으로 떼어 내고, self-correction이 강한 베이스라인보다 나은지는 아직 알 수 없다고 덧붙인다(§6).
정량 수치를 새로 만든 논문이 아니라서 숫자로 환산해 볼 결과는 없다. 이 논문의 결과는 기존 결과를 다시 해석한 것 자체다.
5. 읽으면서 든 의문
첫 번째는 기여를 어떻게 셀 것이냐다. 초록과 서론은 여러 결론을 나열하지만, 실제로 새로운 건 연구 질문 3분류와 fair/unfair 기준 하나라고 생각한다. 문헌 재분류, 체크리스트, 향후 연구 방향은 그 기준을 문헌에 적용한 결과다. 서베이 논문이라 자연스러운 구성이긴 하지만, 읽을 때는 이 점을 감안하는 게 좋다.
두 번째는 판정이 정성적이라는 점이다. fair와 unfair를 가르는 데 정량적인 기준이 있는 게 아니라 저자들이 사례마다 판단했다(Table 4, Table 5). 예를 들어 코드 인터프리터를 쓰는 건 fair인데 검색 엔진을 고치는 단계에서만 쓰면 unfair라는 구분(§5.1)은, 그 도구를 초기 응답에도 바로 쓸 수 있느냐에 대한 저자들의 판단이다. RARR을 unfair로 본 것도 마찬가지다. 다른 연구자가 보면 다르게 판단할 여지가 있고, 그러면 §8 체크리스트를 다른 사람이 적용했을 때 같은 결론이 나온다는 보장도 약해진다. 이 논문에서 가장 아쉬운 부분이었다.
세 번째는 다루는 시기다. 2024년 5월까지 나온 논문만 본격적으로 분석했고, 그 뒤에 쏟아진 o1 계열의 RL 기반 self-correction은 §12에서 짧게만 다룬다. 저자들도 §1에서 이 범위를 직접 밝혔다. 그래서 프롬프팅만으로는 안 된다는 핵심 주장이 최신 추론 모델에도 그대로 맞는지는 이 논문만으로는 알 수 없다.
네 번째는 CoVe를 예외로 둔 근거다. 응답을 쪼갤 수 있는 태스크에서는 프롬프팅만으로도 된다고 하는데, 내가 보기에 이 결론의 근거는 많지 않다. Table 1에서 쪼갤 수 있는 태스크로 표시된 건 CoVe 한 편이고, §5.1에서 검증이 쉬운 태스크로 Self-Refine의 constrained generation과 Game of 24를 덧붙이는 정도다. 저자들도 §11에서는 intrinsic self-correction이 잘 되는 태스크가 아직 탐구되지 않은 채 더 있을 거라는 기대로 남겨 둔다.
그래도 좋았던 점이 분명하다. Table 1의 대표 연구 15편(20개 설정)과 그 밖의 많은 문헌을 하나의 기준으로 일관되게 다시 정리했다. Table 1·4·5·6에 분류 결과를 싣고, 부록 Table 9·10에는 Self-Refine이 실제로 쓴 프롬프트까지 보여 줘서 판단 근거를 확인할 수 있게 했다. 독자가 저자들의 분류에 동의하지 않더라도 어디서 판단이 갈리는지 직접 짚어 볼 수 있게 써 놓았다.
6. 정리
이 논문이 설득력 있는 이유는 서로 모순돼 보이던 결과들을 한 번에 설명해 내기 때문이다. Self-Refine과 Huang et al.은 둘 다 RQ1을 다뤘지만, Self-Refine은 초기 응답을 약하게 만든 unfair 설정이었다. 내 해석으로는, 같은 질문을 다뤘는데도 답이 갈린 데에는 이 설정 차이가 크게 작용한 것으로 보인다. 두 논문이 다룬 과제도 달랐다는 점은 감안해야 한다. 연구 질문 3분류와 fair/unfair 기준을 대 보면 Table 1, 4, 5의 재분류가 일관되게 맞아떨어진다. fair와 unfair를 가르는 판단이 정성적이라는 한계는 있지만, 그 때문에 재분류 전체가 틀렸다고 보기는 어렵다.
개인적으로 이 논문에서 가져갈 건, self-correction 결과를 볼 때 무엇과 비교했는지부터 확인하는 습관이다. 고친 뒤의 성능이 올랐다는 것만으로는 부족하고, 고치는 데 쓴 정보를 처음부터 줬을 때보다도 나은지 물어봐야 한다. 이 질문 하나만 던져도 self-correction 논문의 상당수가 다르게 읽힌다.
7. 같이 읽어볼 논문
- Saunders et al. (2022), Self-critiquing models for assisting human evaluators. self-correction의 바탕이 되는 "오류를 알아보는 것이 처음부터 피하는 것보다 쉽다"는 가설의 근거로 이 서베이가 §1에서 인용하는 논문이다.
- Madaan et al. (2023), Self-Refine. 이 서베이가 비판하는 대표 사례다. 초기 응답 프롬프트를 어떻게 줬는지 직접 확인하면서 읽으면 재미있다.
- Kim et al. (2023), RCI Prompting. 정답 라벨을 종료 조건에 쓴 대표 사례로 Table 4에 나온다.
- Huang et al. (ICLR 2024), Large Language Models Cannot Self-Correct Reasoning Yet. 이 서베이와 문제의식이 같은 비판 논문이고, §9에서 이 논문과 직접 비교한다.