토큰과 다음 토큰 예측: LLM은 문장을 어떻게 만들까?
토큰화와 토큰 ID, 다음 토큰 확률, 반복 생성을 작은 가상 예시로 설명하는 비전공자용 입문 시리즈 1편.
0. 문장을 만드는 작은 단위
LLM은 많은 텍스트를 학습한 대규모 언어 모델이다. 채팅창에서는 답변이 문장으로 보이지만, 그 문장을 생성하는 기본 단위는 토큰이다. 토큰은 모델이 텍스트를 처리할 때 사용하는 조각이며, 단어 하나와 같을 수도 있고 단어의 일부나 문장부호일 수도 있다.
이 글에서는 앞에 있는 텍스트를 바탕으로 다음 토큰을 예측하고, 선택한 토큰을 이어 붙이는 자기회귀 방식의 텍스트 생성을 다룬다. “다음 토큰을 예측한다”가 무엇을 입력받아 무엇을 내놓는다는 뜻인지, 작은 예시를 끝까지 따라가며 살펴본다. 언어 모델마다 학습 방식이 같은 것은 아니며, 여기서는 GPT 계열처럼 다음 토큰 예측을 기본으로 하는 경우에 범위를 둔다. Hugging Face의 모델 구조 설명에서도 이러한 방식과 가려진 단어를 복원하는 방식을 구분한다.
1. 토큰은 단어와 어떻게 다를까?
문장을 띄어쓰기대로만 나누면 처음 보는 단어나 긴 합성어를 어떻게 처리할지 문제가 생긴다. 반대로 모든 글자를 하나씩 나누면 표현할 수 있는 글자의 종류는 줄어들지만, 같은 문장을 훨씬 긴 조각의 나열로 처리해야 할 수 있다. 이 사이에서 자주 쓰이는 방법이 단어보다 작은 조각도 사용하는 서브워드 토큰화다.
토큰화는 텍스트를 토큰으로 나누는 과정이고, 토크나이저는 그 작업을 수행하는 도구다. 다음 그림에서 영어 단어 tokenization은 token과 ization으로 나뉜다. 한 단어가 두 토큰이 되는 예다. 문장 끝의 느낌표도 별도 조각으로 표시되어 있다.

Fig. 1. 단어의 일부도 토큰이 될 수 있음을 보여 주는 예시.출처: Hugging Face Course contributors, Tokenizers의 서브워드 토큰화 그림. 원본 이미지, 데이터셋 라이선스 Apache-2.0. SVG를 흰 배경 PNG로 변환했다.

그림의 </w>는 이 예시에서 단어가 끝나는 위치를 나타내는 표시다. 사용자가 입력한 문장에 그대로 들어 있던 글자는 아니다. 또 이 그림처럼 나누는 규칙이 모든 모델에 공통인 것은 아니다. 사용하는 토크나이저에 따라 같은 문장도 다른 조각으로 나뉜다. 따라서 “한국어 한 단어는 몇 토큰인가?”에는 토크나이저를 정하지 않은 채 고정된 숫자로 답하기 어렵다.
2. 조각을 나눈 뒤에는 번호로 바꾼다
토크나이저는 각 조각을 토큰 ID라는 정수 번호로 바꾼다. 모델이 사용하는 토큰 목록을 어휘라고 하며, ID는 그 목록에서 어느 항목인지를 가리킨다. Hugging Face의 토큰화 설명은 텍스트를 조각으로 나누는 단계와 조각을 입력 ID로 바꾸는 단계를 구분한다.
예를 들어 설명용 어휘에서 나는의 ID를 17, 밥을의 ID를 42라고 정할 수 있다. 여기서 17과 42는 임의로 정한 번호다. 42가 더 큰 숫자라고 해서 그 토큰의 의미가 더 크거나 중요하다는 뜻은 아니다. 모델은 이 번호를 바탕으로 학습된 숫자 묶음인 벡터를 찾아 사용한다. 벡터는 여러 숫자를 일정한 순서로 모은 표현이다. 번호 자체와 그 번호로 찾아가는 표현은 구분해야 한다. 입력 ID를 벡터로 바꾸는 단계는 Hugging Face의 모델 처리 흐름 설명에서도 확인할 수 있다.
실제로는 모델과 함께 제공되는 토크나이저를 사용해야 한다. 다른 어휘에서 같은 번호가 다른 토큰을 가리키면 모델에 엉뚱한 입력을 주게 되기 때문이다. 토큰이 어떤 벡터로 바뀌고 문맥에 따라 어떻게 처리되는지는 별도로 다룰 수 있지만, 여기서는 “텍스트 조각을 번호로 바꿔 모델에 전달한다”는 흐름이면 충분하다.
3. 다음 토큰 예측은 후보들의 확률을 구하는 일이다
이제 입력이 나는이라고 해 보자. 모델은 지금까지 주어진 토큰들을 바탕으로 다음 자리에 올 토큰들의 확률을 계산한다. 다음 표는 원리를 설명하기 위해 만든 가상 예시다. 실제 모델을 실행한 결과가 아니며, 계산을 단순하게 하려고 이 단계에서는 표의 네 후보에만 0보다 큰 확률을 부여한다. 어휘에는 입력인 나는과 뒤에서 사용할 먹는다도 포함하지만, 이 첫 예측 단계에서 이들의 확률은 0으로 가정한다. 밥을처럼 앞에 공백을 포함한 문자열도 이 예시에서는 각각 한 토큰이라고 정한다. 실제 한국어 토크나이저가 이렇게 나눈다는 뜻은 아니다.
| 다음 토큰 후보 | 입력이 나는일 때의 확률 |
|---|---|
밥을 |
0.50 |
책을 |
0.30 |
잠을 |
0.15 |
일을 |
0.05 |
네 확률을 더하면 1이다. 0.50은 이 예시의 모델이 현재 문맥 뒤에 밥을이 이어질 확률을 50%로 두었다는 뜻이다. “나는 밥을 먹었다는 사실이 50% 확률로 참이다”라는 뜻은 아니다. 아직 먹는다라는 뒷부분조차 생성하지 않았다.
확률을 구하는 일과 실제로 한 토큰을 고르는 일도 다르다. 가장 확률이 높은 후보를 고르는 탐욕적 선택을 쓰면 이 단계에서는 밥을이 선택된다. 확률에 따라 무작위로 뽑는 샘플링을 쓰면 책을이 나올 수도 있다. 원래 표의 확률을 그대로 사용해 샘플링한다면, 같은 조건에서 여러 번 뽑았을 때 밥을은 대략 절반 정도 선택될 것으로 기대한다. 한 번의 생성에서 무조건 나오는 것은 아니다. 두 선택 방식은 Transformers의 생성 전략 안내에서 구분해 설명한다.
4. 하나를 붙이면 다음 예측의 문맥이 바뀐다
밥을을 골랐다면 지금까지의 텍스트는 나는 밥을이 된다. 다음 단계에서는 이 텍스트를 바탕으로 다시 확률을 구한다. 처음 표에서 두 번째로 확률이 높았던 책을을 그대로 이어 붙이는 것이 아니다. 앞에 어떤 토큰이 선택되었는지에 따라 다음 후보들의 확률이 달라진다.
이제 나는 밥을 뒤에 먹는다가 올 확률을 0.60이라고 가정하자. 이것도 앞의 예시에 이어 붙인 가상 수치다. 이 토큰까지 고르면 텍스트는 나는 밥을 먹는다가 된다. 선택한 토큰을 문맥에 추가하고 다음 토큰을 예측하는 반복이 자기회귀 생성의 기본 흐름이다.
다음 그림은 각 행의 왼쪽에 있는 텍스트를 보고 오른쪽의 다음 항목을 예측하는 모습을 보여 준다. 위에서 아래로 갈수록 왼쪽 문맥이 길어진다. 그림은 다음 토큰 예측 학습의 관계를 단순하게 보여 주는 도식이며, 실제 모델의 출력 확률이나 실행 기록은 아니다. 읽기 쉽게 단어 단위로 그렸지만 실제 처리 단위는 사용하는 토크나이저의 토큰이다.
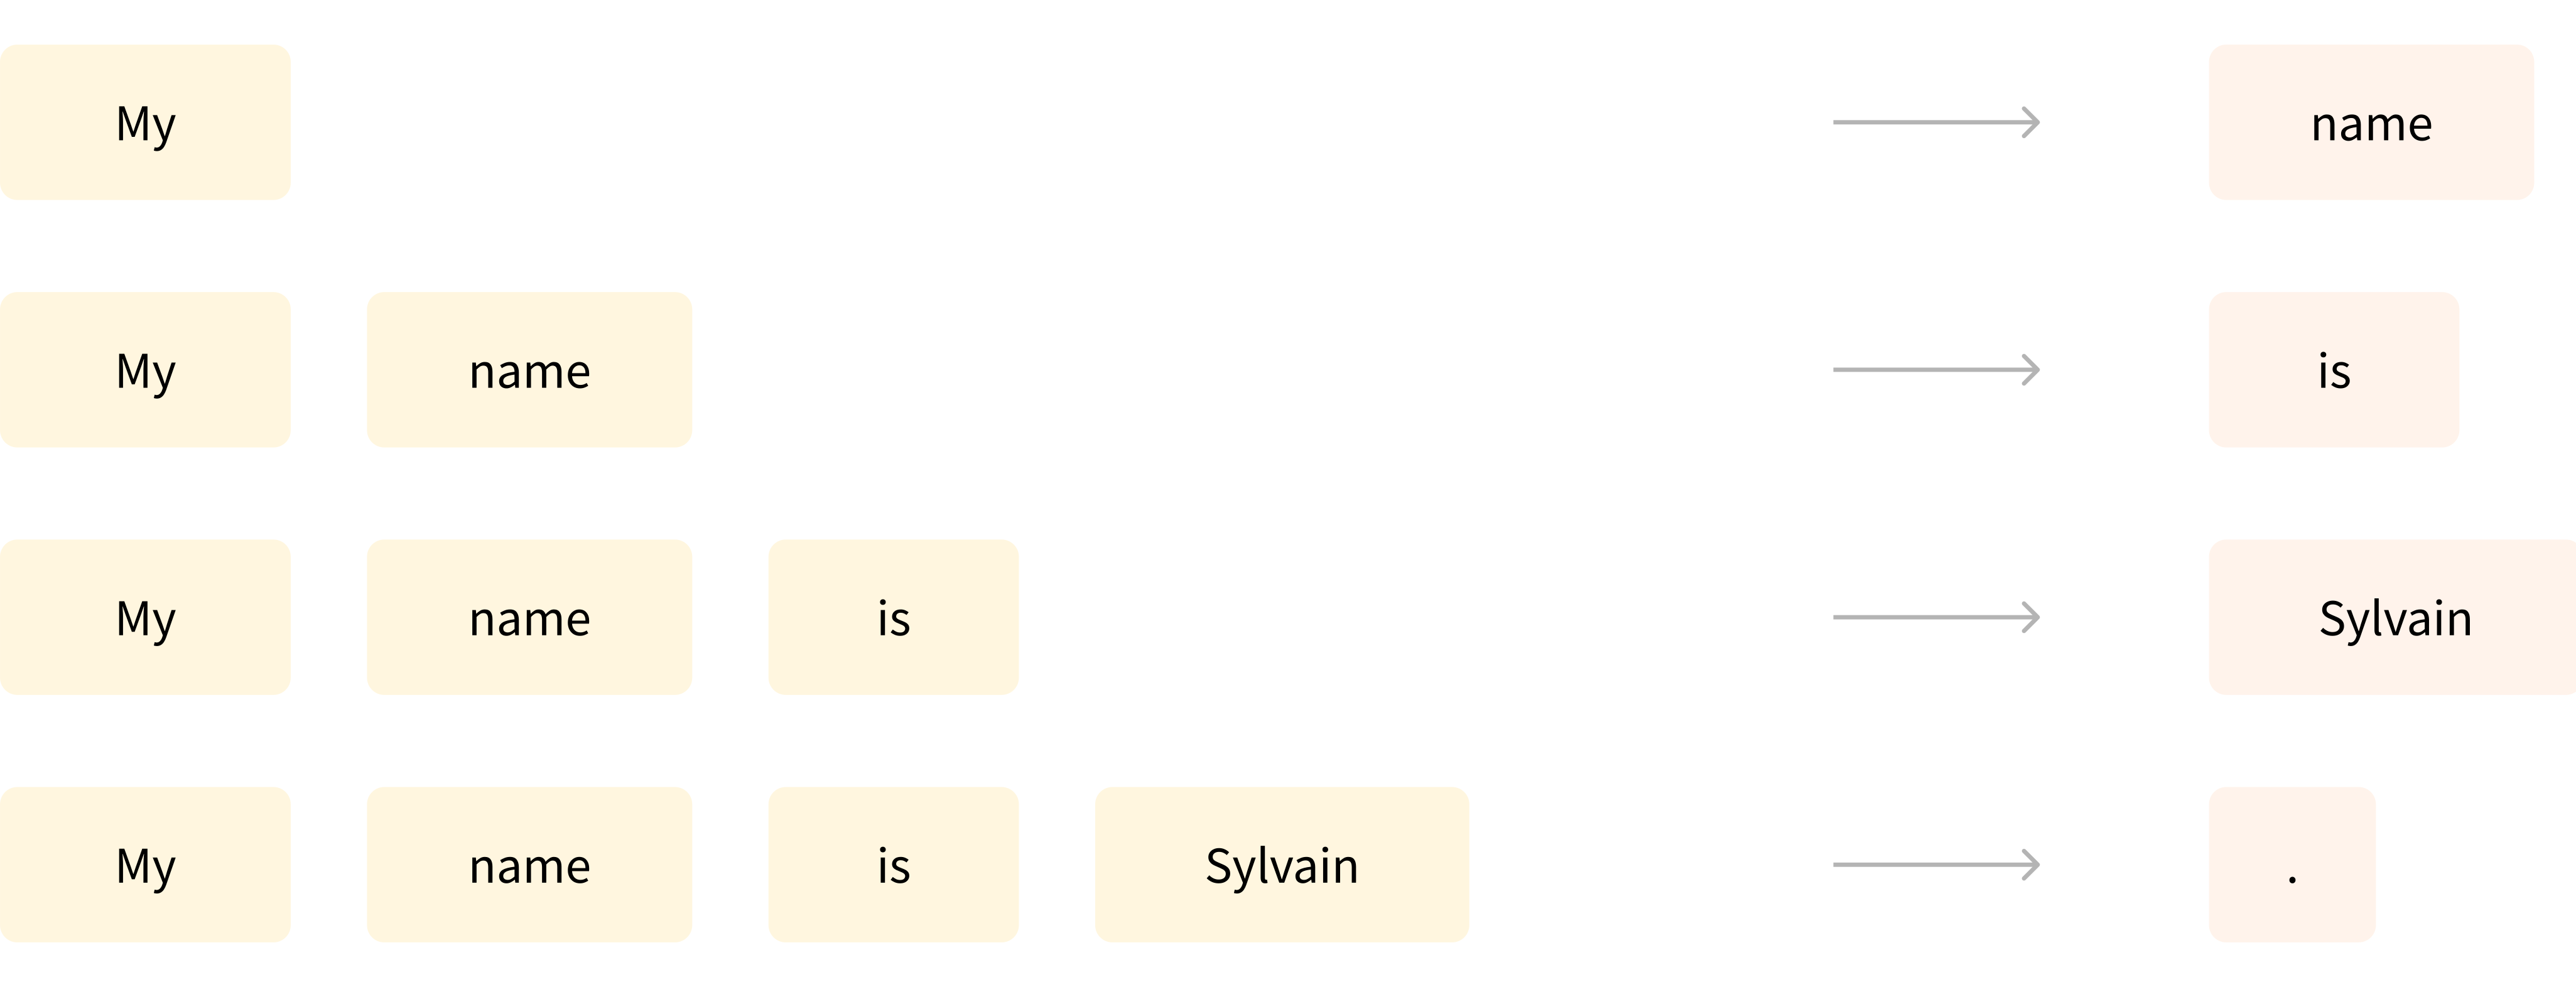
Fig. 2. 왼쪽 문맥을 바탕으로 다음 항목을 예측하는 관계.출처: Hugging Face Course contributors, How do Transformers work?의 causal language modeling 그림. 원본 이미지, 데이터셋 라이선스 Apache-2.0. SVG를 흰 배경 PNG로 변환했다.

이 반복은 모델이 종료를 나타내는 특수 토큰을 내놓거나, 설정한 생성 길이 한도나 중단 조건을 만나면 끝날 수 있다. 종료 토큰은 보통 답변의 일반 글자로 보여 주기 위한 토큰이 아니다. 최종적으로는 생성된 토큰 ID들을 다시 텍스트로 변환해 사람이 읽을 수 있는 답변을 얻는다. 구체적인 종료 조건과 토큰의 처리는 모델·서비스 설정에 따라 달라진다. Transformers 생성 설정 문서에서는 종료 토큰, 생성 토큰 수 제한, 중단 문자열을 별도로 지정한다.
5. 두 토큰이 이어질 확률은 어떻게 계산할까?
앞의 예시에서 나는 뒤에 밥을과 먹는다가 차례로 이어질 확률도 계산할 수 있다. 첫 토큰이 나올 확률 0.50에, 그 토큰까지 붙은 뒤 두 번째 토큰이 나올 확률 0.60을 곱하면 0.30이다. 두 번째 확률은 첫 토큰이 무엇이었는지에 따라 달라지므로, 서로 독립인 두 사건의 확률을 곱한 것이 아니다.
이를 기호로 쓰기 위해 입력 문맥을 C, 첫 번째로 이어질 토큰을 A, 두 번째 토큰을 B라고 하자. P는 확률을 뜻하고, 세로줄 오른쪽은 이미 주어진 조건을 나타낸다. 예를 들어 P(B | C, A)는 “문맥 C 뒤에 A가 붙어 있을 때 다음에 B가 올 확률”이다. 언어 모델의 확률 분해에 사용하는 곱셈 법칙을 두 토큰에 적용하면 다음과 같다.
여기서 C는 나는, A는 밥을, B는 먹는다다. 이 식은 모델이 부여한 두 토큰의 연속 확률을 나타낸다. 종료 토큰이 뒤따를 확률까지 계산한 것은 아니며, 실제로 누군가 밥을 먹는다는 사실의 확률도 아니다. 생성 과정에서 샘플링용 확률을 따로 조정하면 실제 선택 확률은 조정된 분포를 따라가므로, 이 계산에서는 그런 조정 없이 앞에서 정한 확률을 그대로 사용한다.
6. 그 확률은 어디에서 배울까?
다음 토큰 예측으로 사전학습할 때는 학습 텍스트의 앞부분을 입력으로 주고, 실제로 이어지는 토큰을 예측하도록 한다. 예를 들어 학습 텍스트가 나는 밥을 먹는다라면, 앞부분 나는 밥을 뒤에서 관측된 다음 조각은 먹는다다. 모델이 그 토큰에 높은 확률을 부여하도록 내부의 학습 가능한 숫자들인 가중치를 조정한다. 이 설명에서도 앞서 정한 가상 토큰 구분을 사용한다.
이때 학습 자료의 다음 토큰이 관측된 목표라는 것과 그 문장의 내용이 사실이라는 것은 별개다. 관측된 다음 토큰이 먹는다여도 나는 밥을 뒤에 올 수 있는 표현이 그것 하나라는 뜻은 아니다. 많은 문맥과 이어지는 토큰을 통해 예측 규칙을 학습하며, 처음 보는 문맥에도 확률을 계산한다. 특정 문장이 학습 자료에 몇 번 등장했는지만 찾아 반환하는 단순한 빈도표와는 다르다. 다음 토큰을 학습 목표로 삼는 원리는 Hugging Face의 사전학습 설명에서, 문장의 확률을 모델링하는 접근은 D2L의 언어 모델 장에서 확인할 수 있다.
따라서 그럴듯하게 이어지는 문장을 만들었다고 해서 사실 확인까지 끝난 것은 아니다. 유창한 답변과 올바른 답변을 구분하려면 답의 내용에 대한 근거와 검증이 추가로 필요하다. 다음 토큰 예측이라는 생성 방식만으로 모델의 추론 능력 전체를 판정할 수도 없다. 여기서 설명한 것은 텍스트를 어떤 단위로 이어 만드는지와 그 확률의 의미다.
7. 논문에서 토큰과 생성 횟수를 읽는 방법
논문에서 토큰 예산을 제한했다고 하면 먼저 무엇을 세었는지 확인해야 한다. 입력 토큰까지 포함한 전체 길이인지, 새로 생성하는 토큰의 길이인지에 따라 조건이 달라진다. 예를 들어 Transformers의 max_new_tokens는 입력 길이를 제외하고 새로 생성할 토큰 수의 상한을 뜻한다. 100토큰 제한은 100단어 제한과 다르며, 그 안에서 표현할 수 있는 텍스트의 양은 토크나이저에도 영향을 받는다. 토큰 수만 같다고 실제 실행 시간까지 같다고 볼 수도 없다.
또 하나의 답을 길게 생성하는 것과 여러 답을 따로 생성하는 것은 다른 설정이다. Self-Consistency 리뷰에서 여러 풀이를 생성한다는 것은 같은 문제에서 토큰 선택의 반복을 여러 번 수행하고 답들을 모으는 것으로 읽을 수 있다. Semantic Entropy 리뷰에서는 이렇게 생성한 답들의 의미가 얼마나 달라지는지가 중요하다. 한 단계에서 어떤 토큰의 확률이 높은지와 여러 답이 같은 뜻을 갖는지는 구분해서 읽어야 한다.
입력을 처리하는 부분과 출력을 만드는 부분의 구조가 궁금하다면 인코더-디코더 글로 이어서 볼 수 있다. 이 글에서 다룬 토큰은 그 구조에 전달되고, 그 구조에서 출력되는 텍스트의 처리 단위다.
8. 참고 자료
- Hugging Face LLM Course — Tokenizers: 토큰화 방식, 어휘, 입력 ID, 텍스트 복원.
- Hugging Face LLM Course — Behind the pipeline: 입력 ID를 벡터로 바꾸는 단계.
- Hugging Face LLM Course — How do Transformers work?: 자기회귀 방식과 다음 토큰 예측 학습.
- Dive into Deep Learning 9.3 — Language Models: 토큰열의 확률과 조건부 확률의 곱.
- Transformers — Generation strategies: 탐욕적 선택과 샘플링.
- Transformers — GenerationConfig: 생성 길이와 종료 조건.
- Hugging Face Course 이미지 데이터셋: 그림 원본과 Apache-2.0 라이선스. 그림을 변환해 사용한 파일에는 라이선스 사본을 함께 둔다.